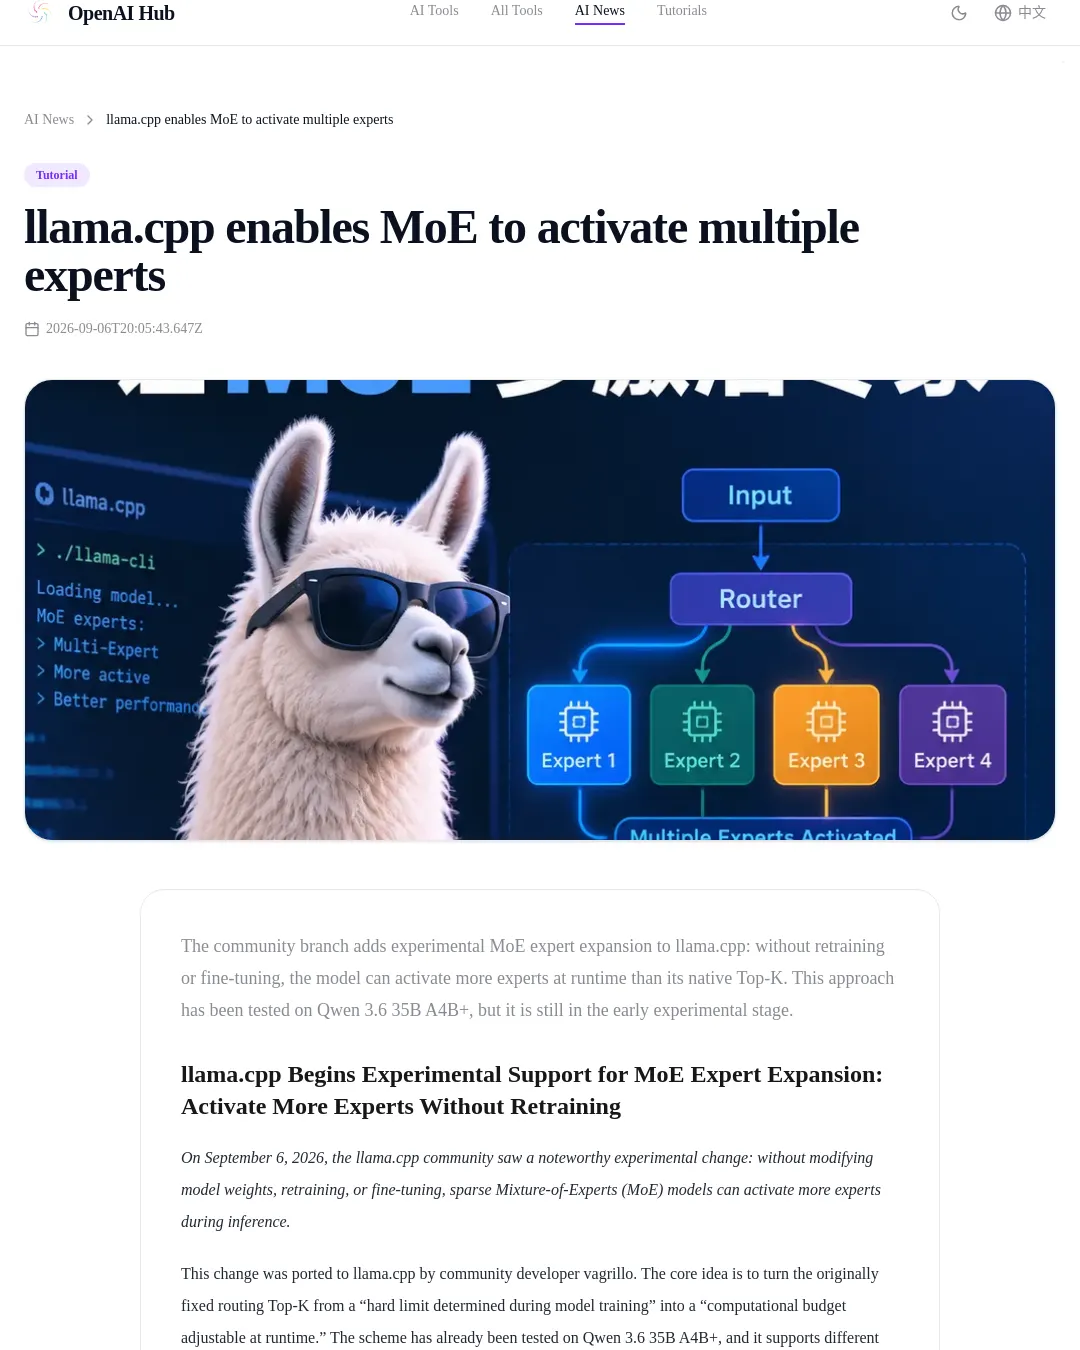
llama.cpp 커뮤니티 개발자 vagrillo가 재학습이나 미세 조정 없이 추론 중 MoE 모델의 전문가를 기본 Top-K보다 더 많이 활성화하는 실험적 변경을 이식했다. Qwen 3.6 35B A4B+에서 테스트했지만, 아직 초기 단계이며 llama.cpp 주류 버전에 안정 기능으로 포함된 것은 아니다.
이 방식은 모델 가중치를 바꾸지 않고 실행 중에 참여하는 전문가 수를 늘린다. 추가 전문가의 기여도는 라우팅 점수와 감쇠 전략으로 낮추며, 임계값을 조정하거나 계층별로 확장 범위를 다르게 설정할 수 있다. 더 많은 전문가를 계산에 포함하는 만큼 지연과 메모리 대역폭 부담이 커질 수 있다.
현재 공개된 자료에는 GSM8K, MMLU, HumanEval, 장문맥, 다국어 과제를 아우르는 체계적인 비교 결과가 없다. 따라서 정확도가 높아진다고 단정할 수는 없다. 실험 분기를 사용하려면 해당 저장소의 docs/moe-expansion.md와 명령줄 도움말에서 실제 옵션을 확인해야 하며, 주류 버전의 llama-cli와 실험 분기의 옵션을 섞어 쓰지 않는 편이 좋다.
평가할 때는 기본 설정과 전문가 확장 설정을 같은 모델·프롬프트·문맥 길이로 비교하고, 첫 토큰 지연, 생성 속도, 메모리 사용량과 출력 품질을 함께 기록해야 한다. 이 기능은 속도보다 품질을 우선하는 오프라인 추론이나 MoE 라우팅 연구에 시도해볼 수 있지만, 안정성이 중요한 실시간 서비스에 바로 적용할 근거는 아직 부족하다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요