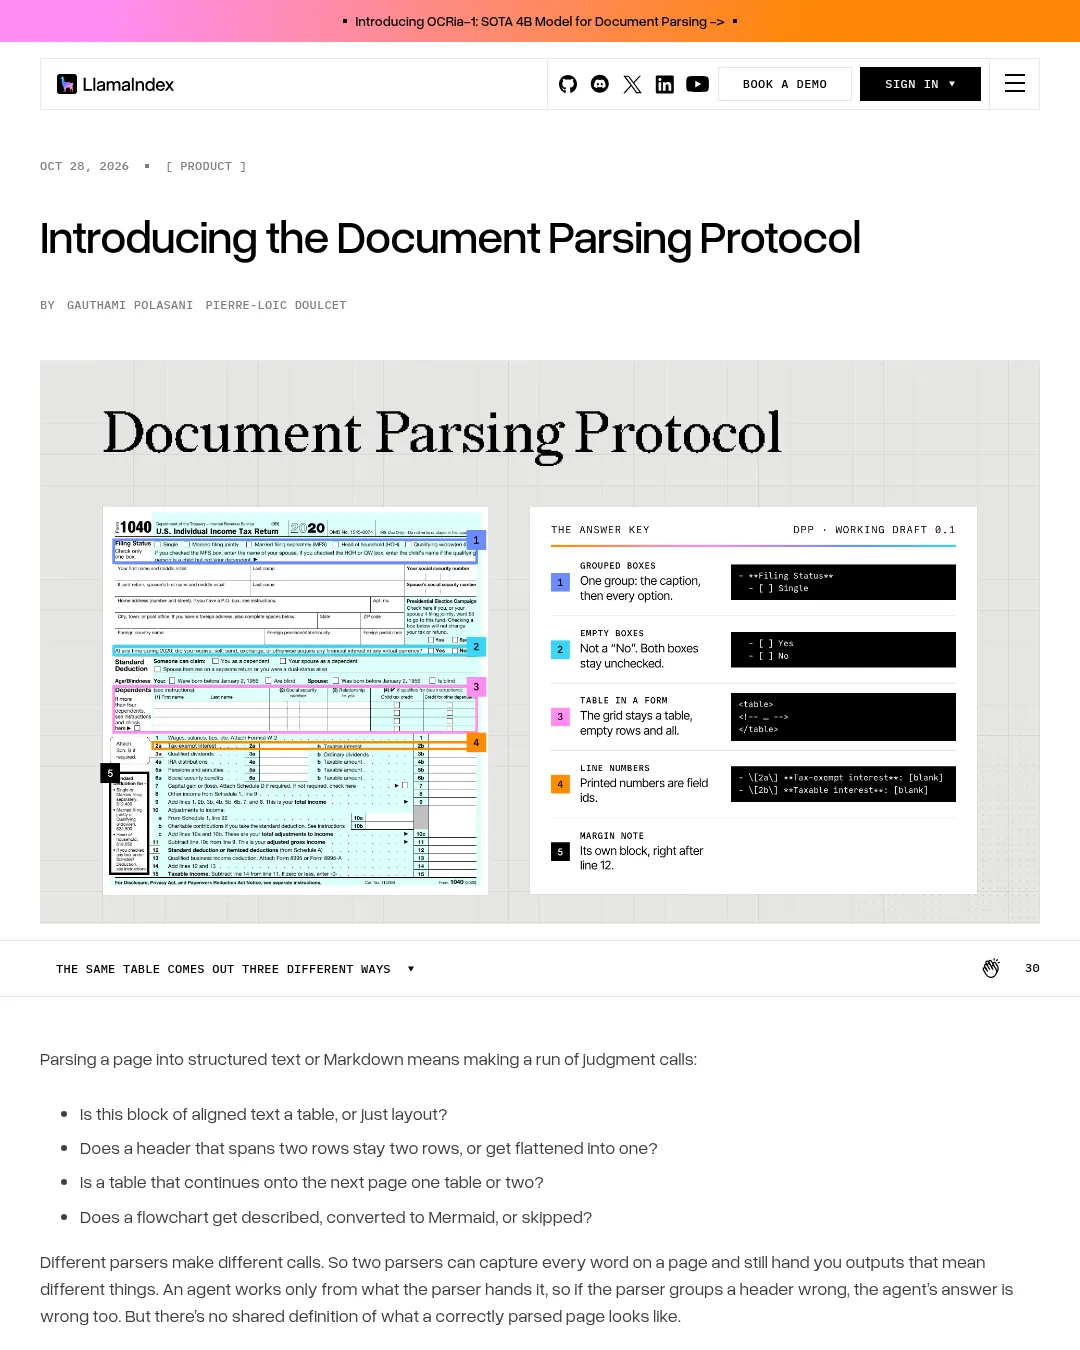
문서를 구조화된 텍스트나 마크다운으로 바꾸는 파서마다 판단이 다르면, 페이지의 단어와 숫자를 모두 추출해도 결과의 의미가 달라질 수 있다. LlamaIndex는 파서 결과를 평가하거나 데이터를 라벨링하는 팀이 공통 기준으로 삼을 수 있도록 문서 파싱 규칙 140개를 담은 Document Parsing Protocol(DPP) 작업 초안 0.1을 공개했다.
페이지를 파싱(parsing)할 때는 정렬된 텍스트가 표인지 단순한 배치인지, 두 줄에 걸친 머리글을 그대로 둘지 한 줄로 합칠지, 다음 페이지까지 이어지는 표를 하나로 볼지 나눌지 등을 판단해야 한다. 파서가 머리글 구조를 잘못 묶으면 그 결과를 바탕으로 답하는 에이전트도 틀릴 수 있다. LlamaIndex는 현재 올바른 페이지 파싱 결과를 정의하는 공통 기준이 없다고 설명한다.
DPP는 텍스트, 표, 양식, 차트, 다이어그램 등을 다루며, 각 규칙에 예시 페이지와 기대 출력값을 담았다. 규칙은 문서 파싱 벤치마크인 ParseBench의 페이지에 주석을 달 때 사용한 기준에서 발전했다.
두 줄짜리 머리글이 있는 판매 표를 예로 들면, 연도가 표 위쪽에서 여러 열에 걸쳐 있고 그 아래에 분기가 놓인다. 2023년에는 연간 전체 열도 있다. 파서 세 종류가 이 표의 첫 데이터 행까지 마크다운으로 변환했을 때, 한 파서는 분기 머리글을 본문으로 밀어 넣어 4.1% 열의 연도를 표시하지 않았다. 다른 파서는 연도를 빼서 ‘Q2’가 3.8%와 4.1% 두 열을 가리키게 했다. 세 번째 파서는 올바른 값을 얻었지만 원문에 없는 ‘2024 Q2’라는 머리글을 만들어 넣었다. LlamaIndex는 세 출력 모두 DPP 기준에서 잘못된 것으로 본다.
DPP는 페이지에 인쇄된 두 머리글 행을 그대로 보존한다. 마크다운 표로는 여러 열을 아우르는 머리글을 표현할 수 없어 HTML 표를 사용한다. 다음은 같은 표에 대한 DPP 출력이다.
<table> <tr> <th></th> <th colspan="5">2023</th> <th colspan="3">2024</th> </tr> <tr> <th><em>Fiscal year ending December,</em></th> <th>Q1</th> <th>Q2</th> <th>Q3</th> <th>Q4</th> <th>FY</th> <th>Q1</th> <th>Q2</th> <th>Q3</th> </tr> <tr> <td data-level="0"><strong>Systemwide Same Shop Sales</strong></td> <td><strong>(2.0)%</strong></td> <td><strong>3.8 %</strong></td> <td><strong>4.0 %</strong></td> <td><strong>5.0 %</strong></td> <td><strong>2.8 %</strong></td> <td><strong>10.0 %</strong></td> <td><strong>4.1 %</strong></td> <td><strong>2.7 %</strong></td> </tr> <tr> <td data-level="1">Ticket</td> <td>6.3 %</td> <td>6.4 %</td> <td>9.5 %</td> <td>5.4 %</td> <td>7.2 %</td> <td>8.8 %</td> <td>6.1 %</td> <td>1.9 %</td> </tr> <!-- … --> </table>
이 출력에서는 4.1%가 페이지와 마찬가지로 2024년 머리글 아래 Q2에 놓인다.
표 외의 요소도 규칙으로 다룬다. 양식의 빈칸은 누락된 것이 아니라 비어 있음을 표시하도록 [blank]로, 체크박스는 [x]와 [ ]로 나타낸다. 차트는 범주별 행과 계열별 열로 구성된 숫자 표로 바꾸며, 인쇄된 값은 그대로 옮긴다. 다이어그램은 모든 레이블과 화살표를 담을 수 있으면 Mermaid 같은 다이어그램 코드로 변환한다. 적합한 형식이 없으면 그림을 설명하고 레이블을 모두 보존한다. PDF 안에 있지만 페이지에 표시되지 않는 텍스트는 제외하고, 보이지만 읽을 수 없는 텍스트는 [illegible]로 표시한다. 요청하면 페이지에서 각 요소의 위치도 기록해 값을 원문과 대조할 수 있다.
LlamaIndex는 표의 행을 <thead>와 <tbody>로 감싸는 방식처럼 같은 정보를 보존하는 차이는 허용된다고 설명한다. 문서 전체에서 한 가지 형식을 일관되게 사용한다면 두 방식 모두 기준에 부합하며, 검토 과정에서도 어느 쪽이든 받아들여야 한다는 것이다. DPP를 공개한 목적은 각 팀이 같은 출력물을 서로 다르게 평가하는 문제를 줄이고, 공통 규칙을 공개적으로 논의하는 데 있다고 밝혔다.
DPP를 직접 시험하는 방법
DPP는 parseprotocol.com에서 이용할 수 있다. 사이트에는 원본 페이지와 기대 출력이 나란히 제시된다. 페이지 이미지를 첨부하고 사이트에서 제공하는 프롬프트를 입력해 시험할 수 있다. 클로드(Claude)를 사용할 때는 스킬을 내려받아 Customize → Skills에 올려야 하며, 스킬에는 코드 실행이 필요하다. ChatGPT에서는 참조 파일을 대화에 추가하면 된다.
시험할 페이지가 없다면 사이트의 Apple 예시 페이지를 사용할 수 있다. 두 셀에 인쇄된 6,485가 각각 결과에 남는지, (565)의 괄호가 보존되는지 확인한 뒤 해설에서 해당 페이지의 파싱 판단 여덟 가지를 살펴볼 수 있다.
DPP 0.1은 작업 초안이다. LlamaIndex는 규칙이 문서에서 제대로 작동하지 않거나 서로 다른 규칙이 상충하는 경우, 해당 페이지와 기대 출력을 첨부해 GitHub에 이슈를 열거나 풀 리퀘스트를 제출해 달라고 요청했다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요