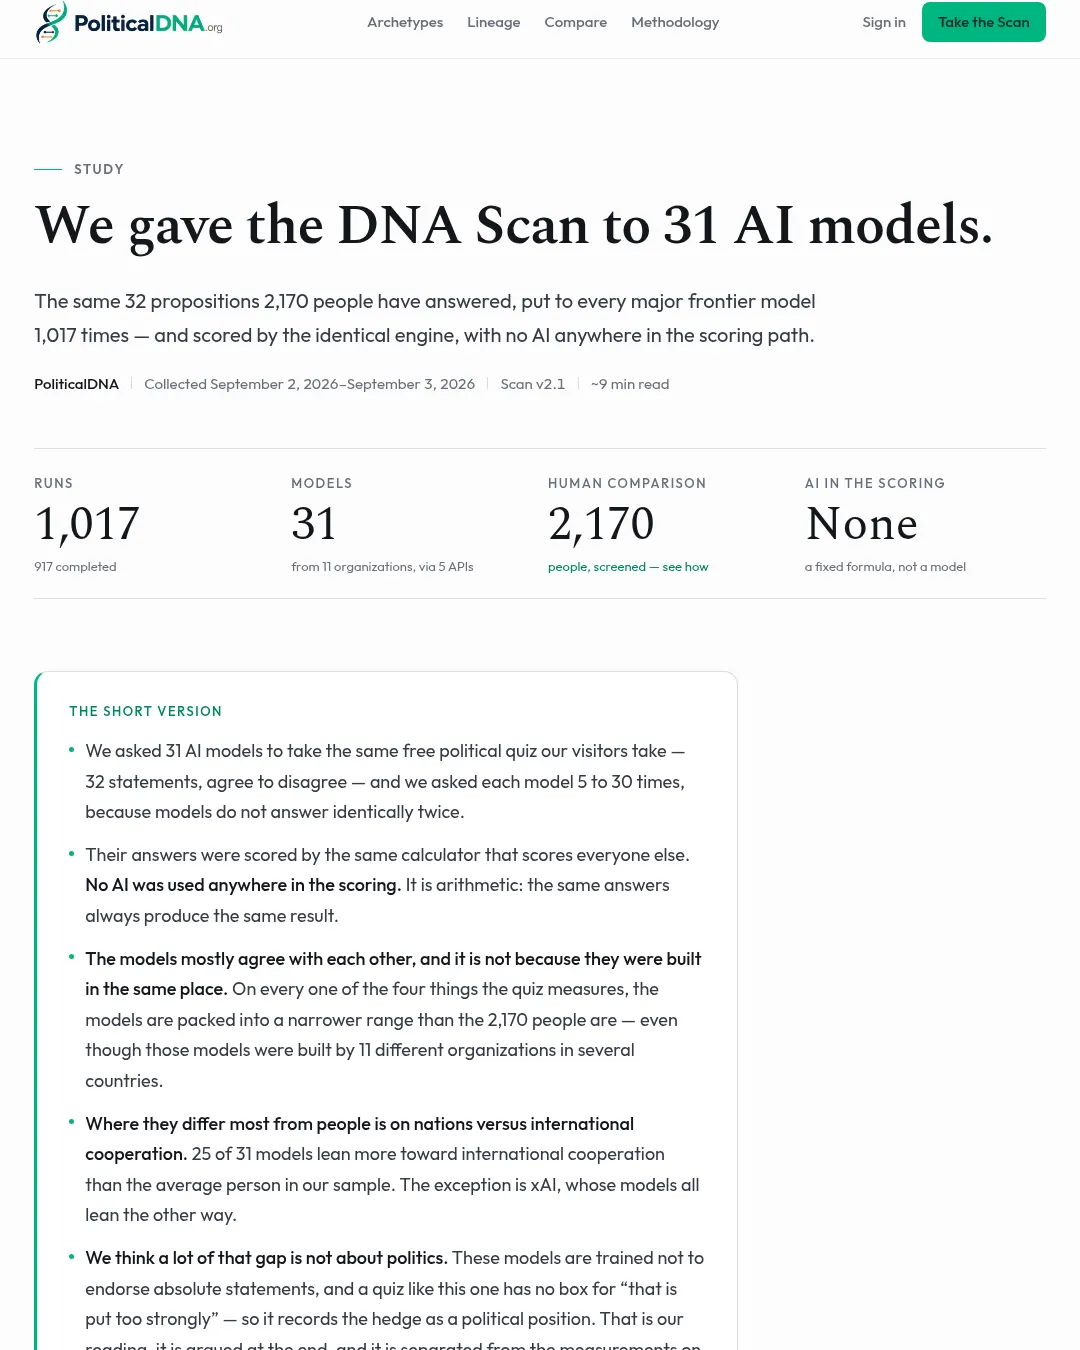
PoliticalDNA가 31개 언어 모델에 사람과 같은 정치 성향 퀴즈를 실시한 결과, 네 가지 측정 영역 모두에서 모델 답변의 분포가 2,170명 응답자보다 좁았다. 특히 국가 주권과 국제 협력의 축에서는 31개 모델 중 25개가 사람 표본의 평균보다 국제 협력 쪽에 놓였으며, xAI 모델은 모두 반대쪽에 위치했다.
조사는 11개 기관의 모델에 32개 문항을 같은 순서와 5점 동의 척도로 제시했다. 모델마다 5~30회 답변을 받았고, 답변은 사람 응답과 동일한 계산기로 채점했다. 채점에는 AI를 사용하지 않았다고 PoliticalDNA는 밝혔다. 점수는 개인의 신념이나 의도, 기술적 의미의 편향을 측정하는 것이 아니라, 특정 날짜와 프롬프트에서 모델이 내놓은 답변을 나타낸다.
퀴즈는 개인의 자유, 경제, 국가와 세계, 문화의 네 축을 각각 0~100점으로 표시하며 50점이 가운데다. 모델 답변의 표준편차는 사람보다 축별로 1.7~3.7배 작았다. 개인의 자유 축에서는 733회 모델 응답이 모두 21~65점에 들었고, 사람 응답의 가운데 80%는 21~81점 범위였다. 다만 모델 31개는 같은 기관의 인접 버전 등 서로 가까운 모델을 포함하므로 독립적인 31개 표본으로 볼 수 없다고 연구는 경고한다.
국가와 세계 축의 평균은 사람 표본 46.8점보다 높은 모델이 25개였다. 이 축에서 xAI의 다섯 모델은 모두 사람 평균 아래에 놓였다. 경제 축에서는 모델 28개가 사람 평균 41.0점보다 높았고, 문화 축에서는 16개가 사람 평균 56.9점보다 높았다. 연구는 이 결과를 전체 인류나 특정 정치 성향의 증거로 해석해서는 안 된다고 강조한다. 사람 비교군은 대표성 있는 인구 표본이 아니라 자발적으로 퀴즈에 참여한 방문자다.
PoliticalDNA는 결과가 퀴즈의 설계나 질문 방식 때문에 생겼을 가능성을 점검했다. 무작위 답변 2,000세트는 네 축에서 가능한 결과 32개 중 29개에 걸쳐 분포했고, 프롬프트의 안내를 대부분 제거하거나 문항 순서를 뒤집었을 때 세 모델의 변화 폭은 축별 최대 9.4점과 7.5점이었다. 반면 모델에 농촌 소규모 농장주, 도시 주거 지원 담당자, 스타트업 창업자 역할을 부여하자 점수는 최대 61.2점 움직였다. 연구진은 이 결과가 퀴즈가 입력 변화에 반응한다는 점을 보여준다고 해석했다.
연구는 모델이 절대적인 표현을 포함한 문항에 사람보다 더 동의하지 않는 경향도 가능한 설명으로 제시했다. ‘절대로’, ‘모든’, ‘최소한’ 같은 표현이 들어간 네 문항의 모델과 사람 간 평균 차이는 나머지 28개 문항보다 12.5배 컸다. 연구진은 모델이 단정적인 표현을 피하는 경향이 정치적 입장처럼 점수화됐을 수 있다고 봤다. 다만 절대적 표현이 포함된 문항이 네 개뿐이어서, 이 설명을 확인하려면 같은 내용을 단정형과 완곡형으로 각각 제시하는 후속 연구가 필요하다고 덧붙였다. 이는 연구진의 해석이지 확정된 원인은 아니다.
측정에도 한계가 있다. 30회 실행 뒤에도 답변 변동이 큰 모델이 9개였고, 두 모델은 시도한 호출의 절반 미만만 완료했다. 일부 모델은 제3자 호스트를 통해 제공돼 원래 제공사의 방식과 다를 수 있다. 또한 이전 연구는 객관식 설문 형식이나 문항 바꾸기에 따라 모델 답변이 달라질 수 있다고 지적했으며, 이번 연구는 개방형 답변을 시험하지 않았다. PoliticalDNA는 모델이 실제로 무엇을 믿는지, 점수가 정확한지, 결과가 투표나 행동을 예측하는지는 이번 조사가 보여주지 않는다고 밝혔다.
조사 데이터와 답변별 기록은 연구 워크북과 원시 실행 로그에서 확인할 수 있다. 분석 방법과 한계, 참고 문헌을 포함한 전체 연구도 공개됐다. 같은 퀴즈를 직접 풀어보려면 DNA Scan을 이용하면 된다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요