TL;DR
- 대형 언어 모델(LLM)의 궤적 확률은 초기 상태 분포, 정책의 행동 확률, 환경의 상태 전이 확률을 연쇄법칙으로 분해한 결과이며, 토큰 생성에서는 환경 전이 확률이 1이 됨.
- 궤적 확률은 정책 매개변수 θ에 대한 초기 상태·행동·상태의 결합확률을 연쇄법칙으로 분해하는 방식임.
- 초기 상태 분포와 환경 전이 규칙이 정책 매개변수 θ에 의존하지 않는다는 가정이 적용됨.
- 현재 상태가 과거 정보를 충분히 포함한다는 마르코프 가정에 따라 정책과 환경의 조건부 확률이 현재 상태와 행동만으로 표현됨.
- 언어 모델에서는 프롬프트가 초기 상태이고 각 상태가 생성 토큰을 덧붙인 결과이므로, 주어진 프롬프트에서 생성 토큰의 확률이 정책 확률의 곱으로 정리됨.
연쇄법칙에서 시작하기
- REINFORCE 글에서는 곧바로 그래디언트로 들어갔지만, 여기서는 첫 원리에서 궤적의 확률을 인수분해하는 데서 시작함.
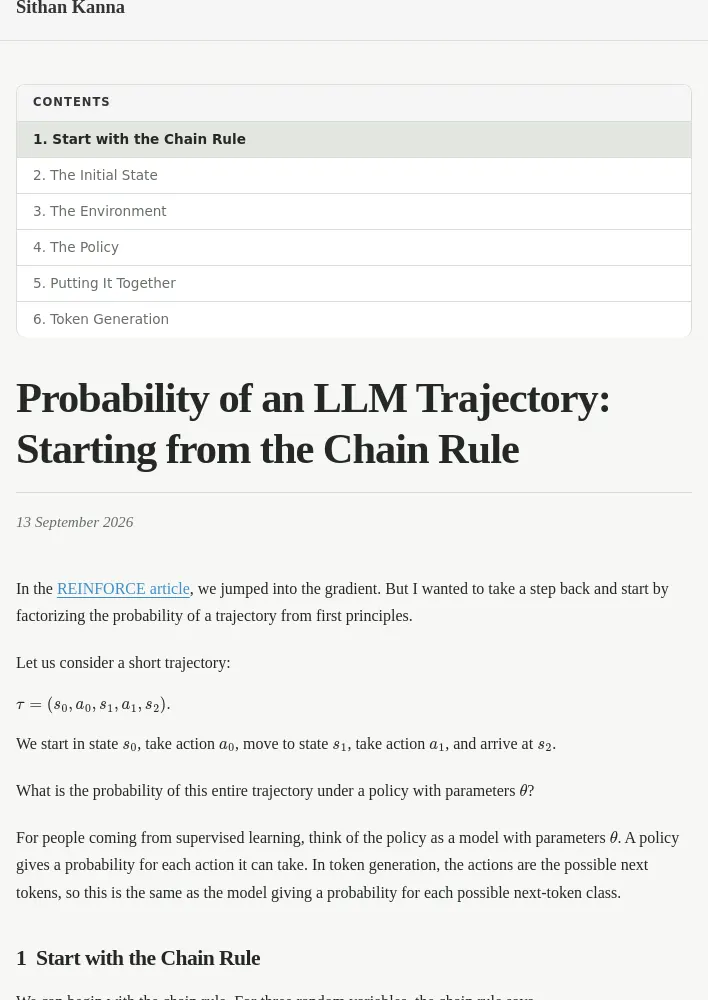
- 다음과 같은 짧은 궤적을 고려함.
τ=(s₀,a₀,s₁,a₁,s₂)- 상태
s₀에서 시작해 행동a₀을 취하고 상태s₁으로 이동한 뒤, 행동a₁을 취해 상태s₂에 도달하는 과정임. - 매개변수
θ를 갖는 정책에서 이 전체 궤적의 확률을 구하는 것이 목표임. - 지도 학습 관점에서는 정책을 매개변수
θ를 갖는 모델로 볼 수 있음. - 정책은 선택 가능한 각 행동에 확률을 부여함.
- 토큰 생성에서는 행동이 가능한 다음 토큰이므로, 모델이 가능한 각 다음 토큰 클래스에 확률을 부여하는 것과 같음.
- 세 확률변수에 대한 연쇄법칙은
p(x,y,z)=p(x)p(y|x)p(z|x,y)임. - 이를 궤적에 적용하면 다음과 같음.
p(τ|θ)=p(s₀,a₀,s₁,a₁,s₂|θ)=p(s₀|θ) × p(a₀|s₀,θ) × p(s₁|s₀,a₀,θ) × p(a₁|s₀,a₀,s₁,θ) × p(s₂|s₀,a₀,s₁,a₁,θ)- 이 단계에서는 연쇄법칙만 사용했으며, 정책이나 환경에 대한 가정은 아직 적용하지 않음.
초기 상태
- 정책, 즉 모델은 초기 상태를 선택하지 않음.
- 초기 상태는 초기 상태 분포에서 샘플링되며, 이 분포가 정책 매개변수에 의존하지 않는다고 가정함.
p(s₀|θ)=p(s₀)- 언어 모델에서
s₀은 생성이 시작되기 전에 모델에 주어지는 초기 프롬프트임.
환경
- 정책이 행동을 선택한 뒤 다음 상태를 생성하는 주체는 환경임.
- 환경이
θ로 매개변수화되지 않는다고 가정하므로 다음이 성립함. p(s₁|s₀,a₀,θ)=p(s₁|s₀,a₀)p(s₂|s₀,a₀,s₁,a₁,θ)=p(s₂|s₀,a₀,s₁,a₁)- 이는 정책이 방문하는 상태에 영향을 주지 않는다는 뜻이 아님.
- 정책이 행동을 선택하고, 그 행동이 다음 상태에 영향을 줌.
- 상태와 행동이 주어지면 환경이
θ의 모든 값에 대해 동일한 전이 규칙을 사용한다는 뜻임. - 이제 마르코프 가정을 적용함.
- 현재 상태와 행동이 주어지면 환경은 다음 상태를 생성할 때 이전 상태와 행동을 필요로 하지 않음.
- 예시에서는
p(s₂|s₀,a₀,s₁,a₁)=p(s₂|s₁,a₁)임. - 임의의 시점
t에서는p(s_{t+1}|s₀,a₀,…,s_t,a_t)=p(s_{t+1}|s_t,a_t)임. - 이 등식이 성립하려면 상태
s_t가 다음 상태의 분포를 결정하는 데 필요한 과거 정보를 포함해야 함.
정책
- 행동은 정책이 생성함.
- 행동 확률을
p(a_t|s_t,θ)로 쓰는 대신 정책을 구분하기 위해 다음 표기법을 정의함. p(a_t|s_t,θ) ≜ π_θ(a_t|s_t)- 이는 표기법일 뿐이지만, 정책이 생성하는 확률과 환경이 생성하는 확률을 구분하는 데 도움이 됨.
- 정책에도 마르코프 가정을 적용함.
- 현재 상태가 관련된 이력을 포함한다면
p(a_t|s₀,a₀,…,s_t,θ)=p(a_t|s_t,θ)=π_θ(a_t|s_t)임. - 궤적에 포함된 두 행동에는 다음이 적용됨.
p(a₀|s₀,θ)=π_θ(a₀|s₀)p(a₁|s₀,a₀,s₁,θ)=π_θ(a₁|s₁)
종합
- 이러한 가정을 연쇄법칙의 인수분해에 대입하면 다음과 같음.
p(τ|θ)=p(s₀) π_θ(a₀|s₀) p(s₁|s₀,a₀) × π_θ(a₁|s₁) p(s₂|s₁,a₁)- 각 시점에 정책이 행동을 선택하고 환경이 다음 상태를 생성함.
- 따라서 시점
t가 기여하는 확률은π_θ(a_t|s_t) p(s_{t+1}|s_t,a_t)임. - T개 행동을 갖는 궤적은
s₀에서 시작해s_T에서 끝남. τ=(s₀,a₀,s₁,a₁,…,s_{T−1},a_{T−1},s_T)- 그 확률은 다음과 같음.
p(τ|θ)=p(s₀) ∏_{t=0}^{T−1} π_θ(a_t|s_t) p(s_{t+1}|s_t,a_t)
토큰 생성
- 이제 이 인수분해를 언어 모델에 적용함.
- 초기 프롬프트가
x_{1:n}=(x₁,…,x_n)이라고 하면 초기 상태는 다음과 같음. s₀=(x₁,…,x_n)- 첫 행동
a₀은 모델에서 샘플링되는 첫 토큰임. - 토큰이 생성되면 프롬프트에 덧붙이며, 다음 상태는
s₁=(x₁,…,x_n,a₀)가 됨. - 모델이
a₁을 생성한 뒤에는s₂=(x₁,…,x_n,a₀,a₁)가 됨. - 시점
t의 상태는s_t=(x₁,…,x_n,a₀,…,a_{t−1})이며, 다음 상태는 선택된 토큰을 덧붙여s_{t+1}=append(s_t,a_t)로 얻음. s_t와a_t가 알려지면 가능한s_{t+1}의 값은 하나뿐임.- 정의상
s_{t+1}=(s_t,a_t)임. - 따라서 전이 확률은
p(s_{t+1}|s_t,a_t)=p(s_{t+1}|s_{t+1})=1임. - 유효한 토큰 궤적에서는 모든 환경 전이 항이 1임.
- 짧은 예시의 궤적 확률은
p(τ|θ)=p(s₀) π_θ(a₀|s₀) π_θ(a₁|s₁)가 됨. - T개 토큰이 생성되는 경우에는
p(τ|θ)=p(s₀) ∏_{t=0}^{T−1} π_θ(a_t|s_t)가 됨. - 일반적으로 프롬프트는 이미 주어져 있으므로
s₀에 조건을 걸고 생성 토큰의 확률만 고려함. p(a₀,…,a_{T−1}|s₀,θ)=∏_{t=0}^{T−1} π_θ(a_t|s_t)- 각 상태의 내용을 풀어 쓰면 다음과 같음.
p(a₀,…,a_{T−1}|x_{1:n},θ)=∏_{t=0}^{T−1} π_θ(a_t|x_{1:n},a₀,…,a_{t−1})- 이 식이 REINFORCE 글에서 사용한 궤적 확률임.
- 해당 글에서는 정책 그래디언트를 도출했으며, 여기서는 인수분해 자체와 토큰 생성에서 환경 항이 1이 되는 이유를 도출함.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요