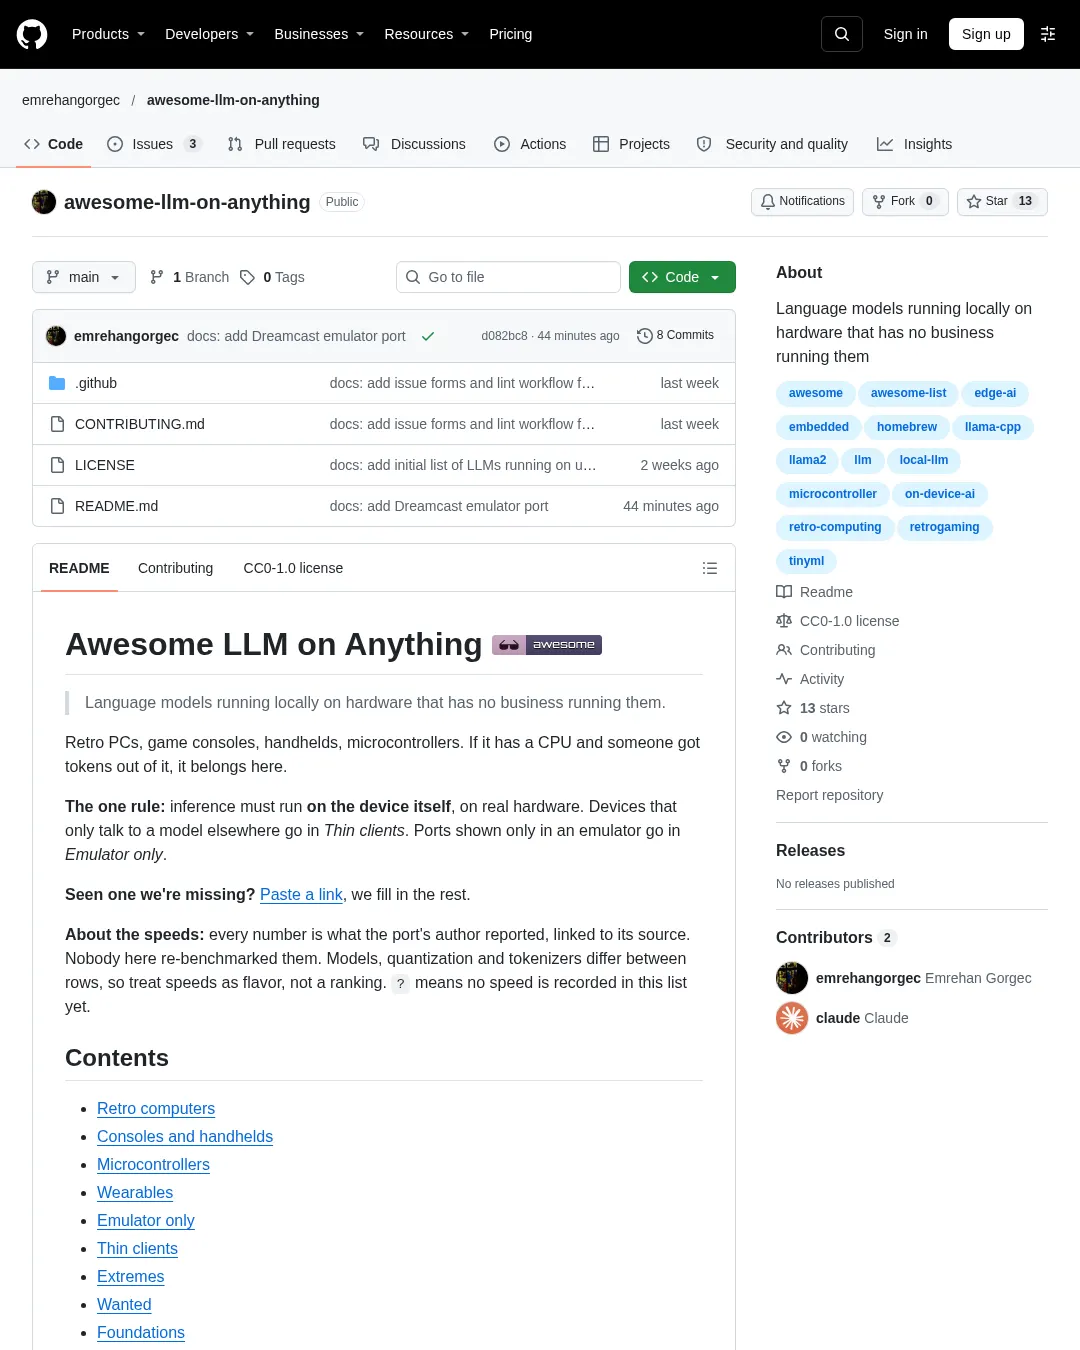
오래된 PC와 게임기, 휴대용 기기, 마이크로컨트롤러에서 언어 모델을 기기 자체로 실행한 사례를 모은 목록이 공개됐다. 각 항목은 기기와 모델, 보고된 속도, 관련 프로젝트를 연결하며, 속도는 제작자가 보고한 수치일 뿐 목록에서 다시 측정하거나 서로 비교한 결과는 아니다.
목록은 추론이 실제 하드웨어에서 기기 자체로 실행돼야 한다는 기준을 둔다. 원격 모델과 통신만 하는 기기는 ‘씬 클라이언트’, 에뮬레이터에서만 실행이 확인된 포트는 별도 항목으로 분류한다. 속도는 모델·양자화 방식·토크나이저가 항목마다 달라 순위가 아니며, ?는 아직 기록된 속도가 없다는 뜻이다.
기록된 사례에는 486 DX2 66MHz와 32MB RAM을 갖춘 DOS PC의 dosllam2가 초당 2.08토큰을 처리했다는 보고가 있다. Nintendo Wii에서는 GPU 엔진 기준 초당 61.9토큰, CPU 기준 초당 12.7토큰이 보고됐다. Xbox Series S의 xllama는 CPU 생성 속도가 초당 101.6토큰으로, 3회 측정의 중앙값이다. 목록에서 가장 느린 사례로 꼽힌 Commodore 64는 약 8분에 토큰 하나를 생성하며, 첫 단어가 보이기까지 약 16분이 걸린다고 기록됐다.
이 수치들은 각 프로젝트가 보고한 값이며 독립적으로 재측정되지 않았다. Nintendo 64 사례는 실제 기기 실행을 보고했지만 연결된 저장소를 현재 이용할 수 없고, 제작자가 이전 속도 주장을 철회해 속도가 기재되지 않았다. New Nintendo 3DS에서는 추론이 휴대용 기기에서 실행되고 Wi-Fi는 생성 결과를 노트북으로 전달하는 데만 쓰인다. Xbox 측정은 Series S에 한정되며 Series X는 시험되지 않았다.
이 밖에 ESP32 보드와 Raspberry Pi Pico, Google Pixel Watch 3 사례가 포함됐다. 반면 Game Boy·Game Boy Advance, 전자잉크 Kindle, 계산기 자체에서 추론하는 그래프 계산기는 아직 문서화된 사례를 찾지 못한 항목으로 제시됐다. 목록은 관련 프로젝트와 속도 측정 자료를 연결하며, 새 사례나 정정 사항도 제출할 수 있다.
Awesome LLM on Anything 저장소 · llama2.c · llama.cpp · Can It Run AI?
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요