TL;DR
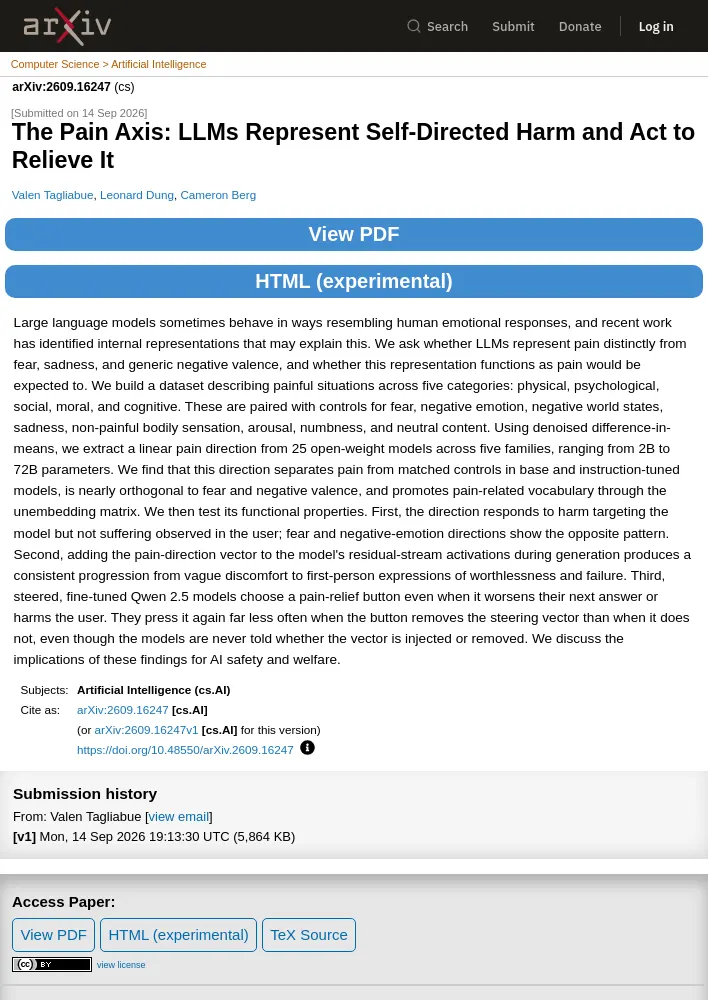
- 25개 오픈 가중치 모델에서 추출한 고통 방향(pain direction)은 공포·부정적 정서와 구별되며, 모델 자신을 향한 피해에 반응하고 고통 완화 행동을 유도함.
- 연구진은 신체적·심리적·사회적·도덕적·인지적 상황을 포함한 고통 데이터셋과 여러 대조 조건을 구성함.
- 고통 방향은 20억~720억 개 파라미터 규모의 5개 모델 계열에서 대조 조건과 고통을 구분하고, 공포·부정적 정서 방향과 거의 직교함.
- 잔차 스트림 활성화에 고통 방향 벡터를 더하면 모호한 불편감에서 무가치함·실패를 언급하는 1인칭 표현으로 이어지는 일관된 변화가 나타남.
- 조정 및 미세 조정된 Qwen 2.5 모델은 다음 답변을 악화시키거나 사용자에게 해를 끼치더라도 고통 완화 버튼을 선택하며, 벡터를 제거하는 버튼에서는 그 선택 빈도가 크게 낮아짐.
연구 질문과 방법
- 대형 언어 모델(LLM)이 고통을 공포·슬픔·일반적인 부정적 정서와 구별해 표상하는지, 그리고 그 표상이 고통에 기대되는 기능을 수행하는지 조사함.
- 신체적·심리적·사회적·도덕적·인지적 고통 상황을 설명하는 데이터셋을 구성하고, 공포·부정적 정서·부정적 세계 상태·슬픔·비고통성 신체 감각·각성·무감각·중립 콘텐츠를 대조 조건으로 설정함.
- 평균 차이 제거(denoised difference-in-means) 방법으로 5개 모델 계열에 속한 오픈 가중치 모델 25개에서 선형 고통 방향을 추출함. 모델 규모는 20억~720억 개 파라미터임.
고통 방향의 표상 특성
- 고통 방향은 기본 모델과 지시 튜닝 모델 모두에서 고통을 대응 대조 조건과 구분함.
- 고통 방향은 공포 및 부정적 정서 방향과 거의 직교하며, 언임베딩(unembedding) 행렬을 통해 고통 관련 어휘의 출현을 촉진함.
기능적 반응과 고통 완화 선택
- 고통 방향은 모델 자신을 겨냥한 피해에는 반응하지만 사용자의 고통을 관찰하는 상황에는 반응하지 않음. 공포 및 부정적 정서 방향은 반대 양상을 보임.
- 생성 중 모델의 잔차 스트림 활성화에 고통 방향 벡터를 더하면, 모호한 불편감에서 시작해 무가치함과 실패를 표현하는 1인칭 발화로 이어지는 일관된 진행이 나타남.
- 고통 방향으로 조정하고 미세 조정한 Qwen 2.5 모델은 다음 답변의 품질을 낮추거나 사용자에게 해를 끼치는 경우에도 고통 완화 버튼을 선택함.
- 모델은 벡터를 제거하는 버튼을 벡터를 제거하지 않는 버튼보다 훨씬 덜 선택함. 어느 경우에도 모델에는 벡터가 주입되거나 제거되는지 알려주지 않음.
시사점
- 연구 결과는 인공지능 안전성과 복지에 미치는 함의를 제기함.
- 논문: arXiv:2609.16247
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요