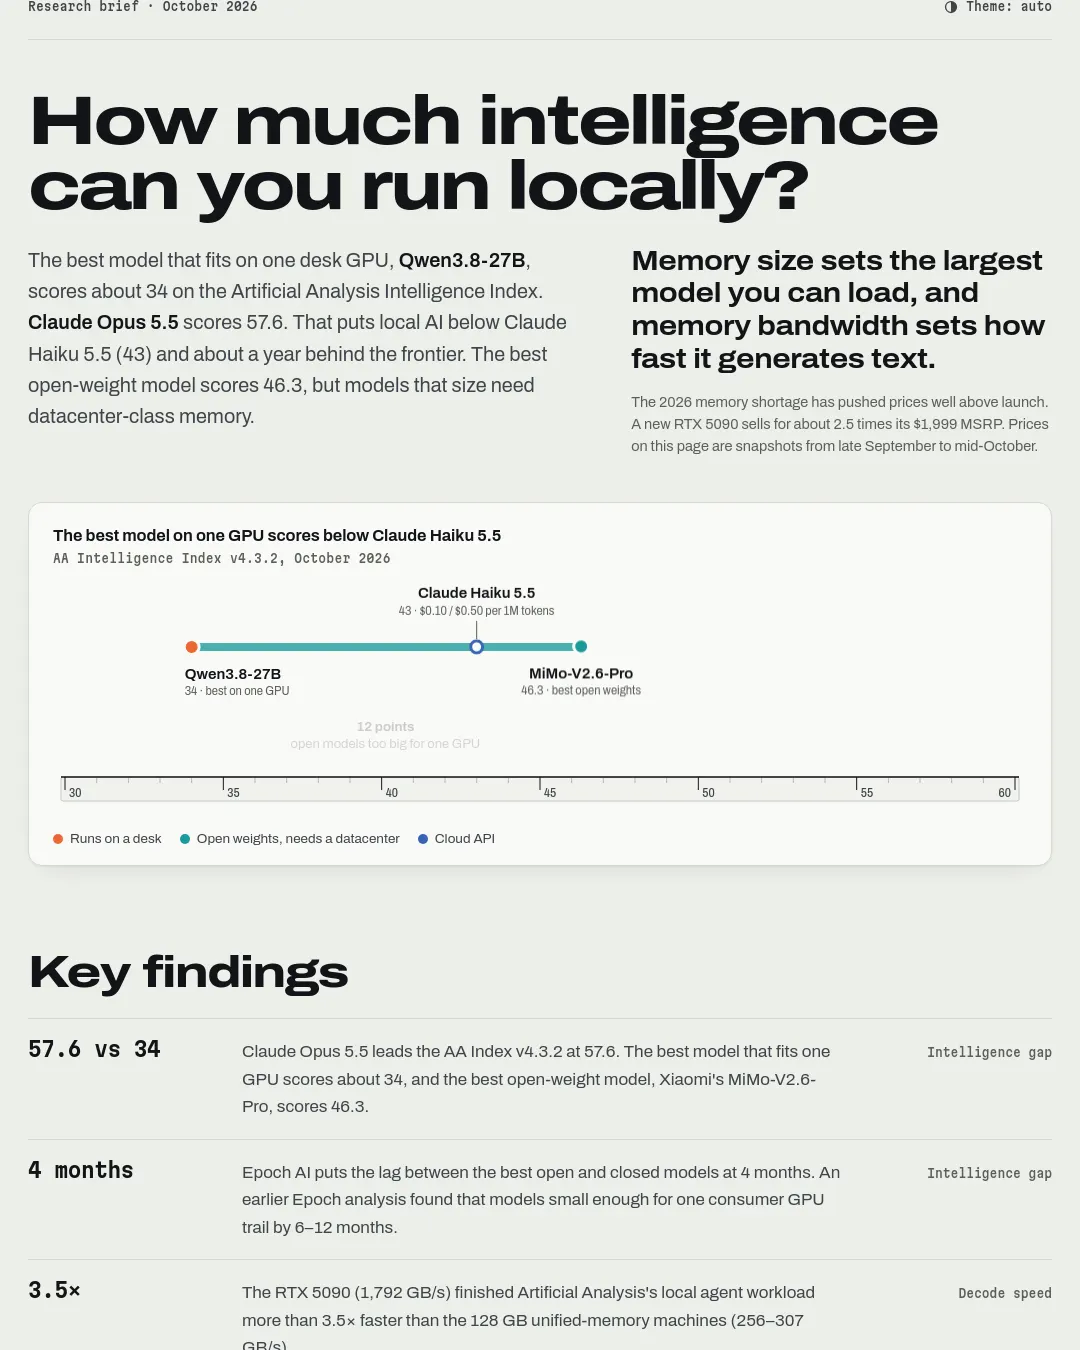
개인용 PC에서 모델을 직접 실행하면 메모리 용량과 속도, 모델 성능 사이에서 선택해야 한다. 이 비교 자료에 따르면 한 대의 GPU에 들어가는 모델은 최상위 폐쇄형 모델보다 AA Intelligence Index에서 약 24점 낮고, 메모리가 큰 데스크톱은 더 큰 모델을 실행할 수 있지만 생성 속도는 메모리 대역폭에 좌우된다.
AA Intelligence Index v4.3.2에서 Claude Opus 5.5는 57.6점을 기록했다. 한 대의 GPU에 들어가는 모델 가운데 최고 점수는 약 34점이며, 최고 오픈 웨이트 모델인 Xiaomi의 MiMo-V2.6-Pro는 46.3점이다. Epoch AI는 최고 오픈 모델과 폐쇄형 모델의 격차를 약 4개월로 추정했다. 소비자용 GPU 한 대에 들어가는 소형 모델은 최고 모델보다 6~12개월 뒤처진다는 이전 분석도 있다. AA 점수는 버전에 따라 산정 기준과 벤치마크가 달라지므로 v4.3.2 점수끼리만 비교해야 한다.
책상 위 장비에 들어가는 오픈 모델은 최상위 모델보다 규모가 작다. Kimi K3는 총 2조 8,000억 개의 파라미터와 활성 파라미터 1,040억 개를 갖췄고, DeepSeek V4.1 Flash는 5,520억 개 파라미터를 갖췄다. 자료는 DeepSeek V4.1 Flash가 512GB Mac Studio에 겨우 들어가는 규모라고 설명한다. 메모리가 128GB인 장비에서는 모델 크기보다 최신 모델인지가 중요할 수 있다. Qwen3.8-27B는 Qwen3.8-Flash-Next를 제외하면 해당 장비에 들어가는 120B급 모델보다 20점 이상 높은 점수를 기록했다.모델 점수 비교
실행 속도는 모델을 만드는 메모리 대역폭과 한 토큰을 생성할 때 읽어야 하는 가중치 양에 크게 좌우된다. 자료에 인용된 Artificial Analysis의 로컬 에이전트 작업에서는 RTX 5090이 128GB 통합 메모리 장비보다 3.5배 넘게 빨랐다. RTX 5090의 메모리 대역폭은 1,792GB/s이고, 비교 대상 장비는 256~307GB/s였다. 다만 gpt-oss-120b는 약 66GB가 필요해 32GB RTX 5090에는 들어가지 않는다. 128GB 장비에서는 토큰당 약 5GB를 읽기 때문에 약 55~88tok/s로 실행됐다.
모델 구조도 속도에 영향을 준다. 활성 파라미터가 30억 개인 혼합 전문가 모델 Qwen3.6-35B-A3B는 자료에서 시험한 모든 시스템에서 밀집형 Qwen3.8-27B보다 2.5~3.3배 빨랐다. 반면 한 토큰마다 전체 가중치를 읽는 밀집형 70B 모델은 Framework Desktop에서 약 5tok/s를 기록했다. 이 수치들은 서로 다른 엔진과 설정을 사용한 출처를 모은 것이므로 대략적으로 비교해야 한다.속도 자료
메모리 용량은 모델 가중치만으로 결정되지 않는다. 가중치는 대략 파라미터 수에 비트 수를 곱한 뒤 8로 나눠 계산하며, 70B 모델은 16비트에서 약 140GB, Q4_K_M에서 약 40~42GB를 차지한다. 여기에 긴 문맥을 처리할수록 커지는 KV 캐시가 더해진다. Qwen3.8-27B는 f16 기준 토큰당 약 64KiB의 KV 캐시를 사용해 128K 토큰 문맥에서 8GiB가 필요하다. 자료가 인용한 한 연구는 KV 캐시를 4비트로 양자화해도 손실이 거의 없었지만, 3비트에서는 손실이 심했다고 보고했다.메모리 계산 자료
양자화는 가중치의 비트 수를 줄여 모델을 작은 메모리에 넣는 방법이다. 자료에 따르면 추론 모델은 4비트 가중치 전용 양자화에서 성능 손실이 1% 이하였지만, 4비트 아래에서는 손실이 빠르게 커졌다. 특히 작은 모델과 어려운 작업에서 영향이 컸다. 도구 호출도 민감한 영역이다. Qwen3.8-27B에서 전체 모델과 32토큰 일치율은 UD-Q2_K_XL에서 약 25%였고, UD-IQ2_S에서는 10% 미만이었다. 따라서 자료는 기본 설정으로 Q4_K_M, AWQ 또는 NVFP4를 권하고, 메모리가 허용되면 코딩과 수학 작업에서 Q5·Q6·FP8을 고려하라고 제안한다. 에이전트에는 약 3.5비트 미만을 피하고, 긴 문맥에는 KV 캐시 Q8을 권한다.양자화 자료
구매 비용도 선택 기준이다. 자료의 늦은 2026년 가격 기준으로 RTX 5090의 북미 가격은 약 5,000달러이며, 128GB Framework Desktop은 1,999달러에서 3,449달러로 올랐다. 통합 메모리 장비는 가격 대비 메모리 용량이 크고, 엔비디아 GDDR 그래픽카드는 가격 대비 대역폭이 크다는 분석이다. 단, M5 Max 128GB의 가격은 한 출처가 5,099달러, 다른 출처들이 5,800~6,999달러로 달리 보고했다. 자료는 RTX 5090이 신품 MSRP 1,999달러보다 비싼 약 5,000달러에 판매된다고 적었다.하드웨어와 가격
혼자 쓰는 환경에서는 llama.cpp와 이를 기반으로 한 Ollama, LM Studio가 여러 하드웨어와 양자화 형식을 지원하며, 메모리가 부족할 때 CPU로 일부 작업을 넘길 수 있다. 여러 사용자의 요청을 함께 처리하는 서버 환경에서는 KV 캐시를 페이지 단위로 관리하고 요청을 묶는 vLLM이나 SGLang이 적합하다고 자료는 설명한다. DGX Spark에서 gpt-oss-120b의 속도는 Ollama에서 11.7tok/s, 설정을 조정한 llama.cpp에서 38.5tok/s, SGLang에서 약 50tok/s로 제시됐다. 자료는 엔진과 설정에 따라 같은 하드웨어에서도 속도가 크게 달라질 수 있다고 경고한다.추론 엔진 비교
한 사람을 위한 장비를 고른다면 원하는 모델이 들어갈 만큼의 메모리를 먼저 확보한 뒤, 예산 범위에서 메모리 대역폭을 높이는 것이 자료의 권고다. 자료는 개인용 장비에서 얻는 결과가 Claude Haiku급이며 최첨단 모델보다 약 1년 뒤처질 것으로 예상한다. 다만 벤치마크에는 업체 자체 측정치와 서로 다른 평가 도구가 섞여 있다. 예를 들어 Qwen3.8-27B의 SWE-bench Pro 61.7점은 Qwen이 개선한 벤치마크 버전에서 나온 결과라 Anthropic의 89.9%와 직접 비교할 수 없다. 교차 출처 속도 비교도 근사치로 봐야 한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요