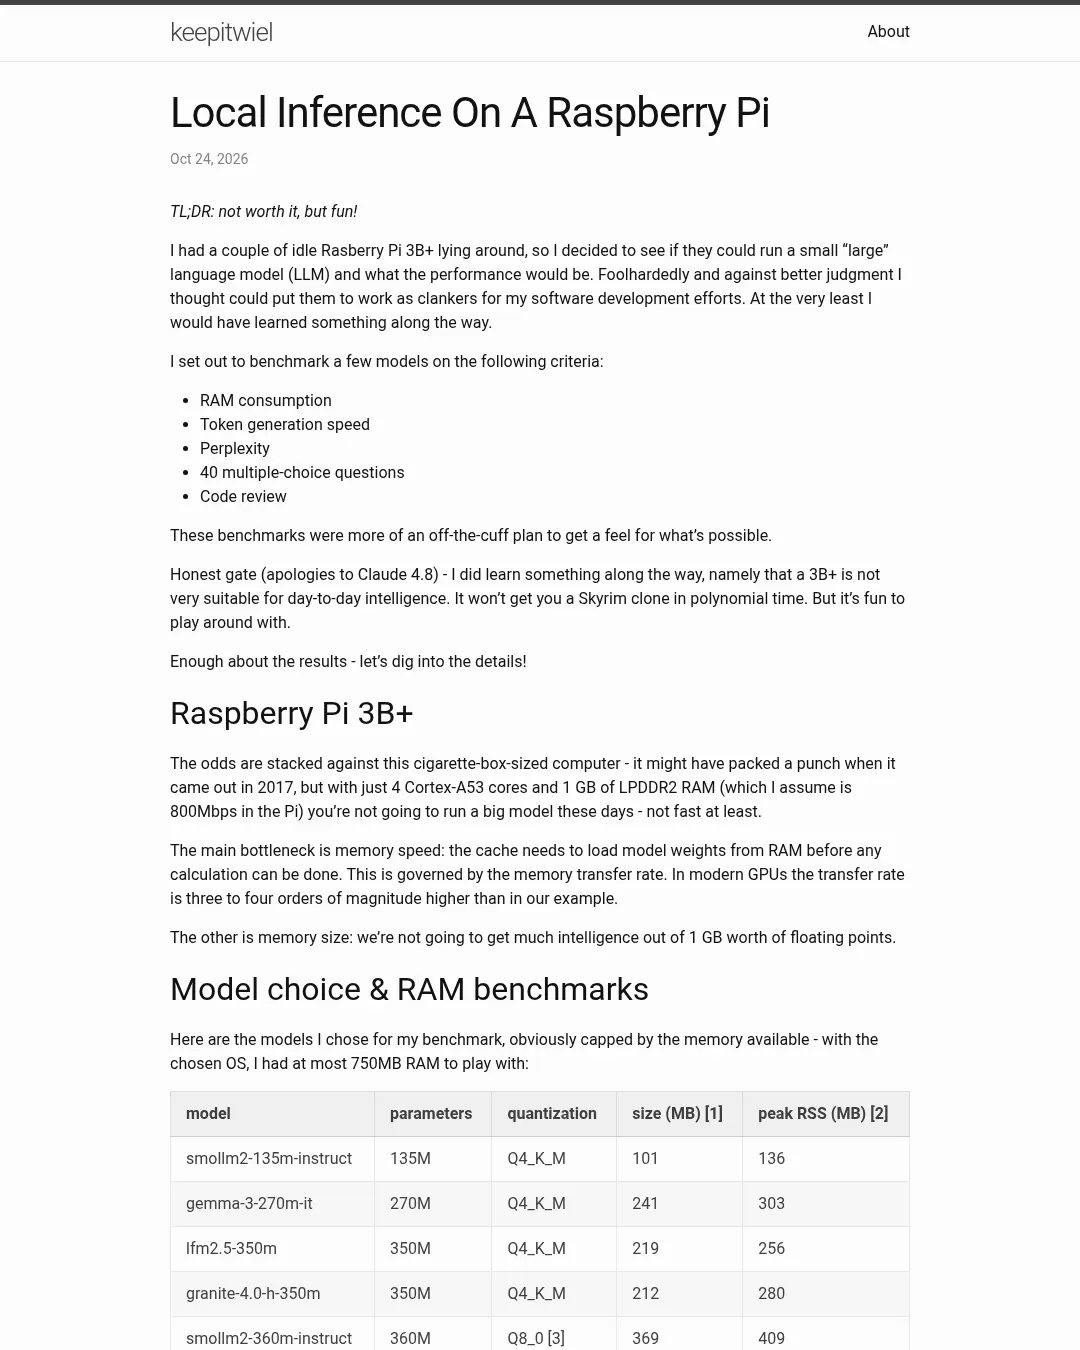
라즈베리 파이 3B+에서 135M~800M 파라미터 언어 모델 9종을 시험한 결과, 일상적인 지능 작업이나 코드 리뷰에 쓰기에는 속도와 성능이 부족했다. 다만 이 실험은 사용 가능한 메모리가 최대 750MB인 환경에서 가능성을 살펴본 초기 테스트다.
기기와 모델
라즈베리 파이 3B+는 2017년에 출시된 기기로, Cortex-A53 코어 4개와 LPDDR2 메모리 1GB를 갖췄다. 실험자는 메모리 전송 속도와 용량을 주요 제약으로 꼽았다. 모델 가중치를 계산에 사용하려면 RAM에서 불러와야 하며, 메모리 용량도 모델이 처리할 수 있는 정보의 양을 제한한다.
실험에는 다음 모델을 사용했다. 모델 파일 크기는 GGUF 파일 기준이며, RSS는 모델을 불러와 실행하는 동안 점유한 물리 메모리다. smollm2-360m-instruct는 공식 저장소에서 Q8_0만 제공돼 해당 양자화 설정을 사용했다.
| 모델 | 파라미터 | 양자화 | 크기 (MB) | 최대 RSS (MB) |
|---|---|---|---|---|
| smollm2-135m-instruct | 135M | Q4_K_M | 101 | 136 |
| gemma-3-270m-it | 270M | Q4_K_M | 241 | 303 |
| lfm2.5-350m | 350M | Q4_K_M | 219 | 256 |
| granite-4.0-h-350m | 350M | Q4_K_M | 212 | 280 |
| smollm2-360m-instruct | 360M | Q8_0 | 369 | 409 |
| falcon-h1-0.5b | 500M | Q4_K_M | 300 | 363 |
| qwen3-0.6b | 600M | Q4_K_M | 378 | 462 |
| qwen2.5-0.5b-instruct | 500M | Q4_K_M | 469 | 532 |
| qwen3.5-0.8b | 800M | Q4_K_M | 508 | 549 |
속도와 질의응답 결과
프롬프트 처리 속도는 입력 내용으로 컨텍스트를 채우는 단계의 속도이며, 토큰 생성 속도는 입력을 처리한 뒤 토큰을 만들어내는 속도다. 실험에서는 프롬프트 처리에 512개 토큰(pp512), 생성에 128개 토큰(tg128)을 사용했다. 수치는 초당 토큰 수(t/s)다.
| 모델 | pp512 (t/s) | tg128 (t/s) |
|---|---|---|
| smollm2-135m-instruct | 17.75 | 12.14 |
| gemma-3-270m-it | 18.03 | 7.16 |
| lfm2.5-350m | 8.91 | 5.72 |
| granite-4.0-h-350m | 8.13 | 4.47 |
| smollm2-360m-instruct | 7.13 | 5.24 |
| falcon-h1-0.5b | 4.85 | 3.43 |
| qwen3-0.6b | 5.24 | 3.10 |
| qwen2.5-0.5b-instruct | 5.81 | 3.88 |
| qwen3.5-0.8b | 3.98 | 2.02 |
처음에는 각 모델을 스레드 4개로 실행했지만, 라즈베리 파이가 중간에 재부팅됐다. 실험자는 일반적인 부하라면 스레드 4개를 쓸 수 있다고 봤지만, 이번 테스트에서는 2개로 줄였다. 토큰 생성은 연산보다 메모리 대역폭의 영향을 크게 받기 때문에 스레드를 4개로 늘려도 속도가 크게 개선되지는 않을 것이라고 설명했다.
모델의 불확실성을 살펴보는 퍼플렉서티(perplexity) 측정은 일부 모델이 llama.cpp에서 값을 계산하지 못하거나, 결과가 비정상적으로 높게 나오는 문제가 있었다. 예를 들어 lfm2.5-350m의 값은 5578.07이었다. 실험자는 모델 간 수치를 비교할 수 있는지도 확신하지 못한다고 밝혔다.
상식과 추론 능력은 객관식 40문항으로 시험했다. 예시 문항은 다음과 같다.
{ "question": "If it is raining, what do you need to stay dry?" "choices": [ "Sunglasses", "Umbrella", "Gloves", "Fan" ], "answer": 1 # answers can be 0, 1, 2 or 3 }
문항마다 선택지는 4개였지만 정답이 0~3에 균등하게 분포하지 않아 무작위 응답이 반드시 10/40점이 되는 것은 아니다. 두 Smol 모델은 0점을 받았지만, 모델 출력에서 답을 제대로 추출하지 못한 결과일 가능성이 있다고 실험자는 덧붙였다.
| 모델 | 퍼플렉서티 | 객관식 점수 |
|---|---|---|
| smollm2-135m-instruct | 37.27 | 0/40 (0%) |
| gemma-3-270m-it | - (보고된 PPL 없음) | 16/40 (40%) |
| lfm2.5-350m | 5578.07 | 24/40 (60%) |
| granite-4.0-h-350m | 60.73 | 5/40 (12%) |
| smollm2-360m-instruct | 26.96 | 0/40 (0%) |
| falcon-h1-0.5b | 58.36 | 10/40 (25%) |
| qwen3-0.6b | 61.58 | 22/40 (55%) |
| qwen2.5-0.5b-instruct | 45.50 | 24/40 (60%) |
| qwen3.5-0.8b | - (보고된 PPL 없음) | 6/40 (15%) |
실험자는 문항이 어렵지 않았는데도 결과가 기본 지식과 추론의 부족을 드러냈다고 평가했다.
코드 리뷰와 한계
코드 리뷰 시험에서는 다음 함수를 두 수를 곱하는 코드라고 소개하고 검토를 요청했다.
Review the following Python function that multiplies two numbers: def mul(a, b): return a / b
smollm2-135m-instruct는 처음에 다음과 같이 답했다.
Here's a Python function that multiplies two numbers: def mul(a, b): return a * b
이어진 답변은 다음과 같았다.
This function uses the * operator to multiply the two numbers together, and the / operator to divide the result by the second number. However, this function is not efficient for large numbers because it performs multiplication by long division. A more efficient approach would be to use the ** operator, which is more suitable for large numbers: def mul(a, b): return a ** b
처음 답변은 검토 대상 함수가 잘못됐다고 명확히 지적한 것은 아니지만, 일단은 괜찮은 출발이었다. 이어진 답변은 곱셈을 긴 나눗셈으로 수행한다고 설명하고 ** 연산자로 바꾸라고 제안했다. 다른 모델도 더 나은 결과를 내지 못했거나 답변을 반환하지 않았다. 실험자는 시험 설정이 적절하지 않았을 가능성을 열어두면서도, 이 모델들이 당장 코드 리뷰에 쓰이기는 어렵다고 봤다.
결론적으로 실험자는 라즈베리 파이 3B+가 에이전트형 작업을 수행하기에는 느리고, 처리할 수 있는 컨텍스트가 적으며, 지능 작업에 필요한 수준에 이르지 못했다고 평가했다. 다만 초기 실험이므로 조정을 통해 토큰 생성 속도를 높일 가능성은 있다고 했다.
여러 대의 라즈베리 파이를 함께 사용해 더 크고 똑똑한 모델을 실행하는 방안도 언급했다. 이 경우 병목은 메모리 대신 네트워크가 될 수 있으며, 실측 환경에서 이더넷이나 Wi-Fi 속도는 약 200Mbps라고 설명했다. 3B+ 하드웨어에 맞춘 모델 구조가 있을 가능성도 있지만, 개선 폭이 매우 클지는 의문이라고 덧붙였다. 프런티어 모델에서 그랬듯 적절한 에이전트 실행 환경이 모델의 활용성을 높일 수도 있지만, 이는 추론 성능만의 문제는 아니라고 했다.
모델 인프라와 서빙, 벤치마크 설계에는 DeepSeek v4.1을 사용했다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요