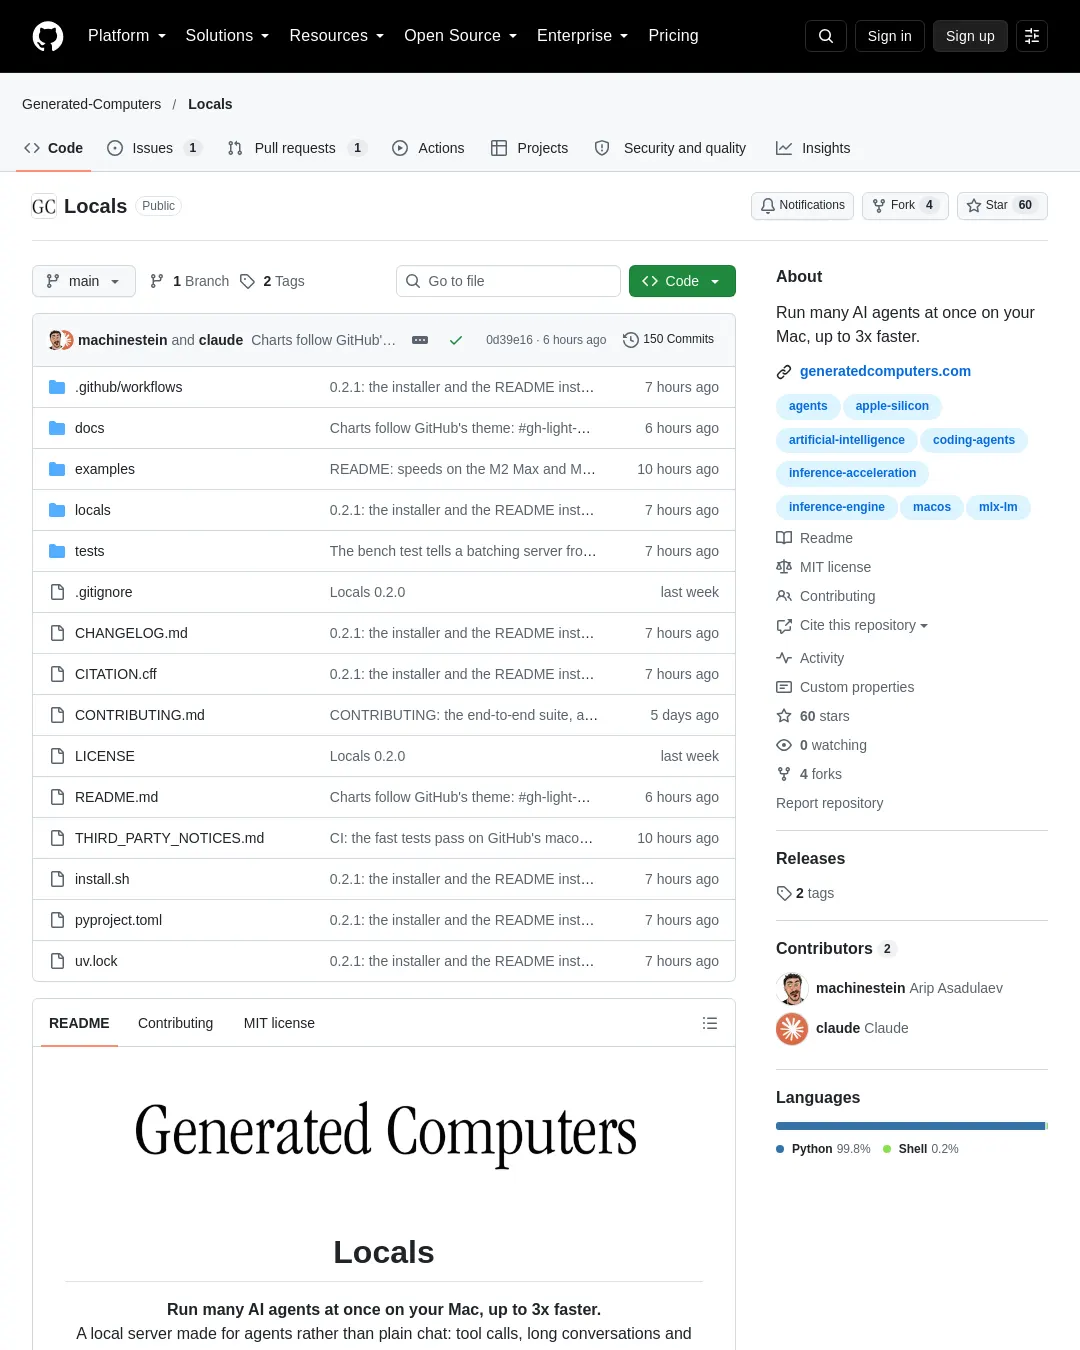
Locals는 Apple 실리콘 Mac에서 AI 모델을 로컬로 구동해 코딩 에이전트 여러 개의 요청을 함께 처리하는 서버다. 제작사 Generated Computers는 M2 Pro에서 8개 요청을 동시에 처리할 때 기본 방식인 mlx-lm보다 최대 3배 빠르다고 보고했다.
Locals는 OpenCode, Cline, Aider, OpenHands, Claude Code 등과 호환되며 OpenAI·Anthropic·Ollama API를 사용하는 앱도 지원한다. 제작사에 따르면 요청과 모델은 사용자의 컴퓨터 안에서 처리된다. locals code로 프로젝트에서 OpenCode를 열 수 있고, 설치 후 첫 실행 때 Mac에 맞는 모델을 내려받는다. 기본 모델 다운로드 용량은 약 3GB다.
제작사가 공개한 주요 측정치는 M2 Pro와 메모리 16GB, Qwen3.5-4B 환경을 기준으로 한다. 논문에서 보고한 결과는 별도 조건인 Qwen3.5-2B를 사용했다.
| 작업 | mlx-lm 또는 Ollama | Locals | 차이 |
|---|---|---|---|
| 요청 8개 동시 처리 | 87 tokens/s | 271 tokens/s | 3.1배 |
| 에이전트 8개의 첫 토큰까지 시간 | Ollama 42초 | 1.6초 | 26배 빠름 |
| 100줄 파일 재작성 | 43 tokens/s | 128 tokens/s | 3.0배 |
| 재시작 후 첫 요청 | 16초 | 1.7초 | 9.6배 빠름 |
| 48,000토큰 문서 후속 질문 | mlx-lm은 메모리 부족 | 0.6초 | — |
| 도구를 호출하는 코딩 에이전트 16개 | 75초 | 29초 | 2.5배 |
제작사 측정에 따르면 요청이 하나뿐이고 재사용할 프롬프트가 없을 때는 M2 Pro에서 mlx-lm과 속도가 비슷하다. 긴 프롬프트를 읽는 작업도 GPU 연산에 제약을 받는다. M5에서는 MLX가 신경 가속기용 커널을 사용해 성능 차이가 1.5배로 줄었다. M1·M3·M4 결과는 아직 측정되지 않았다. 속도는 모델 형식에도 영향을 받으며, 통상적인 4비트 양자화 모델의 일부 조건에서 개선 폭이 컸지만 모든 형식에서 빨라지는 것은 아니다.
사용하려면 Apple 실리콘 M1 이상과 macOS 14 이상이 필요하다. 16GB 메모리에서 가장 좋은 결과를 내며, 8GB Mac에서는 더 작은 모델을 권장한다. 설치와 사용 방법, 측정 조건은 Locals 저장소, 벤치마크 문서에서 확인할 수 있다. Locals는 MIT 라이선스로 배포된다.
curl -LsSf https://raw.githubusercontent.com/Generated-Computers/Locals/main/install.sh | sh
새 터미널 창에서 프로젝트를 지정해 실행한다.
locals code ~/my-project
기술적 배경은 관련 논문에 공개돼 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요