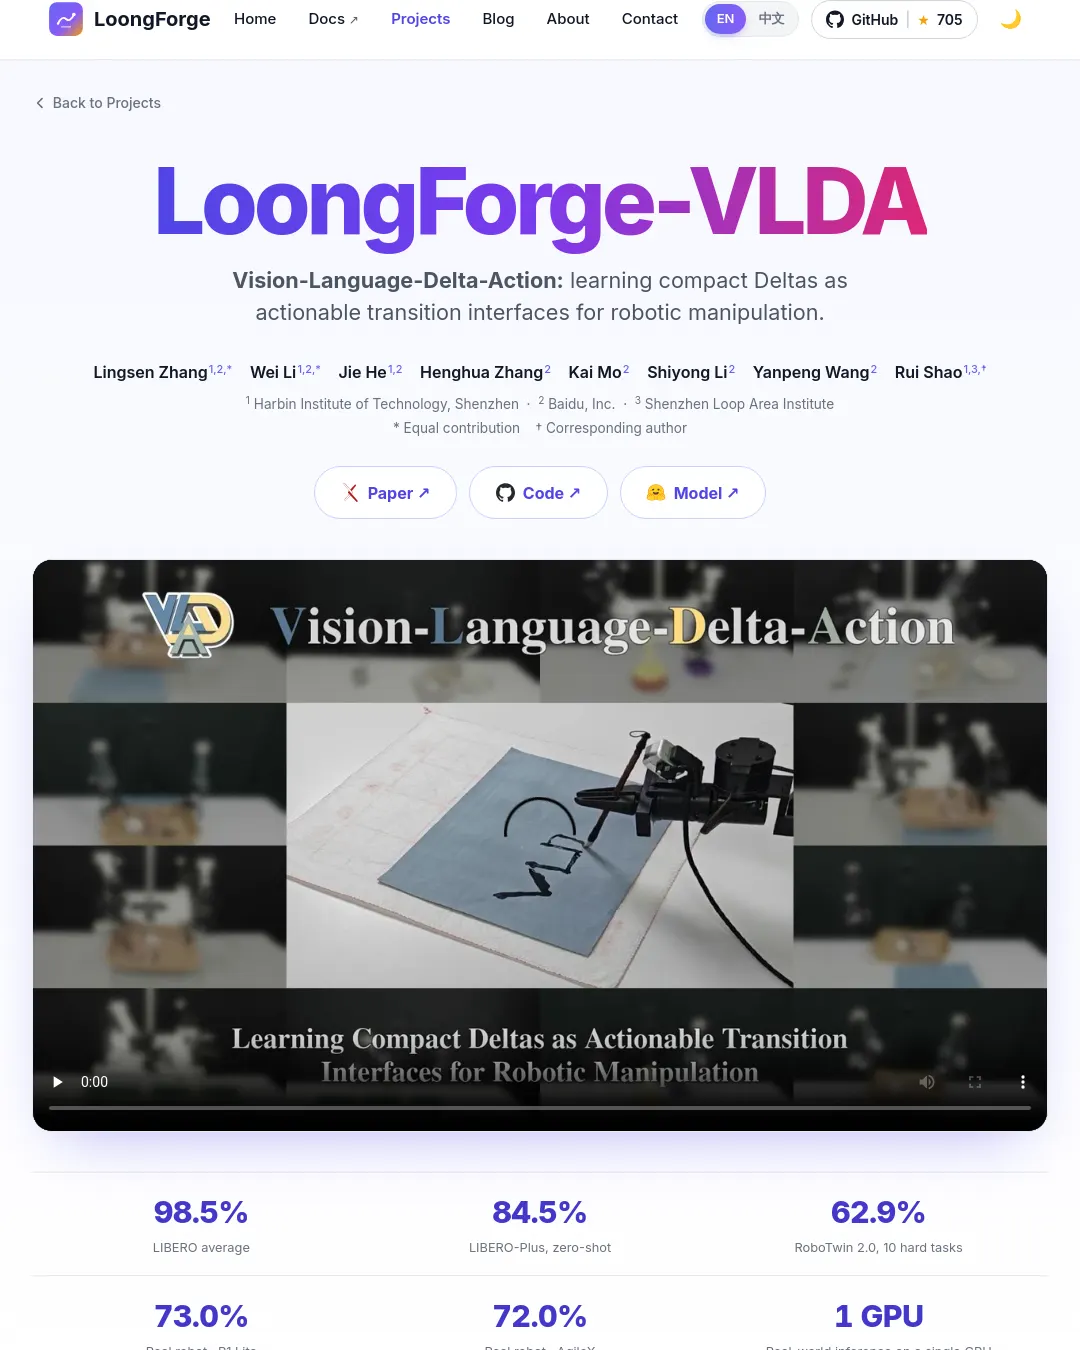
LoongForge-VLDA는 장면 전체의 미래 프레임 대신 조작 과정에서 달라지는 부분을 압축한 ‘Delta’를 학습해 행동 생성에 활용하는 로봇 조작 모델이다. 공개 페이지에 따르면 시뮬레이션 벤치마크와 실제 로봇 실험에서 비교 모델보다 높은 성공률을 기록했다.
모델은 V-JEPA 2 EMA 교사 모델이 만든 전이 정보를 두 단계로 학습한다. 먼저 지역·전역 전이 필터로 Delta를 학습하고, 이후 Delta를 행동 생성기에 반영한다. 추론에는 미래 관측이 필요하지 않으며, 학습이 끝나면 EMA 교사 모델을 제거할 수 있다고 설명한다. 학습에는 GPU 8개를 사용했고, 실제 환경 추론은 GPU 한 개에서 가능하다고 공개 페이지는 밝혔다.
공개된 결과에서 LIBERO 평균 성공률은 98.5%로, 비교 대상 π0.5의 96.9%보다 1.6%포인트 높았다. LIBERO-Plus에서는 제로샷 성공률 84.5%를 기록해 π0.5의 73.6%를 앞섰다. RoboTwin 2.0의 어려운 10개 과제에서는 62.9%였으며, 전체 50개 과제 평균은 50.86%로 π0.5의 43.84%보다 높았다고 보고했다.
실제 로봇 실험은 GALAXEA R1 Lite에서 네 가지 과제를 각 25회 수행했다. 평균 성공률은 73.0%로 π0.5의 56.0%였고, AgileX Cobot Magic에서는 각각 72.0%와 54.0%였다. 이는 프로젝트 페이지가 제시한 결과이며, 수치는 해당 실험 조건에 따른다.
논문은 arXiv에서, 학습 코드와 설정은 LoongForge-VLDA 저장소에서 확인할 수 있다. 모델 모음은 Hugging Face에 공개돼 있다. 저장소를 가져오는 명령은 다음과 같다.
git clone https://github.com/baidu-baige/LoongForge.git
부록: 원문 예시
@misc{zhang2026visionlanguagedeltaactionlearningcompactdeltas, title={Vision-Language-Delta-Action: Learning Compact Deltas as Actionable Transition Interfaces for Robotic Manipulation}, author={Lingsen Zhang and Wei Li and Jie He and Henghua Zhang and Kai Mo and Shiyong Li and Yanpeng Wang and Rui Shao}, year={2026}, eprint={2610.25874}, archivePrefix={arXiv}, primaryClass={cs.RO}, url={https://arxiv.org/abs/2610.25874}, }
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요