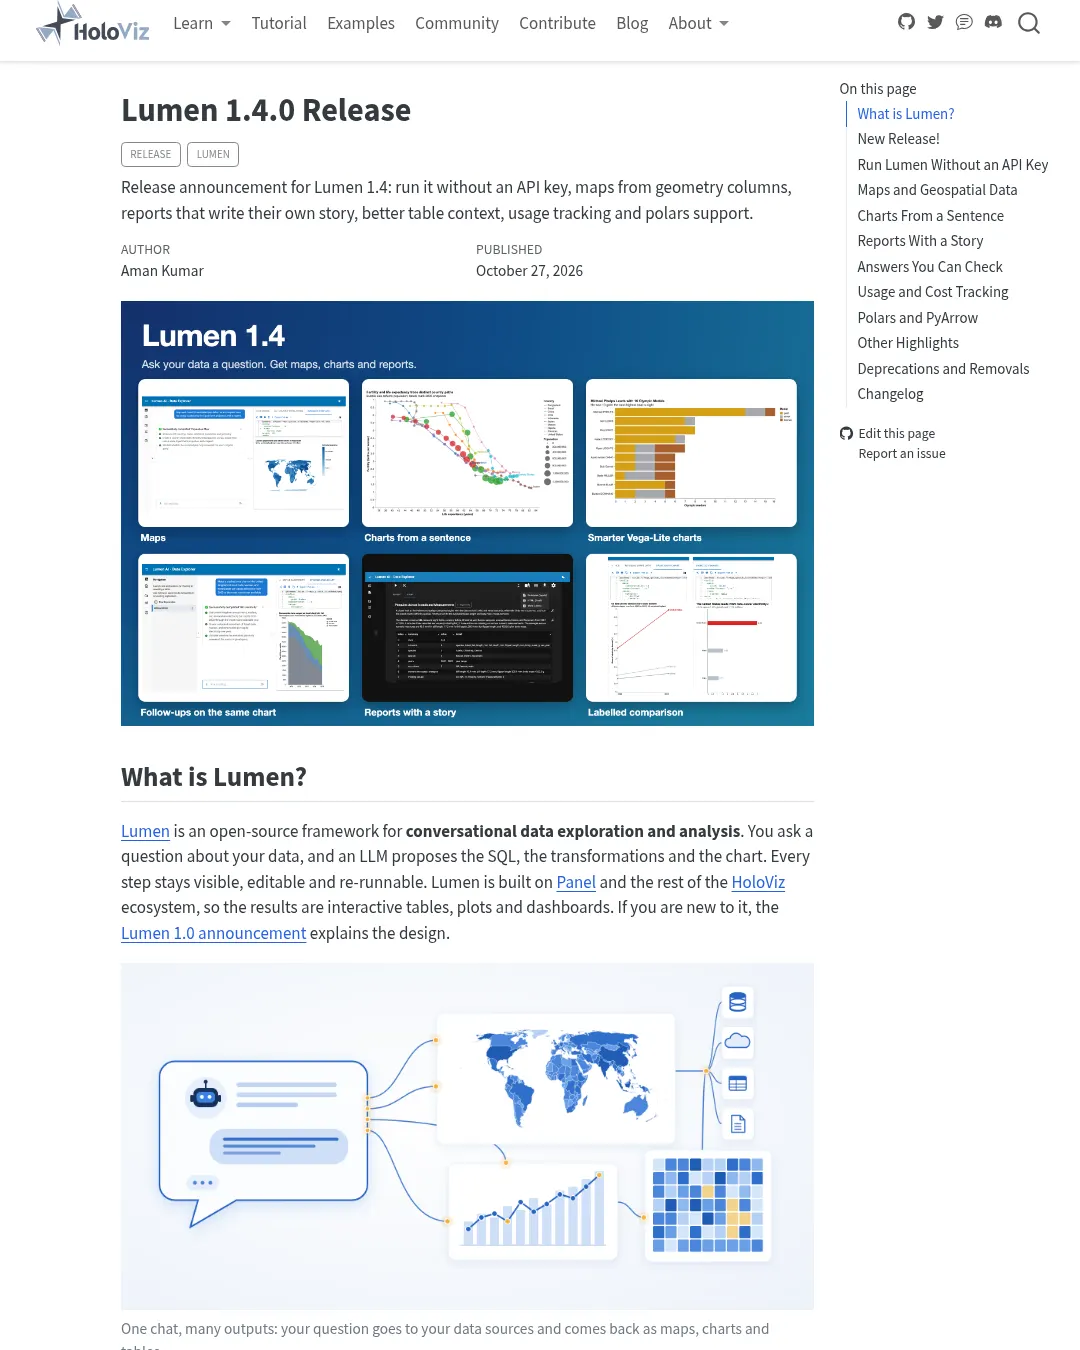
오픈소스 데이터 탐색·분석 프레임워크 Lumen 1.4.0은 API 키 없이도 코딩 CLI, Kilo 무료 모델, 로컬 Ollama를 통해 분석을 시작할 수 있게 했다. 표의 데이터 품질 점검과 지리공간 시각화, 보고서 작성 기능도 추가됐다.
Lumen은 자연어 질문을 바탕으로 SQL과 데이터 변환, 차트를 만들고 각 단계를 확인·수정·재실행할 수 있는 도구다. Lumen 사이트와 1.0 발표문에서 기본 설계를 확인할 수 있다.
lumen-ai serve는 Claude Code, Codex, GitHub Copilot CLI와 Kilo, 로컬 Ollama를 제공자로 사용할 수 있다. 아무것도 설정하지 않은 경우 Lumen은 임의의 제공자를 선택하는 대신 이용 가능한 선택지를 안내한다. Claude Code와 Copilot 제공자는 자체 도구를 끄고 빈 임시 디렉터리에서 실행되지만, Lumen의 도구를 CLI에 전달하지는 않는다. 따라서 채팅에서 URL을 가져오는 등 모델이 도구를 호출해야 하는 작업은 실행할 수 없으며, 데이터를 명령줄에 전달해야 한다. Kilo 무료 모델은 계정이 필요 없지만 공유 서비스라 속도와 사용량에 제한이 있다. 발표문 테스트에서는 차트로 이어진 질문에 5~6분이 걸렸고, 약 40분간 계속 사용한 뒤 무료 가입을 안내하는 429 응답이 나타났다.
표의 기하 열이나 GeoJSON 파일로 지도를 만들 수 있고, 보고서에는 전체 요약과 섹션별 메모를 생성해 넣을 수 있다. 보고서는 Word 문서로 내보낼 수 있으며, 서술문을 편집할 수 있다. 에이전트가 사용하는 표 정보는 열별 유형·값·범위·결측 비율 등을 담도록 개선됐다. SQL 결과에서는 결측값, 중복 행, 자리표시자 숫자와 이상치 등을 점검한다. 이런 점검 자체에는 LLM 호출이 필요 없고, 수정할 만한 문제가 있을 때만 SQLAgent가 쿼리를 다시 작성하는 추가 호출을 한다.
Polars와 PyArrow 데이터프레임도 지원한다. 다만 일부 변환과 뷰는 여전히 pandas로 바뀐다. Lumen 1.4에는 Python 3.11 이상, Panel 1.9 이상, Bokeh 3.9 이상이 필요하며 HistoryTransform은 폐기 예정으로 표시됐다.
부록: 원문 예시
ERROR: No LLM provider found: no API key is set. Pick one of these to get started: - Free models, no signup: --provider kilo - Use a coding CLI you are signed in to: --provider claude-code - Sign in to one of these coding CLIs first: --provider copilot-cli, --provider antigravity-cli - Set an API key, e.g. OPENAI_API_KEY, ANTHROPIC_API_KEY or GEMINI_API_KEY - Use an OpenAI-compatible server: --provider openai --provider-endpoint URL - Ollama is running with no models:
import asyncio from lumen.ai.schemas import get_metaset from lumen.sources.duckdb import DuckDBSource url = "https://datasets.holoviz.org/penguins/v1/penguins.csv" source = DuckDBSource( uri=":memory:", tables={"penguins": f"read_csv('{url}', nullstr='NA')"}, ) print(asyncio.run(get_metaset([source], ["penguins"])).compact_context())
import asyncio from lumen.ai.llm import Kilo MODEL = "nvidia/nemotron-3-ultra-550b-a55b:free" async def main(): llm = Kilo( model_kwargs={"default": {"model": MODEL}}, usage_pricing={MODEL: {"input": 0.0, "output": 0.0}}, # USD per million tokens ) with llm.capture_usage() as usage: await llm.invoke([{"role": "user", "content": "Name one penguin species."}]) print(usage.input_tokens, usage.output_tokens, usage.cost_usd) asyncio.run(main())
import polars as pl from lumen.pipeline import Pipeline from lumen.sources.base import InMemorySource from lumen.transforms import Aggregate, Filter url = "https://datasets.holoviz.org/penguins/v1/penguins.csv" penguins = pl.read_csv(url, null_values="NA") pipeline = Pipeline( source=InMemorySource(tables={"penguins": penguins}), table="penguins", transforms=[ Filter(conditions=[("island", "Biscoe")]), Aggregate(method="mean", by=["species"], columns=["body_mass_g"], with_index=False), ], ) print(type(pipeline.data)) print(pipeline.data)
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요