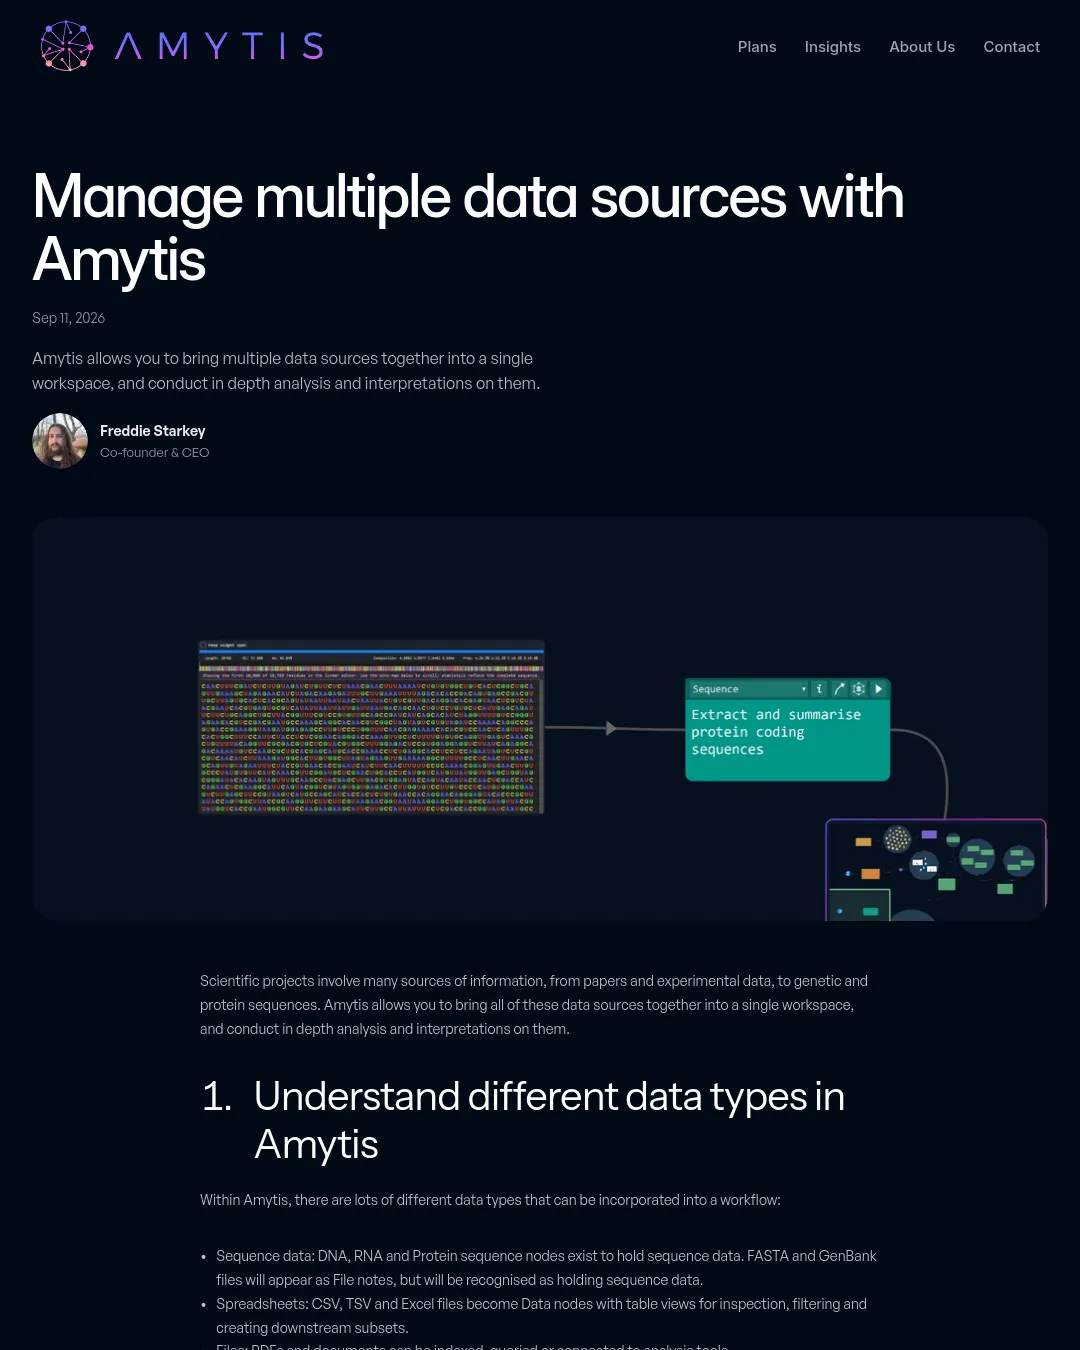
Amytis는 논문과 실험 데이터, 유전자·단백질 서열 등 여러 과학 자료를 한 작업공간에 모아 분석하고 해석하도록 돕는다. 자료를 캔버스에 끌어다 놓거나 검색 노드를 이용해 추가할 수 있다.
DNA·RNA·단백질 서열은 서열 노드에 담을 수 있다. FASTA·GenBank 파일은 파일 노드로 표시되지만 서열 데이터로 인식된다. CSV·TSV·Excel 파일은 표를 살펴보고 필터링하거나 후속 분석용 하위 집합을 만드는 데이터 노드가 된다. PDF와 문서는 색인화해 검색하거나 분석 도구와 연결할 수 있다.
Database·Journal 노드는 자연어 프롬프트로 과학 데이터베이스와 학술지를 검색한다. 지원 출처에는 유전자·단백질·뉴클레오타이드 기록을 제공하는 NCBI, 단백질 정보를 제공하는 UniProt, 유전자와 유전체 정보를 제공하는 Ensembl, 분자 구조의 PDB, 단백질 상호작용의 STRING, 경로 정보를 제공하는 KEGG, 화합물 정보의 PubChem, 유전자 발현 연구의 GEO, 생물학적 정량 측정값의 BioNumbers가 포함된다. PubMed와 PMC를 통해 생의학 문헌도 검색할 수 있다. Database·Journal 노드 안내
전문 데이터베이스 밖의 자료는 Web Query로 공개 웹에서 찾을 수 있다. LIMS Query는 자연어 인터페이스로 실험실 재고, 샘플, 장비와 프로토콜을 검색한다.
내장된 Python·R Factory 노드에서는 Amytis 안에서 스크립트를 생성하고 실행할 수 있다. Python·R 노드 사용 안내
Sequence 노드는 RNA·DNA·단백질 서열을 살펴보고 분석한다. 상단 메뉴에서 새 서열 노드를 만들거나 서열 파일을 캔버스에 끌어다 놓으면 Amytis가 서열 데이터로 인식한다. 지원 작업에는 서열 자르기, 모티프 분석, 번역, ORF 탐지, 제한효소 분석, 조립, 정렬, BLAST, 프라이머 작업이 있다. 분석에서 파생된 서열과 통계는 새 노드로 캔버스에 돌아와 원래 생물학적 자료와 분석 결과의 관계를 유지한다.
각 데이터에 맞는 시각화와 해석을 수행한 뒤, 개별 결과를 Prompt 카드에 연결해 여러 데이터 세트를 종합하고 요약할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요