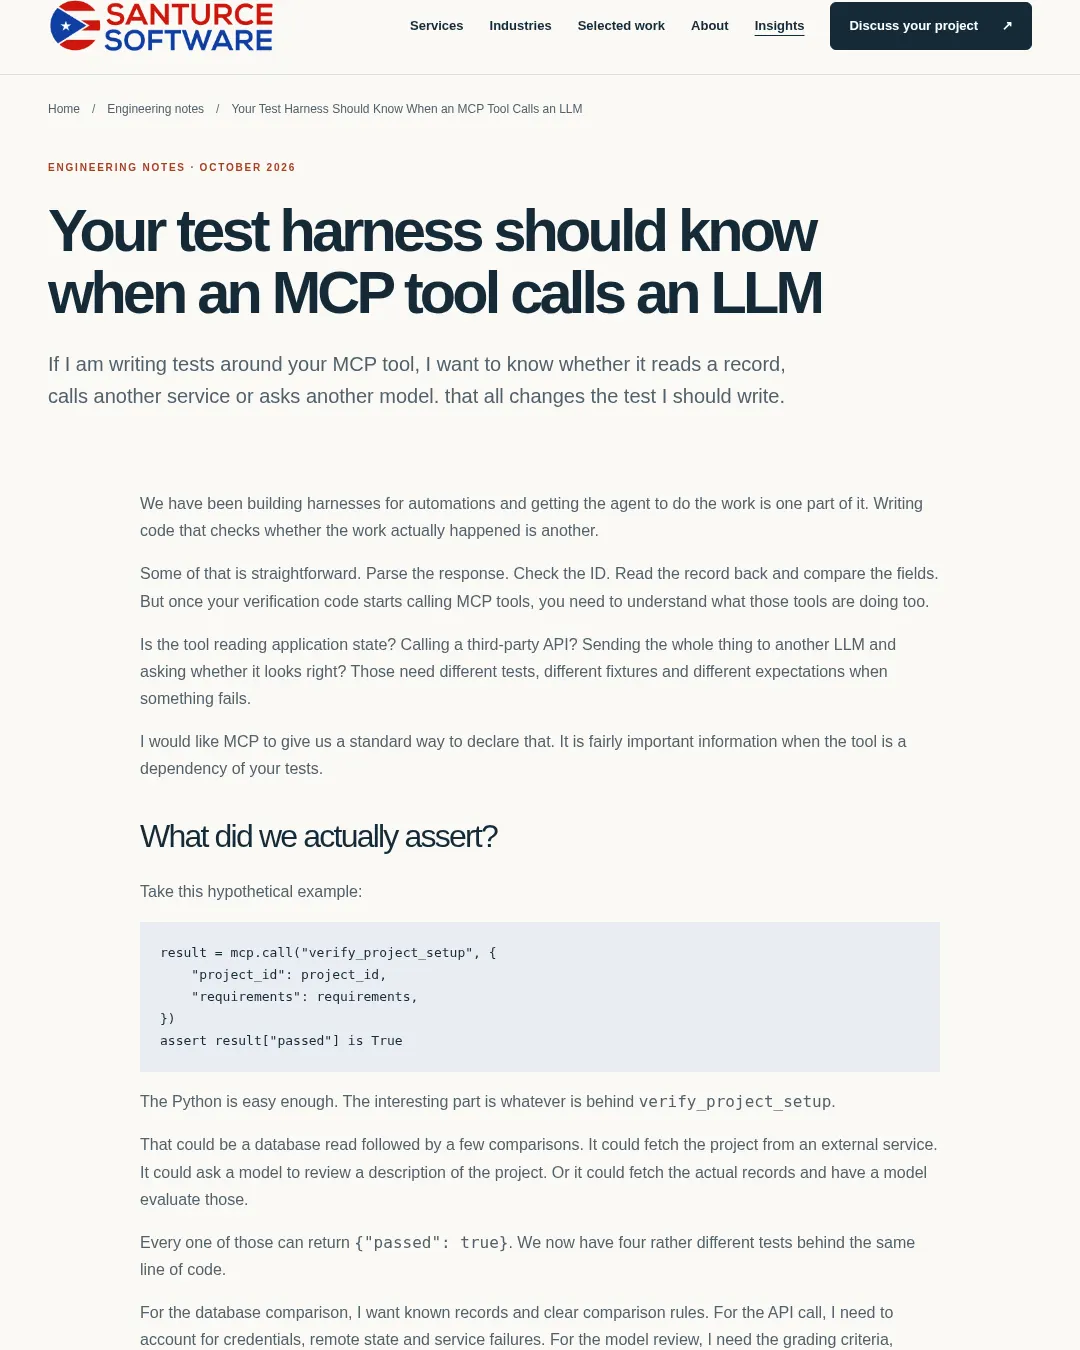
자동화 에이전트가 작업을 수행했는지 확인하는 테스트에서 MCP 도구를 호출한다면, 그 도구가 LLM이나 외부 API를 사용하는지도 알아야 한다. 글은 이런 의존성과 실제 호출 여부를 표준 방식으로 공개하자고 제안하며, 자체 MCP 서버에 적용한 비표준 확장 사례를 소개한다.
작업 결과를 파싱하거나 ID와 레코드를 확인하는 검증은 비교적 단순하다. 하지만 verify_project_setup 같은 도구가 데이터베이스를 읽는지, 외부 서비스를 호출하는지, 모델에 검토를 맡기는지에 따라 필요한 테스트와 픽스처, 실패 시 기대하는 동작은 달라진다. 모두 {"passed": true}를 반환하더라도 실제로는 서로 다른 테스트일 수 있다.
데이터베이스 비교에는 알려진 레코드와 명확한 비교 규칙이 필요하다. 외부 API 호출을 테스트하려면 인증 정보와 원격 상태, 서비스 실패를 고려해야 한다. 모델 검토에는 평가 기준과 모델 설정, 결과 변동성에 대한 이해가 필요하다. 유효한 JSON은 응답을 파싱했다는 사실만 보여줄 뿐, 테스트가 무엇을 근거로 통과했는지는 거의 알려주지 않는다.
LLM이 문장을 생성한다면 전체 응답을 고정 문자열과 비교하는 방법이 적절하지 않을 수 있다. 응답 구조나 특정 사실을 확인하거나, 예상 결과를 아는 예제로 시험하거나, 여러 번 실행해 결과를 측정할 수 있다. 제약된 출력에는 정확한 문자열 비교가 여전히 유용할 수 있다. 어떤 방식을 쓸지는 도구가 무엇을 하는지 알아야 결정할 수 있다.
외부 API를 호출하는 도구라면 코드의 응답 처리에는 로컬 픽스처를 쓰고, 실제 서비스에는 별도의 통합 테스트를 둘 수 있다. 픽스처를 통과했다고 실서비스 연동이 작동한다는 뜻은 아니며, 실제 호출이 성공해도 픽스처로 시험할 수 있는 모든 실패 사례를 다룬 것은 아니다. 도구가 API와 모델을 모두 사용한다면 비즈니스 API를 모킹해도 테스트 안에서 모델이 실행될 수 있다. MCP 응답 전체를 {"passed": true}로 모킹하면 검증 로직 자체를 시험하지 못할 수도 있다.
MCP에는 도구의 동작을 설명하는 기존 힌트가 있다. readOnlyHint는 도구가 환경을 수정하는지, idempotentHint는 같은 인수를 반복했을 때 환경에 추가 효과가 생기는지, openWorldHint는 외부 개체가 있는 열린 세계와 상호작용하는지, destructiveHint는 파괴적인 업데이트 가능성이 있는지를 나타낸다. 이는 설정과 정리, 반복 실행에 따른 부수 효과를 판단하는 데 도움이 된다. 하지만 멱등성이 출력의 동일성을 뜻하지는 않고, 읽기 전용이라고 모델이 개입하지 않는 것도 아니다. openWorldHint만으로는 비즈니스 API와 호스팅 모델 중 무엇을 호출하는지 구분할 수 없다.
제안하는 추가 정보는 도구가 LLM을 호출하는지, 어떤 외부 API를 호출할 수 있는지다. 이를 단순히 결정론적 도구와 LLM 기반 도구로 나누는 것만으로는 부족하다. 로컬 모델은 외부 API 없이 작동할 수 있고, 모델을 사용하지 않는 실시간 API도 변하는 데이터를 반환할 수 있다. LLM이 없다고 결과가 재현 가능하다는 뜻도 아니다.
자체 웹사이트의 MCP 서버에는 두 도구가 있다. get_company_profile은 Go 프로세스에 이미 있는 데이터를 읽고, submit_project_inquiry는 승인된 소개 요청을 검증한 뒤 접수 기능이 활성화돼 있으면 Mailchimp로 전송한다. 둘 다 LLM을 호출하지 않는다. 글은 문의 도구의 메타데이터를 다음과 같이 제시한다.
{
 "name": "submit_project_inquiry",
 "_meta": {
 "com.santurcesoftware/execution": {
 "schemaVersion": 1,
 "llm": "never",
 "externalApi": "conditional",
 "externalApiProviders": ["mailchimp"]
 }
 }
}
프로필 도구에는 "llm": "never", "externalApi": "never", 빈 제공자 목록을 선언했다. 두 도구의 설명에도 의존성을 적었다. 이 메타데이터는 표준 MCP 주석이 아니라 자체 비공개 확장이다. 일반 클라이언트가 이 키를 이해할 것으로 기대하지 않는다. MCP 유지관리자의 주석 논의는 공통 규약을 제안하기 전에 네임스페이스가 있는 메타데이터로 아이디어를 시험해 볼 수 있다고 권한다.
여기서 외부 API는 별도로 운영되는 하위 서비스에 대한 애플리케이션 수준 요청을 뜻한다. 들어오는 MCP 연결은 포함하지 않으며, 데이터베이스와 원격 측정, 네트워크 트래픽을 모두 열거하는 것도 아니다. 선언은 자체 구현과 알려진 의존성에 관한 것이며, Mailchimp 내부 구현까지 안다는 뜻은 아니다.
도구가 API를 호출할 수 있다는 사실과 특정 테스트에서 실제 호출이 이뤄졌다는 사실은 다르다. 요청은 검증 단계에서 끝날 수 있고, 접수 기능이 꺼져 있거나 로컬 속도 제한에 걸릴 수도 있다. 오류 응답만으로는 외부 호출을 시도했는지 알 수 없으므로, 도구 결과에 다음 관측 정보도 넣었다.
{
 "_meta": {
 "com.santurcesoftware/execution": {
 "schemaVersion": 1,
 "llmInvoked": false,
 "externalApiAttempted": true
 }
 }
}
API 호출 여부는 HTTP 클라이언트가 요청을 시도하기 직전에 설정한다. 전송 오류나 제공자 오류가 나도 값은 true로 유지된다. 다만 이 값은 원격 서비스가 요청을 받거나 처리를 완료했다는 증거는 아니다. 잘못된 인수로 반환된 JSON-RPC 오류에는 이 도구 결과 관측 정보가 포함되지 않는다.
테스트에서는 로컬 모의 제공자를 사용해 보고된 경로와 모의 제공자가 받은 요청을 비교한다. 접수가 비활성화돼 있거나 로컬 속도 제한이 작동하면 호출 시도가 없어야 한다. 제공자가 HTTP 200을 반환해도 승인 응답이 잘못됐다면 테스트는 실패해야 한다. 선언은 테스트 환경을 설정하는 데 쓰이고, 관측 정보는 어떤 경로가 실행됐는지 설명하며, 모의 객체와 단언은 동작을 확인한다. 이 세 가지는 서로 대체할 수 없다.
테스트 하네스는 도구를 찾을 때 이런 필드를 확인할 수 있다. 추론 모델을 사용하지 않는다고 가정한 테스트에서 도구가 모델 사용을 선언하면 그 가정이 명확한 오류로 드러나야 한다. 선언이 없거나 알 수 없는 값이면 LLM을 쓰지 않는 것으로 조용히 간주하지 말고, 알 수 없는 상태로 처리해야 한다. 다음은 자체 필드를 이해하는 클라이언트의 예시이며, 표준 MCP 클라이언트 API가 아니다.
# Illustrative harness policy, not a standard MCP client API.
execution = tool.get("_meta", {}).get(
 "com.santurcesoftware/execution", {}
)
if execution.get("schemaVersion") != 1:
 raise TestConfigurationError("Unknown execution declaration")
if execution.get("llm") != "never":
 raise TestConfigurationError("Suite excludes LLM inference")
if execution.get("externalApi") != "never":
 raise TestConfigurationError("Suite excludes downstream APIs")

# Run behavioural assertions in a controlled environment.
다른 테스트 묶음은 Mailchimp 호출을 허용하고 서버를 모의 엔드포인트에 연결해 요청을 살펴볼 수 있다. 실제 통합 테스트에서는 실제 제공자를 사용할 수 있고, 모델 평가에서는 추론을 허용하되 모델 설정과 평가 기준을 결과와 함께 저장할 수 있다. 핵심은 하네스가 이런 선택을 의식적으로 하게 만드는 것이다.
공유 어휘는 never, conditional, always, unknown에서 시작할 수 있다. 사전 검증 실패와 중첩 의존성을 어떻게 다룰지에 대한 정확한 정의도 필요하다. 자체 서버는 현재 앞의 두 값만 내보낸다. MCP의 클라이언트 매개 샘플링은 일부 추론을 클라이언트에 드러내지만, 서버가 직접 호출하는 제공자도 공개해야 한다. 캐시 적중도 별도로 고려해야 한다. 이번 호출에서 모델을 사용하지 않았다고 해서 반환된 내용이 과거에도 모델 생성물이 아니었다는 뜻은 아니다.
이 필드만으로 검증 알고리즘 전체를 설명할 수는 없다. 소스 코드와 비교 규칙, 픽스처, 모델 설정, 추적 정보가 여전히 필요할 수 있다. 서버가 선언을 잘못할 가능성도 있다. 통제하는 테스트 배포 환경이라면 계측된 클라이언트와 네트워크 제한을 이용해 선언을 확인할 수 있지만, 원격 서비스에 대해서는 해당 서비스의 진술로 남는다.
글은 기존 주석에 LLM 호출과 외부 API, 실제 호출 경로를 설명하는 공통 방식을 더하자고 제안한다. 그래야 테스트 하네스를 구성하고 테스트가 실제로 무엇을 입증하는지 이해하기 쉬워진다는 주장이다.
관련 자료: Janus, Hermes, Ollama로 에이전트 실험실 워크플로 구축하기, Rust와 Langfuse로 AI 워크플로 관찰하기, MCP 에이전트 가이드.
참고 자료: MCP 도구 명세, 위험 어휘로서의 도구 주석, MCP 샘플링 명세.
부록: 원문 예시
result = mcp.call("verify_project_setup", {
 "project_id": project_id,
 "requirements": requirements,
})
assert result["passed"] is True
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요