TL;DR
- Memelang은 매일 수십억 건의 SQL 쿼리를 생성하는 대형 언어 모델(LLM)의 연산 비용을 줄이기 위해, 토큰 수가 적은 중간 표현을 SQL로 변환하는 질의 언어임.
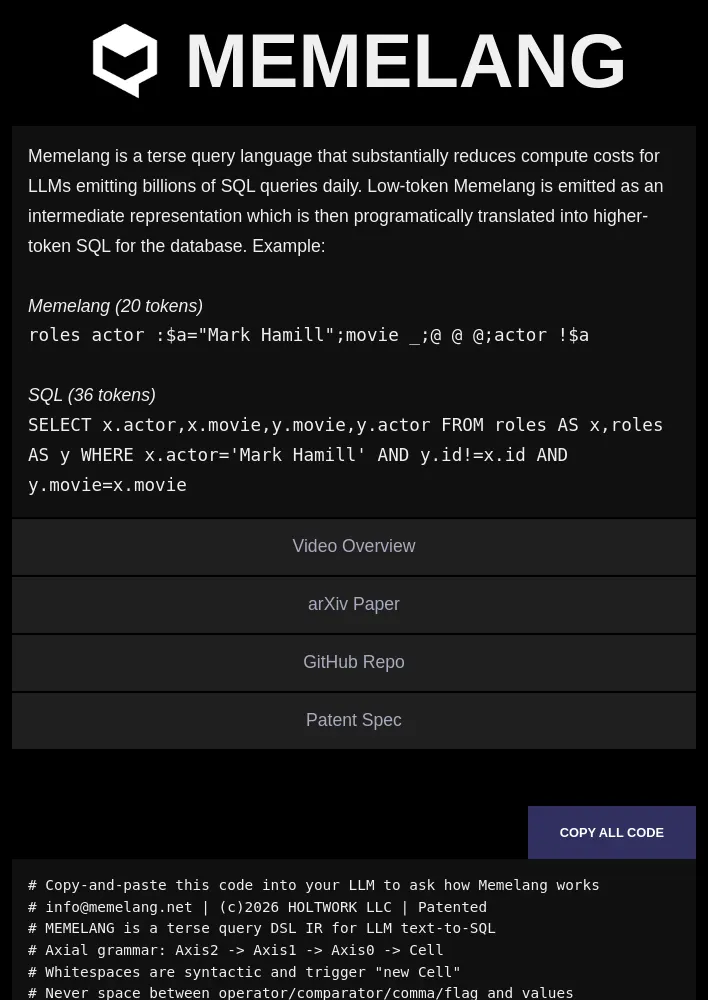
- 예시에서 Memelang 쿼리는 20토큰, 대응하는 SQL은 36토큰으로 제시됨.
- 문법은 공백으로 구분되는 셀과 축 구조를 기반으로 하며, 비교·집계·정렬·변수·관계 참조 등의 표현을 지원함.
- 제공된 파이썬 구현은 질의를 파싱하고 관계 참조를 처리한 뒤, PostgreSQL용 SQL과 매개변수를 생성함.
- 소프트웨어는 개발·테스트·교육 목적으로 무료 이용 가능하며, 상업적 배포와 프로덕션 이용에는 별도 라이선스가 필요함.
Memelang 개요
- Memelang은 LLM이 데이터베이스 질의를 생성할 때 쓰는 간결한 질의 언어이자 중간 표현(IR)임.
- 낮은 토큰 수의 Memelang을 생성한 뒤, 이를 데이터베이스용 SQL로 프로그램 방식으로 변환하는 구조임.
- 예시의 Memelang 질의는
roles테이블에서 Mark Hamill이 연기한 작품을 찾고, 같은 작품에 출연한 다른 배우를 조회하는 내용임. Memelang은 20토큰, 변환된 SQL은 36토큰으로 제시됨. - 자료 목록에는 Video Overview, arXiv Paper, GitHub Repo, Patent Spec이 포함됨.
문법과 질의 표현
- 문법은 축 2 → 축 1 → 축 0 → 셀의 계층 구조임. 공백은 새 셀을 구분하며, 셀 사이에는 세미콜론과 이중 세미콜론을 사용함.
- 셀은 테이블·열·값을 표현하고, 비교 연산자와 값 사이에는 공백을 두지 않는 규칙임. 값으로 문자열·정수·실수·변수·관계 참조·와일드카드를 사용할 수 있음.
- 비교 연산자는
=,!=,>,<,>=,<=,~,!~등을 포함하며, 쉼표로 값을 나열해 OR 조건을 표현함. :min,:max,:cnt,:sum,:avg,:last,:grp,:asc,:des등의 플래그로 집계·그룹화·정렬을 표현함.<=>연산자는 임베딩 기반 유사도 조건을 표현하는 문법 요소임. 제공된 코드의 임베딩 함수는 실제 임베딩 구현을 대신하는 자리표시자임.- 예시 질의는 영화·배우·역할 테이블의 전체 조회, 범위 및 문자열 조건, 정렬, 그룹별 집계, 유사도 조건, 출연 배우 간 관계 조회 등을 다룸.
파이썬 구현과 SQL 생성
- 구현은 정규 표현식으로 토큰을 인식하고, 셀과 축 단위로 질의를 파싱함. 기본 문법 오류와 잘못된 값·관계 참조를 검사함.
- 질의 구조를 직사각형 형태로 맞추고, 상대 참조
@와^를 좌표 변수로 변환하며, 열·테이블·값 슬롯을 배정함. - SQL 생성기는 조건을
WHERE또는HAVING절로 변환하고, 집계·그룹화·정렬을 반영함. 여러 테이블과 별칭을 이용해SELECT및FROM절을 구성함. - 문자열 유사 조건은 PostgreSQL의
ILIKE와NOT ILIKE로 변환하며, 값은 매개변수로 전달하는 구조임. - 조회 시작 위치와 최대 행 수를 지정할 수 있으며, 기본 테이블·열 이름 검증도 포함됨.
라이선스와 특허
- 개발·테스트·교육 목적의 이용은 무료임. 상업적 배포, 재배포 또는 프로덕션 이용에는 별도 라이선스가 필요함.
- 자료에는 HOLTWORK LLC의 저작권 표시와 미국 특허 12,475,098이 기재됨.
- 문의 주소는 info@memelang.net임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요