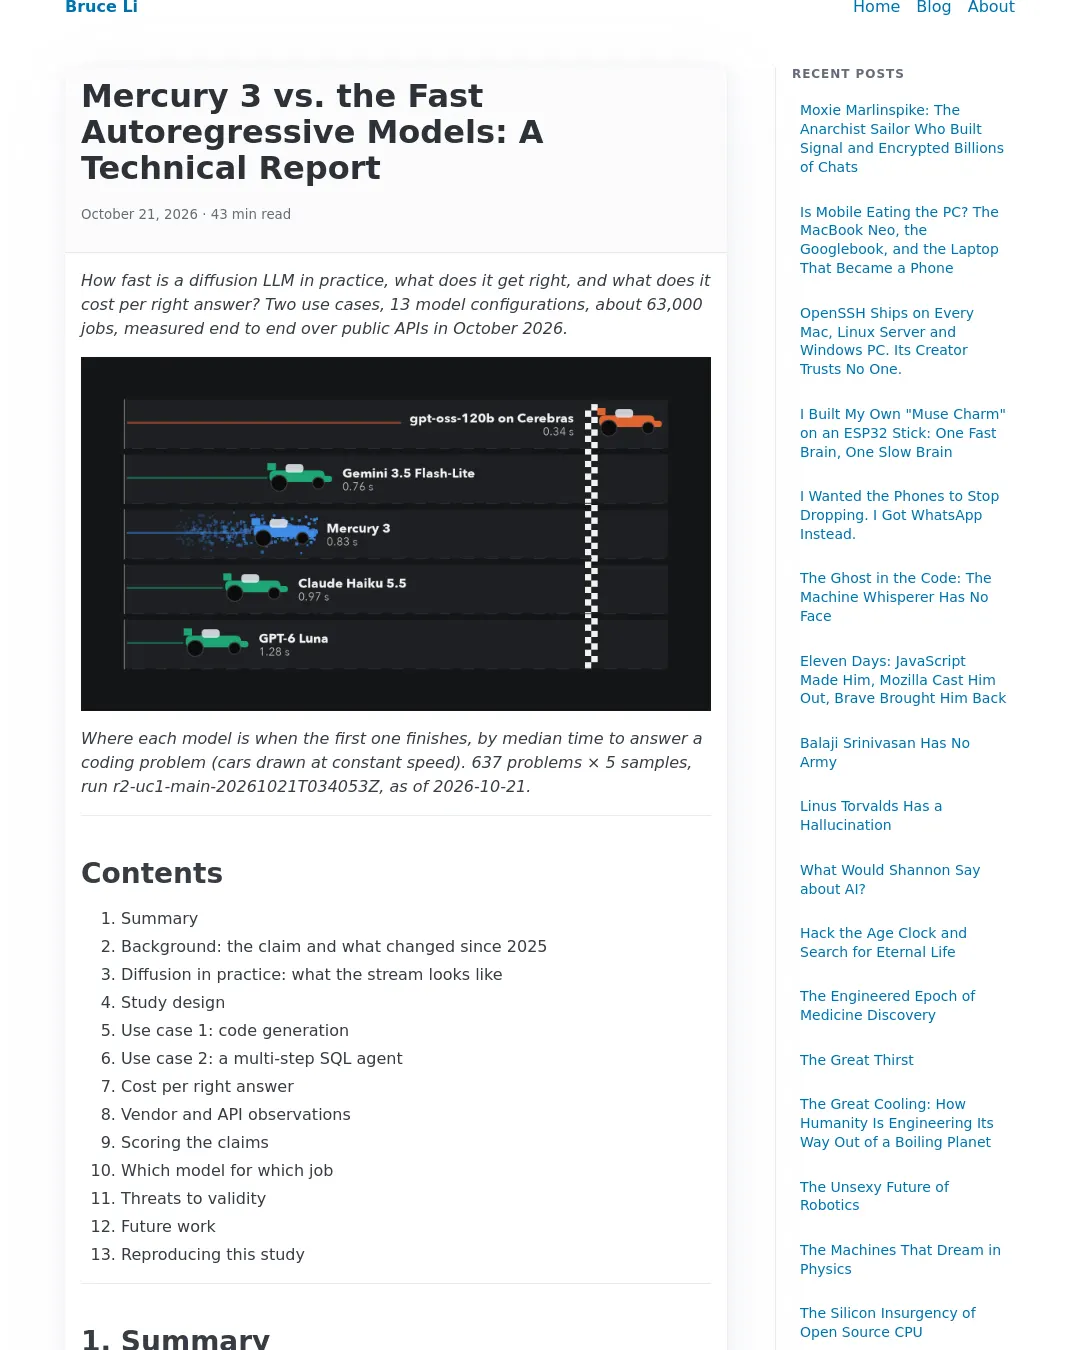
확산형 언어 모델 Mercury 3가 실제 코딩과 SQL 에이전트 작업에서 얼마나 빠르고 정확한지, 정답 하나를 얻는 데 얼마가 드는지를 13개 모델 설정으로 비교한 기술 보고서다. 2026년 10월 공개 API에서 약 6만 3,000건을 실행한 결과, Mercury 3는 주요 연구소의 빠른 모델보다 대체로 빠르지만, Cerebras의 추론 하드웨어에서 실행한 일반 자기회귀 모델은 더 빨랐고, Mercury 3는 추론 강도를 높였을 때 오히려 코딩 정확도가 떨어지는 현상도 보였다.
보고서는 Inception Labs가 2026년 10월 19일 Mercury 3를 출시하며 GPT-6 Luna와 Claude Haiku 5.5보다 우수하고 4~8배 빠르며 초당 1,000토큰 이상을 생성한다고 발표한 주장을 두 작업으로 시험했다. 비교군은 각 주요 연구소의 빠른 모델인 Claude Haiku 5.5, GPT-6 Luna, Gemini 3.5 Flash-Lite와, 특수 추론 하드웨어에서 구동한 일반 자기회귀 모델 gpt-oss-120b(Cerebras)다. 이전 세대인 Mercury 2.5도 포함했다.
핵심 결과는 다음과 같다.
- 코딩 문제 637개에서 Mercury 3
low는 중앙 지연 시간 0.83초, pass@1 86.0%를 기록했다. Claude Haiku 5.5의 추론을 끈 설정(0.97초, 86.1%)과 비슷한 정확도였지만, 가장 빠른 설정은 아니었다. gpt-oss-120b(Cerebras)medium은 0.35초에 84.9%를 기록했다. - Mercury 3의 가시 토큰 생성 속도는 초당 약 850~900토큰이었다. Gemini Flash-Lite의 약 2배, Claude Haiku의 2.8배, GPT-6 Luna의 6배지만, 출력 길이가 길어져도 격차가 더 벌어지지는 않았다. Cerebras의 gpt-oss는 모든 출력 길이에서 Mercury 3보다 약 2.7배 빨랐다.
- Mercury 3는 추론 강도를
low에서medium과high로 올리자 코딩 정확도가 86.0%에서 각각 82.3%, 81.4%로 낮아졌다. 호출의 7.5~8.6%가 32,768토큰 한도까지 추론하고 답을 내놓지 못했다. 다른 모델에서는 이런 한도 초과가 한 번도 없었다. - SQL 에이전트 작업에서 Mercury 3
low는 중앙값 2.05초로 주요 연구소의 빠른 모델보다 1.9~2.8배 빨랐다. 다만 Cerebras 모델은 호출 하나당 1.7배 빠른데도 여러 차례 도구를 호출해야 해 전체 작업 기준 이점은 1.07배로 줄었다. - SQL 에이전트의 정확도는 Claude Haiku가 Mercury 3보다 4~5%포인트 높았고, Cerebras의 gpt-oss는 6~8%포인트 낮았다. 496개 질문 전체의 실행 정확도는 44.7~57.8%였다.
- Mercury 3는 출시 50% 할인 가격을 적용해도 두 작업 모두 정답당 비용이 가장 낮지 않았다. GPT-6 Luna의 추론을 끈 설정이 가장 저렴했다. 도구를 제공한 상태에서 엄격한 JSON 스키마를 요구했을 때 스키마를 어긴 모델도 Mercury 3뿐이었다(150개 작업 중 6개).
2025년 2월 Mercury Coder는 코드 전용 모델이었고 속도 주장은 애니메이션 시연에 근거했다. Mercury 3는 100만 토큰 컨텍스트, instant, low, medium, high 네 가지 추론 강도, 도구 호출과 구조화된 출력을 지원하는 일반 추론 모델로 바뀌었다. 다만 숨은 추론 토큰은 어떤 구조의 모델이든 응답 시간을 늘린다. 한편 Cerebras나 Groq급 특수 하드웨어가 일반 자기회귀 모델을 초당 수천 토큰으로 실행하게 되면서, 속도 비교에 빠른 하드웨어를 쓰는 자기회귀 모델을 대조군으로 넣을 필요가 생겼다.
Inception은 Mercury 3의 컨텍스트 창이 Mercury 2.5의 260K에서 1M 토큰으로 늘었고, 출시 가격은 입력·출력 토큰 100만 개당 0.10달러·0.35달러라고 발표했다. 이는 정가인 0.20달러·0.70달러의 절반이다. 보고서는 공개 API를 통해 2026년 10월 20~22일 미국 서부의 macOS arm64 컴퓨터 한 대에서 표준 API 요금제로 실험했다. 전체 작업은 63,050건, 비용은 Mercury 출시 할인 가격 기준 약 56달러였다. Mercury 사용량 대부분은 Inception의 무료 1억 토큰 크레딧으로 충당됐지만 R4c에서 크레딧을 초과했다.
측정 방법과 확산 스트림
자기회귀 모델은 토큰을 왼쪽에서 오른쪽으로 한 번에 하나씩 출력한다. 확산형 언어 모델은 마스킹되거나 노이즈가 있는 캔버스에서 시작해 한 번에 여러 위치를 다듬는다. Mercury API의 diffusing: true 스트리밍 모드에서는 각 청크가 당시의 전체 텍스트를 담아 답이 점차 구체화되는 모습을 보여준다. 보고서는 이 스트림이 API가 제공하는 시각화이며, Inception의 확인 없이는 내부의 실제 노이즈 제거 과정을 그대로 나타낸다고 볼 수 없다고 단서를 달았다. 지연 시간 측정에는 이 모드를 쓰지 않고 일반 스트리밍을 사용했다.
확산 스트림 실험에서는 2025년 글과 비슷한 다섯 가지 프롬프트(이미지를 좌우·상하·사분면으로 나누기, 흑백 변환, 중앙 자르기)를 Mercury 3 instant와 low에서 각각 세 차례 실행했다. 온도는 0.5, 출력 한도는 4,096토큰이었으며 30회 모두 정상 종료했다. 총비용은 0.0079달러였다.
| 설정 | 프레임 수 | 구간(초) | 최종 글자 수 | 서로 다른 텍스트 길이 | 최종 답에서 멀어진 단계 | 첫 프레임과 최종 답의 유사도 |
|---|---|---|---|---|---|---|
Mercury 3 instant | 8 (6~10) | 0.45 (0.17~2.26) | 3,036 | 5 (4~7) | 2 (1~3) | 0.34 (0.22~0.44) |
Mercury 3 low | 7 (5~11) | 0.34 (0.06~1.00) | 1,849 | 5 (4~7) | 1 (1~3) | 0.18 (0.02~0.55) |
수치는 호출별 중앙값과 범위다. 답은 중앙값 기준 1초보다 짧은 시간에 5~11단계로 완성됐다. 텍스트는 한 번에 고정 크기 캔버스를 채우거나 왼쪽부터 순서대로 늘어나는 것이 아니라, 앞선 블록을 다듬는 동안 몇 차례 길이가 늘었다. 30회 모두 적어도 한 단계에서 최종 문장과의 거리가 직전 단계보다 멀어졌다. 이는 초기에 드러난 토큰을 나중에 바꾸는 재마스킹과 일치한다. low의 첫 프레임은 최종 답과의 유사도가 중앙값 0.18로 instant의 0.34보다 낮았지만, 첫 화면이 추론 뒤에 나온 답의 노이즈에 가까운 탓일 가능성은 시험하지 않았다.
실험 모델은 Mercury 3 네 설정, Mercury 2.5 두 설정, Claude Haiku 5.5(추론 끔·medium), GPT-6 Luna(none·코딩에서만 medium), Gemini 3.5 Flash-Lite(minimal), gpt-oss-120b(Cerebras, low·medium)였다. 모델별 가격은 2026년 10월 20일 기준이다. Mercury는 온도 0.5~1.0만 받으며 범위 밖 값은 1.0으로 조용히 재설정하고 warning 필드를 반환한다. Haiku는 기본값이 아닌 샘플링 설정을 거부했고 Luna의 온도 지원 여부는 시험하지 않아 두 모델은 기본값으로 실행했다. 응답의 warning 필드는 모두 기록하고 확인했다. Gemini는 출력 가격 때문에 추론을 켠 설정을 제외했다. Luna는 OpenAI Chat Completions API에서 추론이 none이 아닐 경우 함수 도구 호출을 거부해 SQL 에이전트 실험에 추론 활성화 설정을 넣지 못했다.
각 호출의 출력 한도는 추론 토큰을 포함해 32,768토큰으로 통일했다. 한도까지 토큰을 쓰고도 답하지 못한 호출은 실패로 계산했다. 시간은 단조 시계로 원시 HTTP 스트림을 측정해 요청 전송, 첫 바이트, 첫 비어 있지 않은 콘텐츠 또는 도구 호출, 마지막 콘텐츠, 완료 시점을 기록했다. TTFT는 첫 콘텐츠가 도착할 때까지의 시간이다. 토큰 수는 청크 수가 아니라 서버가 보고한 사용량을 썼다. 처리량은 숨은 추론 토큰까지 포함한 전체 생성 토큰 기준과, 첫 가시 토큰 뒤의 가시 출력 토큰 기준으로 각각 계산했다.
작업 순서는 모델과 항목 조합별로 무작위화했다. 각 설정의 예열 호출 1회, 재시도한 호출, 60초 넘게 중단된 구간을 가로지른 호출은 지연 시간 통계에서 제외했지만 정확도와 비용에는 포함했다. 정확도 차이는 같은 문제를 쓴 짝지은 부트스트랩으로, 중앙값과 95백분위수는 문제나 질문 단위 부트스트랩 95% 신뢰구간으로 계산했다. 각 공급자는 실행 전과 실행 중 주기적으로 무료 GET /models 요청을 보내 네트워크 기준선을 측정했다. 비용은 고정된 가격표와 서버 보고 사용량으로 다시 계산했다. 생성 코드는 네트워크가 막힌 비루트 Docker 샌드박스에서 자원 제한을 두고 실행했으며 SQL은 시간 제한과 행 수 제한을 둔 읽기 전용 SQLite에서 실행했다.
실행 목록은 다음과 같다. R1 파일럿은 코딩 문제 10개×3회×13개 설정으로 390건, 0.29달러였다. R1b는 Mercury 3의 출력 한도를 네 배로 늘리는 12건 실험으로 0.29달러, OpenAI Fast 모드 비교는 40건에 0.002달러였다. R2 코딩 본 실험은 41,405건에 23.37달러, R3 출력 길이 실험은 630건에 2.03달러였다. SQL 파일럿 세 차례는 488건에 0.73달러, R4 150개 질문 본 실험은 4,500건에 6.42달러, R4c 496개 질문 실험은 14,880건에 21.78달러, R4b 엄격한 JSON 하위 실험은 600건에 0.61달러였다. 2026년 10월 22일 실행한 Mbpp/430 원인 조사 P1은 75건에 0.23달러, 스트림 캡처 R5는 30건에 0.0079달러였다.
모든 주요 실행 R2~R5는 코드 저장소가 깨끗한 상태인지 확인하고 네트워크를 측정한 뒤 시작했다. 연결 시간 중앙값은 모든 공급자에서 12~35ms로 안정적이었다. GET /models의 첫 바이트까지 걸린 시간은 Inception 14~22ms, Cerebras 93~159ms, Google 128~208ms, Anthropic 155~224ms, OpenAI 818~1,816ms였다.
코딩 작업: 빠른 응답과 추론 한도 초과
코딩 실험은 HumanEval+ 164개, MBPP+ 378개, LiveCodeBench v6의 쉬운·중간 난도 95개를 대상으로 했다. EvalPlus 버전은 원본보다 강한 테스트를 사용했다. LiveCodeBench 문제는 AtCoder의 표준 입력 방식과 LeetCode의 함수 방식이며, 대회 날짜는 2025년 1~4월이다. 전체 637개 문제에 설정별 5회씩 실행해 13개 설정에서 41,405회 호출했다. pass@1은 문제별 통과율의 평균이다. LiveCodeBench 문제는 모델의 2026년 중반 학습 기준일보다 오래됐으므로, 오염이 없는 새 데이터가 아니라 모든 모델에 똑같이 노출된 더 어려운 시험으로 취급했다. 실행 전 EvalPlus 정답 542개와 LiveCodeBench 테스트 3,866개에서 채점기를 검증했고, R2에서 하네스 오류는 없었다.
| 설정 | pass@1 (95% 신뢰구간) | 지연 p50 / p95 | 한도 초과 | 통과 답 1,000개당 비용(달러) |
|---|---|---|---|---|
GPT-6 Luna medium | 88.4% (85.9~90.7) | 2.42 / 10.6초 | 0% | 0.19 |
Claude Haiku 5.5 medium | 87.9% (85.4~90.3) | 1.35 / 6.3초 | 0% | 0.26 |
| Claude Haiku 5.5 추론 끔 | 86.1% (83.5~88.6) | 0.97 / 3.4초 | 0% | 0.14 |
Mercury 3 low | 86.0% (83.5~88.5) | 0.83 / 10.4초 | 1.4% | 0.59 / 1.19 |
gpt-oss-120b(Cerebras) medium | 84.9% (82.3~87.4) | 0.35 / 1.7초 | 0% | 0.78 |
GPT-6 Luna none | 83.2% (80.6~86.0) | 1.28 / 9.9초 | 0% | 0.07 |
Mercury 2.5 medium | 83.1% (80.4~85.8) | 3.82 / 9.4초 | 0% | 1.34 |
Gemini 3.5 Flash-Lite minimal | 82.4% (79.5~85.2) | 0.76 / 2.0초 | 0% | 1.03 |
gpt-oss-120b(Cerebras) low | 82.4% (79.6~85.1) | 0.28 / 1.1초 | 0% | 0.49 |
Mercury 3 medium | 82.3% (79.6~84.9) | 1.02 / 51.9초 | 7.5% | 1.59 / 3.18 |
Mercury 3 high | 81.4% (78.6~84.0) | 1.13 / 53.6초 | 8.6% | 1.75 / 3.50 |
Mercury 3 instant | 80.6% (77.9~83.4) | 0.31 / 0.85초 | 0.3% | 0.17 / 0.34 |
Mercury 2.5 low | 76.9% (73.9~79.8) | 1.36 / 3.2초 | 0% | 0.45 |
Mercury 비용은 출시 할인 가격/정가 순서다. gpt-oss medium의 중앙값은 0.345초로, 표와 그래프에 따라 0.35초 또는 0.34초로 표시됐다. 모든 pass@1 신뢰구간의 반폭은 2.6%포인트 이하였고 중앙 지연 시간 신뢰구간의 반폭은 4.5% 이하였다.
Cerebras 대조군은 Mercury 3 low보다 정확도가 약 1%포인트 낮아 신뢰구간상 비슷했지만 중앙 지연 시간은 42%였다. Mercury 3 low는 추론을 끈 Haiku와 정확도가 거의 같고 중앙값은 15% 짧았다. Luna none보다도 정확도가 높았다. 가장 정확한 것은 Luna medium과 Haiku medium이었으며 Mercury 3 설정은 따라잡지 못했다. Mercury 3 자체의 결과도 medium과 high가 low보다 느리고 정확도가 낮아지는 역방향 곡선을 보였다.
| 설정 묶음 | HumanEval+ | MBPP+ | LiveCodeBench v6 |
|---|---|---|---|
Mercury 3 instant / low / medium / high | 88.9 / 92.4 / 90.4 / 88.4 | 77.3 / 81.9 / 82.5 / 82.1 | 79.4 / 91.4 / 67.4 / 66.1 |
Mercury 2.5 low / medium | 89.6 / 93.3 | 74.8 / 81.0 | 63.2 / 74.1 |
Claude Haiku 5.5 추론 끔 / medium | 91.5 / 94.0 | 83.8 / 84.7 | 86.1 / 90.5 |
GPT-6 Luna none / medium | 90.2 / 94.0 | 80.4 / 84.3 | 82.1 / 94.5 |
Gemini 3.5 Flash-Lite minimal | 92.2 | 79.0 | 79.2 |
gpt-oss-120b(Cerebras) low / medium | 91.8 / 92.8 | 79.1 / 81.2 | 78.9 / 86.3 |
수치는 데이터셋별 pass@1(%)다. LiveCodeBench에서 Mercury 3 low는 91.4%였지만 medium은 67.4%, high는 66.1%로 내려갔다. 높은 설정의 LiveCodeBench 호출 475건 중 high는 155건에서 출력 한도를 다 썼고, 오답은 6건뿐이었다. 답을 낼 때는 대체로 맞혔지만 답을 내지 못하는 경우가 많았다.
중앙값만으로는 느린 호출의 영향을 알기 어렵다. Mercury 3 low는 코딩에서 중앙값이 0.83초지만 p95는 10.4초로 Luna의 9.9~10.6초와 비슷했다. 일부 호출에서 추론을 오래 하는 탓이다. Mercury 3 medium과 high의 p95는 52~54초였다. SQL 에이전트에서는 Mercury 3 instant·low와 gpt-oss medium이 대략 90백분위수까지 앞섰다. Gemini는 p95가 6.9초로 이들(8.2~9.6초)보다 짧았지만, 빠르게 끝나는 경우도 드물었다.
출력 길이별 속도 실험은 약 256, 2,000, 8,000개 토큰을 요청하는 프롬프트 각 10개를 세 차례 실행했다. 긴 프롬프트는 약 800줄 프로그램을 요청했다. 최저 추론 설정과 Mercury 3 low의 realtime 플래그 유무를 포함해 630회, 2.03달러를 사용했다.
| 설정 | 짧은 답: TTFT / 전체 | 중간 답: TTFT / 전체 / 가시 토큰·초 | 긴 답: TTFT / 전체 / 가시 토큰·초 | 긴 답 가시 토큰 |
|---|---|---|---|---|
gpt-oss-120b(Cerebras) low | 0.19 / 0.29초 | 0.22 / 1.24초 / 2,471 | 0.23 / 2.71초 / 2,396 | 6,136 |
Mercury 3 instant | 0.29 / 0.30초 | 0.45 / 3.58초 / 902 | 0.46 / 13.5초 / 893 | 10,522 |
Mercury 3 low | 0.57 / 0.58초 | 2.31 / 4.99초 / 880 | 2.54 / 14.5초 / 849 | 8,813 |
Mercury 3 low + realtime | 0.62 / 0.62초 | 2.18 / 4.75초 / 905 | 2.76 / 13.9초 / 866 | 9,167 |
Gemini 3.5 Flash-Lite minimal | 0.75 / 0.95초 | 0.68 / 6.54초 / 444 | 0.73 / 19.3초 / 438 | 8,214 |
| Claude Haiku 5.5 추론 끔 | 0.58 / 0.93초 | 0.63 / 13.9초 / 323 | 0.54 / 46.0초 / 324 | 14,530 |
GPT-6 Luna none | 0.91 / 1.69초 | 0.81 / 17.2초 / 164 | 0.84 / 114초 / 132 | 15,017 |
각 길이 구간의 중앙값이다. 모든 모델에서 출력 길이에 따른 토큰 생성 속도는 거의 일정했다. Mercury 3는 주요 연구소의 빠른 모델보다 디코딩이 2~6배 빨랐지만 이 배율은 긴 출력에서 커지지 않았다. Cerebras는 모든 길이에서 Mercury 3보다 약 2.7배 빨랐다. Mercury 3 instant의 짧은 답은 약 93토큰 전체가 한 블록으로 도착해 전체 시간 0.30초와 TTFT 0.29초가 거의 같았다. low는 첫 가시 블록 전에 추론하므로 TTFT가 작업 길이에 따라 0.57초에서 2.31~2.54초로 늘었다. 중간·긴 프롬프트의 추론 토큰 중앙값은 약 740~940개였고, instant의 TTFT는 0.3~0.5초에 머물렀다.
realtime은 코드에서 측정 가능한 이점이 없었다. TTFT와 디코딩 속도는 모든 구간에서 기본 low와 오차 범위 내에서 같았다. 음성형 작업에서는 차이가 날 수 있지만 이 실험은 확인하지 않았다. 약 800줄을 요청해도 출력 길이는 모델마다 달랐다. Haiku와 Luna는 약 1만 5,000토큰, Mercury는 9,000~10,000토큰, gpt-oss는 약 6,000토큰을 썼다. 따라서 총 소요 시간만으로 모델을 비교하기는 어렵다. R3에서 한도를 다 쓴 27회는 폭주 추론이 아니라 긴 출력이 이 실험의 16,384토큰 한도에 닿은 경우였다(Luna 13회, Mercury 14회). Mercury low의 추론 토큰 중앙값은 약 1,100개였다.
Mercury 3의 한도 초과와 프롬프트 민감성
한도까지 답하지 못하는 현상은 이 실험에서 Mercury 3에만 나타난 가장 두드러진 문제였다.
| 설정 | 호출 수 | 숨은 추론 한도 초과 | 가시 텍스트 폭주 |
|---|---|---|---|
Mercury 3 instant | 3,185 | 0.0% | 0.5% (17회) |
Mercury 3 low | 3,185 | 1.4% (44회) | 0.0% |
Mercury 3 medium | 3,185 | 7.5% (240회) | 0.0% |
Mercury 3 high | 3,185 | 8.6% (275회) | 0.0% |
| 다른 설정 9개 각각 | 3,185 | 0.0% | 0.0% |
‘한도 초과’는 가시 텍스트를 내놓지 않은 채 32,768토큰 한도에서 멈춘 경우다. ‘가시 텍스트 폭주’는 가시 텍스트를 쓰다가 한도에 걸린 경우로, 숨은 추론이 없는 instant에서도 같은 문제를 볼 수 있다. 이 호출들은 R2에서 Mercury 3 출력 토큰 전체의 61%를 소비했고, medium p95 51.9초와 high p95 53.6초를 만들었다. medium·high의 모든 한도 초과는 어려운 문제나 문제 설정이 불분명한 119개 항목에 집중됐다.
파일럿에서 폭주한 두 문제를 최대 131,072토큰, 즉 기본 한도의 네 배로 재실행한 R1b에서는 12회 중 1회만 구제됐다. 그 호출은 36,515토큰에서 수렴했다. 나머지는 원래 한도 안에서 빠르게 수렴하거나 새 한도까지 추론을 이어 갔고, 3~4분씩 걸렸다. 따라서 한도 초과는 한도가 지나치게 낮아서라기보다 어려운 문제에서 추론이 수렴하지 않는 경우가 많았다. 몇 차례 실행이 똑같은 토큰 수 128,982 또는 129,565에서 멈춘 이유는 설명되지 않았다.
- LiveCodeBench
abc388_d에서 Mercury 3high는 숨은 추론에 32,567토큰과 62.2초를 쓴 뒤 답하지 않았다. 같은 문제는low와instant에서 각각 5회 중 5회 풀었고,medium·high에서는 10회 중 0회 풀었다. Claude Haiku, Gemini, Lunamedium, gpt-ossmedium은 각각 5회 중 5회 풀었다. - MBPP/430은 포물선의 준선을 찾는 문제다. 예시 (5, 3, 2 → −198)는 MBPP의 잘못된 참조 공식에 맞지만 교과서 답은 1.5다. 대부분의 자기회귀 설정은 교과서 공식을 써서 실패했다. Claude Haiku
medium은 5회 모두 MBPP 공식으로 통과했으며, 5회 중 2회 답변에서 ‘MBPP 참조’를 언급했다. Mercury 3는medium·high의 10회 전부와low5회 중 4회에서 한도까지 추론했다. arc194_a에서 Mercury 3instant는 숨은 추론 없이 “Key observation…” 같은 가시 분석을 약 138,000자 작성하다 코드를 내놓기 전에 한도에 도달했다.- MBPP/440에서는 부사를 찾으라는 요청에 하드코딩한 단어 목록을 시작했지만 목록을 닫지 못했다. 약 110,000자에 걸쳐 단어를 반복했다. 반복 자체가 확산 모델에만 있는 문제는 아니지만 R2에서 가시 텍스트를 쓰다 한도에 닿은 모델은 Mercury 3
instant뿐이었다.
Mbpp/430을 조사한 P1 실험은 Mercury 3의 각 추론 설정과 Claude Haiku medium에서 세 가지 프롬프트를 각각 5회 실행했다. 원래 프롬프트에서는 Mercury 3 low·medium·high가 15회 모두 한도 초과했고, instant는 5회 중 1회 한도 초과, 4회는 교과서 공식을 썼다. Haiku는 5회 모두 MBPP의 잘못된 공식을 썼고 약 4초가 걸렸다. 예시를 1.5로 고치면 Mercury의 low·medium·high는 한 번도 한도를 넘지 않고 15회 모두 교과서 공식을 냈으며, 0.9~1.2초와 437~594토큰이 들었다. instant도 5회 모두 교과서 답을 냈고 0.6초가 걸렸다. 예시를 없애면 추론 설정은 한도 초과를 피했지만 medium·high는 6,000~11,000토큰(13~21초)을 썼고, low는 ‘준선’을 다른 의미로 해석하는 경우가 많았다. Haiku는 4회 교과서 공식, 1회 잘못된 MBPP 공식을 냈다.
원래 프롬프트에서 Mercury 3는 첫 부분에서 교과서 공식을 도출해 1.5를 얻었지만, 예시의 −198에 맞는 답을 찾으려 약 82,000자 분량의 나머지 추론을 이어 갔다. 잘못된 공식을 찾아내지 못했다. 조사 결과 폭주를 유발한 것은 계산 자체가 아니라 지시와 예시의 모순이었다. 모순을 제거하면 폭주가 사라졌다. Mercury 3가 MBPP 공식을 내놓은 적도 없었으므로 벤치마크 답을 외워서 쓴 것은 아니었다. 이 현상이 확산 구조 때문인지 Mercury의 추론 학습 때문인지는 이 실험으로 구분할 수 없다.
Mercury 3는 Mercury 2.5보다 크게 개선됐다. low에서 pass@1은 76.9%에서 86.0%로 9.1%포인트 높아졌고 중앙 지연 시간은 1.36초에서 0.83초로 짧아졌다. Mercury 2.5 medium은 83.1%로 Mercury 3 low보다 낮았으며 4.6배 느렸다(3.82초).
SQL 에이전트: 호출 속도와 작업 완료
SQL 실험은 분석가가 자연어로 데이터베이스 질문을 하고 에이전트가 스키마를 살펴보며 쿼리를 시험한 뒤 최종 SQL을 제출하는 상황을 재현했다. 모델은 처음부터 데이터 내용을 볼 수 없다. 한 차례 도구 호출마다 모델 왕복이 필요하므로 호출 속도뿐 아니라 필요한 턴 수가 전체 지연을 좌우한다.
데이터는 SQLite 기반 BIRD Mini-Dev다. 배포본은 질문 500개를 싣고 있지만 고유 질문은 498개이며, 정답 쿼리 두 개는 60초 안에 채점할 수 없어 제외했다. R4c는 사용 가능한 496개(쉬움 148, 보통 247, 어려움 101)를 3회씩 10개 설정으로 실행해 14,880개 작업을 만들었다. 앞선 R4는 층화 추출한 150개 질문을 썼고, R4c에서 순위와 속도 비율이 비슷하게 확인됐으며 오차 막대는 약 2.5배 줄었다. 예시 질문은 bird/1380의 “음식에 쓴 돈의 총액은 얼마인가?”이며, 힌트는 SUM(spent)와 category = 'Food'를 알려 준다.
모든 모델에 같은 도구를 제공했다. list_tables, describe_table(name), run_sql(query)는 읽기 전용·시간 제한·행 수 제한을 두고, submit_answer(sql)로 최종 답을 제출하게 했다. 고정된 시스템 프롬프트는 도구로 탐색하고 답변 전에 결과를 확인하며 효율적으로 진행하도록 했고, 최대 턴은 8회였다. 턴당 한도는 32,768토큰, 허용되는 경우 온도는 0.5였다. 도구 호출 없이 답하면 도구를 쓰라는 안내를 한 차례 더 받았다.
실행 정확도(EX)는 제출 쿼리의 결과 행이 정답 결과 행과 중복을 포함해 같아야 통과한다. 정답에 최상위 ORDER BY가 있을 때만 순서를 따졌고 부동소수점은 소수점 여섯 자리로 반올림했다. 공식 BIRD의 집합 동등성 채점도 함께 계산했으며 설정별 차이는 최대 2%포인트였다. 작업 지연 시간은 첫 요청부터 최종 답변까지 측정했고, 로컬 SQL 실행 시간은 작업당 중앙값 7~16ms로 작았다. R4c 추적 기록 14,880개 가운데 14,869개는 바이트 단위로 재생됐다. 나머지 11개는 시간 함수 10개와 ORDER BY RANDOM() 1개처럼 실행마다 결과가 바뀌는 SQL을 썼다.
| 설정 | EX (95% 신뢰구간) | Mercury 3 low 대비 차이 | 평균 턴 | 작업 p50 / p95 | 호출 p50 | 정답 1,000개당 비용(달러) |
|---|---|---|---|---|---|---|
Claude Haiku 5.5 medium | 57.8% (53.6~61.9) | +5.3 (+2.6, +8.1) | 3.4 | 4.37 / 10.68초 | 1.22초 | 1.76 |
| Claude Haiku 5.5 추론 끔 | 56.7% (52.6~60.8) | +4.2 (+1.8, +6.7) | 3.2 | 3.87 / 9.52초 | 1.16초 | 1.55 |
Mercury 3 low | 52.5% (48.5~56.7) | — | 5.1 | 2.05 / 8.69초 | 0.37초 | 1.38 / 2.77 |
Mercury 3 high | 51.6% (47.6~55.6) | −0.9 (−3.0, +1.3) | 5.4 | 2.60 / 12.33초 | 0.44초 | 1.82 / 3.64 |
Mercury 3 medium | 51.5% (47.4~55.5) | −1.0 (−2.8, +0.9) | 5.4 | 2.32 / 10.56초 | 0.40초 | 1.68 / 3.35 |
Gemini 3.5 Flash-Lite minimal | 51.2% (47.2~55.2) | −1.3 (−4.2, +2.0) | 6.6 | 4.44 / 6.94초 | 0.63초 | 6.46 |
GPT-6 Luna none | 50.9% (46.8~55.2) | −1.5 (−4.2, +1.1) | 4.9 | 5.69 / 10.61초 | 1.13초 | 0.77 |
Mercury 3 instant | 50.2% (46.2~54.4) | −2.3 (−4.4, −0.2) | 5.5 | 2.00 / 8.18초 | 0.36초 | 1.70 / 3.39 |
gpt-oss-120b(Cerebras) low | 46.2% (42.1~50.0) | −6.3 (−9.3, −3.3) | 6.3 | 1.92 / 7.04초 | 0.22초 | 5.43 |
gpt-oss-120b(Cerebras) medium | 44.7% (40.6~48.9) | −7.8 (−10.8, −4.7) | 6.6 | 2.39 / 9.63초 | 0.26초 | 7.07 |
EX는 496개 질문 각각에서 세 번 실행한 통과율의 평균이다. 짝지은 차이는 같은 질문을 대상으로 부트스트랩했다. Mercury 비용은 할인 가격/정가 순서다. R4c는 14,880개 작업에 총 21.78달러를 썼으며 Mercury 정가를 적용하면 26.80달러다.
주요 연구소의 빠른 모델보다 Mercury 3의 호출 속도가 전체 작업으로 이어져 작업당 1.9~2.8배 빨랐다. Haiku는 호출당 3.2배 느렸지만 약 3.2턴만 써 작업 기준으로는 1.88배 느렸다. Gemini는 호출당 격차가 1.69배였지만 한 번에 표 하나씩 탐색해 6.6턴이 필요했고 작업 기준으로 2.16배 느려졌다. Cerebras의 gpt-oss low는 호출당 1.7배 빨랐지만 6.3턴을 써 작업당 이점은 1.07배뿐이었다. medium은 작업 기준으로 Mercury 3보다 느렸다. 이 속도 비율은 150개 질문 R4와도 수백분의 몇 정도 차이만 났다.
정확도에서는 Haiku가 Mercury 3 low보다 medium에서 5.3%포인트, 추론을 끈 설정에서 4.2%포인트 앞섰다. Cerebras의 gpt-oss는 각각 6.3%, 7.8%포인트 뒤졌다. gpt-oss는 답을 도구로 제출하는 대신 글로 쓰는 경우가 많았다. Mercury 3 instant는 low보다 2.3%포인트 낮았고 차이의 상한은 −0.2%포인트였다. Luna, Gemini, Mercury 3 medium·high는 low와 통계상 비슷했다. 코딩과 마찬가지로 Mercury 3의 추론 강도를 높여도 정확도가 오르지 않았다.
쉬움·보통·어려움 순 실행 정확도는 Haiku medium 70/55/48%, Haiku 추론 끔 68/53/48%, Mercury 3 low 65/48/45%, Gemini 69/48/34%, Luna 65/48/38%, Mercury 3 instant 64/48/36%, gpt-oss low 59/44/32%였다. Claude를 제외한 모델 가운데 Mercury 3 low가 어려운 문제에서 가장 높은 점수를 냈다. 다만 BIRD 정답 라벨에는 잘못됐거나 모호한 사례가 있었다. 10개 질문 파일럿에서 모든 모델이 실패한 세 문제를 살펴보니 조인 경로가 이상하거나 질문이 요구한 ID를 정답 쿼리가 반환하지 않거나 내부 조인과 왼쪽 조인의 차이가 있는 라벨 문제였다. 이는 모든 모델의 절대 EX를 낮추지만 같은 질문을 비교하는 모델 간 차이에는 영향을 주지 않는다.
| 설정 | 답 제출 | 턴 한도 | 토큰 한도 | 도구 호출 수 | 유효 호출 | 잘못된 SQL | 형식 오류 작업(복구됨) |
|---|---|---|---|---|---|---|---|
| Claude Haiku 5.5 추론 끔 | 99.7% | 0.3% | 0.0% | 6,408 | 100% | 1.8% | 1 (0) |
Claude Haiku 5.5 medium | 99.6% | 0.4% | 0.0% | 6,831 | 100% | 1.9% | 0 |
GPT-6 Luna none | 98.4% | 1.6% | 0.0% | 8,374 | 100% | 0.7% | 0 |
Mercury 3 low | 95.7% | 4.0% | 0.3% | 9,733 | 100% | 1.6% | 0 |
Mercury 3 medium | 90.8% | 9.2% | 0.0% | 10,586 | 100% | 1.1% | 0 |
Mercury 3 high | 89.7% | 10.1% | 0.1% | 11,160 | 99.99% | 0.8% | 1 (0) |
Mercury 3 instant | 89.2% | 9.1% | 1.7% | 10,309 | 99.99% | 2.4% | 6 (3) |
gpt-oss-120b(Cerebras) low | 85.7% | 14.3% | 0.0% | 8,397 | 100% | 3.4% | 773 (691) |
gpt-oss-120b(Cerebras) medium | 74.9% | 25.0% | 0.0% | 9,646 | 100% | 0.9% | 140 (106) |
Gemini 3.5 Flash-Lite minimal | 71.1% | 28.8% | 0.0% | 10,177 | 99.24% | 1.1% | 77 (40) |
유효 호출은 알려진 도구를 사용하고 JSON 인수가 스키마에 맞는 경우다. 잘못된 SQL은 SQLite 오류를 반환한 run_sql 호출이다. 형식 오류는 도구 호출 없이 답하거나 잘못된 도구 호출을 한 경우이며, 괄호 안 숫자는 그래도 작업이 답변 제출까지 완료된 경우다. Gemini를 제외하면 모든 설정에서 스키마에 맞는 도구 호출 비율은 99.99% 이상이었다. 차이는 8턴 안에 답을 마치고 submit_answer를 호출하는지에 있었다. 턴 제한에 걸린 작업도 대부분 같은 쿼리를 반복하기보다 탐색 중이었다. 탐색 대 쿼리 반복은 Gemini 392 대 37, gpt-oss medium 327 대 35, Mercury 3 instant 116 대 19였다.
사례를 보면 Mercury 3 instant는 bird/866에서 경주 161의 0:01:27 랩 기록을 낸 운전자를 묻는 질문을 받았다. 힌트의 패턴이 여러 운전자의 82개 랩에 해당하고 정확히 일치하는 결과는 없다는 점을 찾았지만, 한 명의 답을 기대하며 6번째 턴에서 “Let me reconsider…”를 93번 반복하는 가시 추론을 이어 가다 32,768토큰 한도에 걸렸다. 약 127,000자와 54초가 들었다. Mercury 3 instant·low 작업 2,976개 가운데 31개가 토큰 한도에 걸린 턴으로 끝났고, 자기회귀 모델에는 이런 경우가 없었다. gpt-oss low는 bird/824의 정답 SQL을 찾아 결과도 정답 행과 같게 만들었지만, 두 차례 submit_answer 대신 JSON 텍스트로 답을 써 안내를 무시하고 턴을 소진했다. Gemini는 bird/240에서 describe_table을 턴마다 한 번씩 네 번 호출하고 읽기 전용 샌드박스가 거부하는 명령까지 시도했다. 7번째 턴에 올바른 쿼리를 찾았지만 8번째 턴에 변형 쿼리를 다시 실행해 제출하지 못했다. Gemini는 작업의 28.8%에서 턴 한도에 걸렸다.
엄격한 구조화 출력 하위 실험은 submit_answer 도구 대신 response_format: json_schema로 최종 답을 쓰게 하되 탐색용 도구는 남겼다. R4의 150개 질문을 모델별 최저 설정에서 한 번씩 실행했다. Cerebras의 gpt-oss는 도구와 response_format을 함께 쓰는 요청을 거부해 제외했다.
| 설정 | EX (95% 신뢰구간) | 답 제출 | 턴 한도 | 스키마 위반 | 턴 수 | 작업 p50 |
|---|---|---|---|---|---|---|
| Claude Haiku 5.5 추론 끔 | 53.3% (45.3~61.3) | 100% | 0% | 0 | 1.0 | 1.43초 |
Gemini 3.5 Flash-Lite minimal | 53.3% (45.3~62.0) | 78.7% | 21.3% | 0 | 6.4 | 4.61초 |
Mercury 3 instant | 53.3% (44.7~61.3) | 83.3% | 12.7% | 6 (4.0%) | 5.2 | 1.72초 |
GPT-6 Luna none | 52.0% (44.0~60.0) | 96.7% | 3.3% | 0 | 4.9 | 5.38초 |
R4b는 600건, 0.61달러였다. Mercury 3는 150개 작업 중 6개에서 엄격한 스키마를 어겼다. 네 답변은 유효한 JSON 뒤에 내부 도구 호출 템플릿처럼 보이는 </|inc_tool_call_ml|parameter>를 붙였고, 하나는 </로 끝났으며 하나는 비어 있었다. 다른 모델은 위반이 없었다. 이 방식에서 Haiku는 도구 호출 없이 150개 작업 모두 첫 턴에 답을 냈다. 질문과 힌트만 보고 SQL을 작성해 EX는 53.3%였으며, 같은 질문에서 탐색을 허용한 R4의 58.9%보다 낮았다.
비용, API 관찰과 주장 검토
토큰 가격만으로는 정답 비용을 알기 어렵다. 모델마다 추론·출력의 토큰 수와 도구 턴 수가 다르기 때문이다. 보고서는 예열 및 재시도를 포함한 전체 지출을 성공한 답의 수로 나눴다. 표의 Mercury 비용은 할인 가격/정가 순서다.
| 설정 | 코딩 통과 답 1,000개당 달러 | SQL 정답 작업 1,000개당 달러 |
|---|---|---|
GPT-6 Luna none | 0.07 | 0.77 |
| Claude Haiku 5.5 추론 끔 | 0.14 | 1.55 |
Mercury 3 instant | 0.17 / 0.34 | 1.70 / 3.39 |
GPT-6 Luna medium | 0.19 | — |
Claude Haiku 5.5 medium | 0.26 | 1.76 |
Mercury 2.5 low | 0.45 | — |
gpt-oss-120b(Cerebras) low | 0.49 | 5.43 |
Mercury 3 low | 0.59 / 1.19 | 1.38 / 2.77 |
gpt-oss-120b(Cerebras) medium | 0.78 | 7.07 |
Gemini 3.5 Flash-Lite minimal | 1.03 | 6.46 |
Mercury 2.5 medium | 1.34 | — |
Mercury 3 medium | 1.59 / 3.18 | 1.68 / 3.35 |
Mercury 3 high | 1.75 / 3.50 | 1.82 / 3.64 |
Mercury 정가는 입력·출력 100만 토큰당 0.20달러·0.70달러로 Haiku와 Luna(0.10달러·0.50달러)보다 높다. 50% 할인 가격은 입력 가격이 같고 출력은 0.35달러다. Mercury 3 medium·high는 답을 내지 않는 호출에 약 32,000토큰을 써 코딩 정답당 비용이 가장 높았다. 에이전트는 매 턴 대화 기록을 다시 보내므로 입력 토큰도 쌓인다. 턴 수가 많은 gpt-oss와 Gemini는 입력 가격까지 높아 정답 1,000개당 5.43~7.07달러였다. Anthropic은 명시적 cache_control 표식이 있어야 캐시하므로 이번 실험의 Haiku 캐시 적중률은 0%였다. Gemini의 OpenAI 호환 엔드포인트는 캐시 토큰을 보고하지 않았다. 운영 환경에서 캐시를 적절히 설정하면 두 모델의 비용은 더 낮아질 수 있다.
Mercury 3는 출시 할인 가격에서도 정답당 비용이 중간권이고 정가에서는 대략 두 배가 된다. SQL 에이전트에서 Mercury 3 low는 할인 가격 1.38달러로 Luna 다음이었지만, 정가 2.77달러에서는 추론을 끈 Haiku(1.55달러)가 모든 Mercury 설정보다 저렴했다. 토큰당 가격이 낮다고 정답당 비용도 낮은 것은 아니다.
공급자 API를 함께 운용한 결과 OpenAI의 첫 토큰 지연은 모델 실행 전 단계에서 컸다. 인근 CDN을 거친 연결은 약 20ms, TLS는 약 40ms였지만 OpenAI의 무료 GET /v1/models 요청은 서버 처리에 814~1,209ms가 걸렸다. 다른 공급자는 같은 점검에 14~224ms였다. 실제 요청의 openai-processing-ms 중앙값은 596ms였다. OpenAI는 사용 등급이 속도가 아닌 한도와 요청량을 바꾼다고 문서화하지만, Fast 모드가 도움이 되는지 확인하려고 짧은 프롬프트 20개를 표준 등급과 가격 2배인 Fast 모드(service_tier: "fast")에서 무작위 순서로 한 번씩 실행했다.
| 등급 | TTFT p50 | TTFT p90 | 최악 TTFT | 서버 처리 p50 | 전체 p50 |
|---|---|---|---|---|---|
| Standard | 0.825초 | 1.522초 | 6.85초 | 596ms | 1.402초 |
| Fast (가격 2배) | 0.668초 | 0.889초 | 1.80초 | 450ms | 0.967초 |
40회, 0.0022달러의 비교에서 Fast 모드는 프롬프트 20개 중 13개에서 빨랐고 중앙 지연 시간은 0.146초 줄었다. 가장 큰 변화는 최악 지연이 6.85초에서 1.80초로 줄어든 점이다. Fast 모드에서도 첫 토큰 전에 서버에서 약 450ms가 걸렸다. 본 실험은 모든 공급자에서 표준 등급만 사용했다.
Cerebras에서는 R2의 921회 호출이 재시도를 필요로 했고, 이 가운데 765회는 429 오류였다. 클라이언트가 문서상 분당 1,000회 요청 한도 아래였는데도 제한이 발생했다. 재시도 호출은 지연 통계에서 제외했으므로 Cerebras 속도는 설정별 3,185회 중 제한을 받지 않은 약 2,800회에 해당한다. 속도는 실제로 빨랐지만 요청 제한도 있었다.
Mercury API는 온도 0.5~1.0 밖의 값을 1.0으로 재설정하고 최상위 warning 필드에만 알린다. 이를 확인하지 않는 벤치마크는 다른 온도로 조용히 실행될 수 있다. 5토큰 답변이 3개 청크로 도착하는 등 스트림 청크는 토큰과 일치하지 않으므로 처리량은 서버 사용량으로 계산해야 한다. max_completion_tokens 기본값은 instant의 8,192에서 high의 131,072까지 추론 강도에 따라 달라지며, 문서마다 기본 추론 강도 설명도 달라 두 값을 명시하는 편이 필요하다. 도구 호출과 같은 턴에 짧은 텍스트를 먼저 내보낼 수 있어 에이전트는 둘을 모두 받아야 한다. seed를 지원하지 않아 비트 단위 재현이 불가능하므로 반복 샘플과 신뢰구간을 사용했다.
Luna는 Chat Completions에서 함수 도구와 reasoning_effort가 none이 아닌 설정을 함께 쓰면 Responses API를 가리키는 400 오류를 반환했다. 보고서는 두 번째 어댑터를 만들기보다 해당 설정을 제외했다. Gemini의 OpenAI 호환 엔드포인트는 병렬 도구 호출을 각 호출이 index 0으로 통째로 오거나 "index": null로 오는 이례적인 형식으로 스트리밍했다. 초기 스트림 조립기가 두 호출을 하나로 합쳐 대화 기록을 훼손했지만, 본 실험 전에 수정하고 회귀 테스트를 추가했다. Gemini API는 추론 토큰과 캐시 토큰 정보를 제공하지 않는다. OpenAI는 잔액 부족을 요청 제한과 같은 HTTP 429(insufficient_quota)로 표시하므로 429를 무조건 재시도하는 클라이언트는 결제 문제에서 무한 반복할 수 있다. Cerebras의 gpt-oss 요청은 프롬프트에 고정 토큰 약 64개를 더하며 low에서도 추론 토큰을 조금 쓴다. BIRD Mini-Dev에는 중복을 제외한 질문 498개가 있고 정답 쿼리 두 개는 60초 내에 채점할 수 없었다.
Inception의 네 가지 주장을 실험 결과와 대조하면 다음과 같다.
| 주장 | 측정값 | 평가 |
|---|---|---|
| 초당 1,000토큰 이상, NVIDIA GPU에서 1,068토큰 | 네트워크를 거쳐 첫 가시 토큰 뒤에 잰 약 850~900 가시 토큰/초 | 근접했다. 클라이언트 측 측정에는 스트리밍과 네트워크 지연이 들어가 서버 측 수치와 직접 같지는 않다. |
| GPT-6 Luna와 Claude Haiku 5.5보다 4~8배 빠름 | 디코딩은 Luna보다 약 6배, Haiku보다 2.8배 빠르다. 비슷한 정확도의 코딩 답변 중앙 시간은 1.2~1.5배, 에이전트 작업은 1.9~2.8배 빠르다. | Luna와 비교한 디코딩에서는 맞지만 Haiku와 비교하면 작고, 사용자가 기다리는 전체 시간에서는 더 작다. |
| Luna와 Haiku보다 우수함 | 코딩에서 Haiku 추론 끔과 86.0% 대 86.1%로 비슷하고 Luna none 83.2%보다 높지만, 두 모델의 추론 설정 88.4%와 87.9%보다 낮다. 에이전트에서는 Luna와 비슷하고 Haiku보다 4~5%포인트 낮다. | 일부만 맞다. 코딩에서 추론을 끈 설정과 경쟁하지만 최고 성능보다 앞서지 못하며 에이전트에서는 Haiku에 뒤진다. |
| 속도는 확산 구조에서 비롯됨 | Cerebras의 gpt-oss-120b가 두 작업에서 더 빨랐고 디코딩도 약 2.7배 빨랐다. | 확인되지 않았다. 모델뿐 아니라 서빙 하드웨어와 구성까지 함께 비교했기 때문이다. |
특수 하드웨어 대조군이 있어 마지막 주장을 좁힐 수 있었다. 이 모델이 없었다면 서브초 응답을 만드는 유일한 방법이 확산 구조라고 결론 내릴 수 있었다. 실험 결과는 Inception이 일반적인 것으로 추정되는 GPU에서 주요 연구소의 빠른 모델보다 앞설 수 있지만, 특수 하드웨어는 일반 자기회귀 모델을 더 빠르게 만들 수 있다는 데 그친다.
작업별 선택을 보고서는 다음처럼 제안한다. 반응성이 우선인 대화형 코딩에는 gpt-oss-120b(Cerebras) medium이 0.34초에 84.9%를 기록했고, 정확도를 약간 더 원한다면 Mercury 3 low가 0.83초에 86.0%였다. 코드 정확도가 우선이면 Luna medium(2.42초, 88.4%) 또는 Haiku medium(1.35초, 87.9%)이 낫다. 코딩 정답당 비용은 Luna none(1,000개당 0.07달러), Haiku 추론 끔(0.14달러) 순으로 낮았다. Mercury 3에서는 코드에 low, 최소 지연 시간에는 instant를 고려하고 medium·high는 피하라고 보고서는 권했다. 이 두 설정은 한도 초과가 7.5%·8.6%, p95 지연이 52~54초였다.
약 8,000토큰의 긴 파일을 생성할 때 원시 처리량은 Cerebras gpt-oss가 초당 2,396토큰, Mercury 3 instant가 893토큰, Haiku가 324토큰이었다. 다단계 도구 에이전트에서 지연 시간 우선이라면 Mercury 3 low·instant의 작업 중앙값은 2.05초·2.00초였고, gpt-oss low는 1.92초였지만 턴 한도 초과가 14.3%이고 정확도가 6.3%포인트 낮았다. 에이전트 정확도가 우선이면 Haiku는 추론을 끈 설정만으로도 56.7% EX와 3.87초 작업 시간을 기록해 Mercury 3 low보다 4.2%포인트 높았다. 도구를 제공한 엄격한 JSON 출력에는 Mercury 3를 피하라고 제안했다. 150개 중 6개에서 스키마 위반이 있었다. 에이전트 정답당 비용은 Luna none 0.77달러, 할인 가격 Mercury 3 low 1.38달러, 정가 기준 Haiku 추론 끔 1.55달러 순이었다. 이 판단은 2026년 10월 21일의 R2, R3, R4c, R4b 결과에 근거한다.
보고서는 결과 해석에 다음 한계를 둔다. 측정 대상은 순수 모델 구조가 아니라 공급자 하드웨어·배치 처리·네트워크 경로·API 게이트웨이를 포함한 제품이다. Cerebras 대조군은 Mercury의 우위 중 서빙만으로 설명할 수 있는 범위를 제한하지만 확산 구조를 따로 분리하지는 않는다. 모든 실행은 하루 동안 미국 서부의 호스트 한 대에서 이뤄졌다. 네트워크 측정은 클라이언트 네트워크가 주된 원인임을 배제하지만 공급자 부하는 통제하지 못한다. LiveCodeBench는 학습 기준일 이전 데이터이고, SQL 설정별 정확도 오차는 약 ±4%포인트다. 같은 질문을 비교한 짝지은 차이의 오차는 ±2~3%포인트다. R4c의 마지막 약 2,900개 작업은 다른 공급자 실행이 끝난 뒤 Mercury만 실행했으므로 같은 시간대 비교는 아니지만 작업별 지연 시간에는 영향을 주지 않는다. BIRD 라벨은 불완전하고 Mercury 비용은 정가에서 두 배가 된다. Mercury는 시드를 지원하지 않아 비트 단위 재현이 불가능하다. 모델마다 하나의 고정 프롬프트만 사용했으며 개별 모델에 맞춘 프롬프트는 시험하지 않았다. 32,768토큰 공통 한도는 Mercury medium·high의 자체 기본값보다 낮지만, 12회만 시험한 R1b에서는 이를 올려도 대체로 문제가 해결되지 않았다. Gemini의 OpenAI 호환 API는 추론 토큰을 보여주지 않아 가시 토큰과 추론 토큰의 구분을 알 수 없다.
추가 연구 과제로는 여러 지역과 시간대에서의 실행, Cerebras·Groq급 하드웨어에서 Mercury 구동, 이번 실험에서 제외한 Mercury Edit의 코드 편집, 실시간·음성형 작업에서 realtime 플래그 측정, 확산 모델의 역방향 추론 조절 가능성, Luna Responses API 어댑터를 통한 추론 활성화 에이전트 설정, 모든 공급자에 대한 프롬프트 캐싱 비교를 제시했다. LLaDA 연구는 확산 모델이 왼쪽에서 오른쪽으로 처리하는 모델에 어려운 역전 과제를 잘 다룰 수 있다고 제안했지만, 상용 모델에서 확인할 필요가 있다.
재현 자료
실험 하네스, 각 실행 설정, 채점 샌드박스, 분석 코드와 그래프·표 생성 스크립트는 GitHub 저장소에 공개됐다. 재현 절차는 다음 명령으로 안내한다.
uv sync # Python 3.12
make check # lint, types, offline tests (no API calls)
uv run dllm-eval fetch-data # download and checksum the datasets
uv run dllm-eval run configs/experiments/r2_uc1_main.yaml --dry-run # cost estimate, no spend
uv run --env-file .env dllm-eval run configs/experiments/r2_uc1_main.yaml --live
uv run dllm-eval score <run_id> # grade in Docker (UC1) or score EX (UC2)
uv run dllm-eval report # rebuild every chart and table
원시 로그는 추가만 가능한 형식으로 저장되며 비밀 정보는 가린 요청·응답·시간·서버 사용량·모델 ID·Git 커밋을 기록한다. 분석은 오프라인에서 실행돼 API 호출 없이 실행 디렉터리로 그래프와 표를 다시 만들 수 있고, 연속 두 번의 생성 결과는 바이트 단위로 같았다. 실시간 실행은 Git 작업 트리가 깨끗하지 않으면 거부해 어떤 코드로 실행했는지 남긴다. 각 그림에는 실행 ID, 커밋, 모델 ID, 서비스 등급, 클라이언트 지역, 가격표 날짜와 기준일이 붙는다. HumanEval+·MBPP+는 EvalPlus, LiveCodeBench, BIRD Mini-Dev의 데이터는 각 소유자의 라이선스를 따르며 공식 출처에서 내려받고 저장소에 재배포하지 않는다. 코드는 MIT 라이선스다.
수치의 출처는 2026년 10월 20~22일 실행한 UC1 파일럿 r1-pilot-uc1-20261021T020019Z, 출력 한도 실험 r1b-cap-probe-20261021T021543Z, 직접선 조사 p1-directrix-probe-20261022T155049Z, OpenAI Fast 모드 시험 oai-priority-ab-20261021T033428Z, 코딩 실험 r2-uc1-main-20261021T034053Z, 출력 길이 실험 r3-uc1-length-20261021T152238Z, SQL 파일럿 r4-uc2-main-20261021T165313Z, 전체 496개 SQL 질문 실험 r4c-uc2-full-20261021T214456Z, 엄격한 JSON 실험 r4b-uc2-strict-20261021T170547Z, 확산 캡처 r5-diffusion-capture-20261021T181518Z다. 가격 기준일은 2026년 10월 20일이며, 모든 실행은 미국 서부의 macOS arm64 호스트 한 대에서 표준 API 요금제로 진행됐다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요