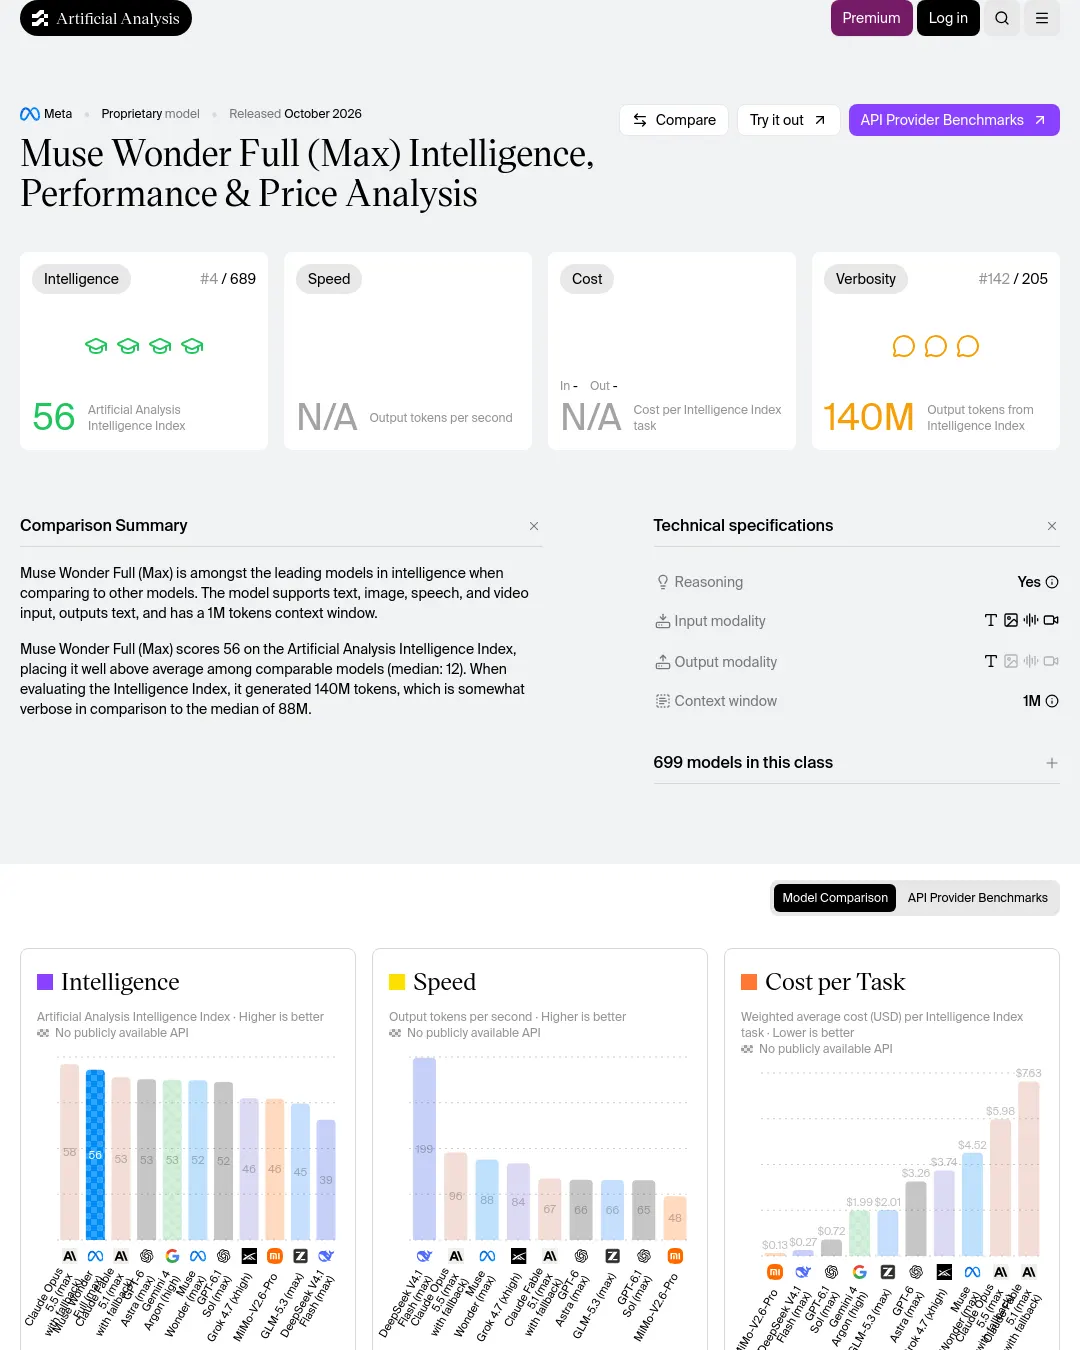
Muse Wonder Full (Max)은 Artificial Analysis Intelligence Index에서 56점을 받았다. 같은 가격대의 비교 대상 모델 중앙값은 12점이다.
메타가 만든 추론 모델을 Artificial Analysis가 평가한 결과다. 텍스트·이미지·음성·영상 입력을 지원하고 텍스트를 출력한다. 여러 입력 유형을 함께 다루는 모델을 찾는다면 결과를 살펴볼 만하지만, 점수만으로 실제 작업 성능을 단정하기는 어렵다.
어떤 평가인가?
Artificial Analysis Intelligence Index는 여러 과제를 묶어 모델의 역량을 비교하는 종합 지표다. 여러 시험을 모은 성적표에 빗대면 쉽다. 이번 버전 4.3.2에는 AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience, AA-LCR v1.1 등 10개 평가가 포함됐다. 평가 방법에서 세부 내용을 확인할 수 있다.
Artificial Analysis에 따르면 Muse Wonder Full은 해당 가격대의 추론 모델 중앙값 12점보다 높은 56점을 기록했다. 다만 지표가 측정하는 것은 여러 평가의 종합 결과이며, 특정 업무에서의 성능을 그대로 보장하지 않는다.
평가 과정에서 모델은 출력 토큰 1억 4000만 개를 생성했다. 같은 비교군의 중앙값인 8800만 개보다 많아, 평가 과제를 풀 때 출력이 다소 길었다. 모델의 지능 점수와 별도로 토큰 사용량도 살펴볼 이유다.
모델은 100만 토큰의 문맥 창을 지원하며, 입력은 텍스트·이미지·음성·영상이고 출력은 텍스트다. 가중치는 공개되지 않은 독점 모델이다. Artificial Analysis 페이지에는 공개 API가 없다고 표시돼 있으며, 제공 업체 목록에서 이용 가능 여부를 확인할 수 있다(제공 업체).
실제로 도입을 검토한다면 지원 업체의 API 제공 여부와 가격을 먼저 확인해야 한다. Artificial Analysis 페이지는 속도와 작업별 비용을 공개하지 않으며, 메타는 모델 크기와 매개변수 수도 공개하지 않았다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요