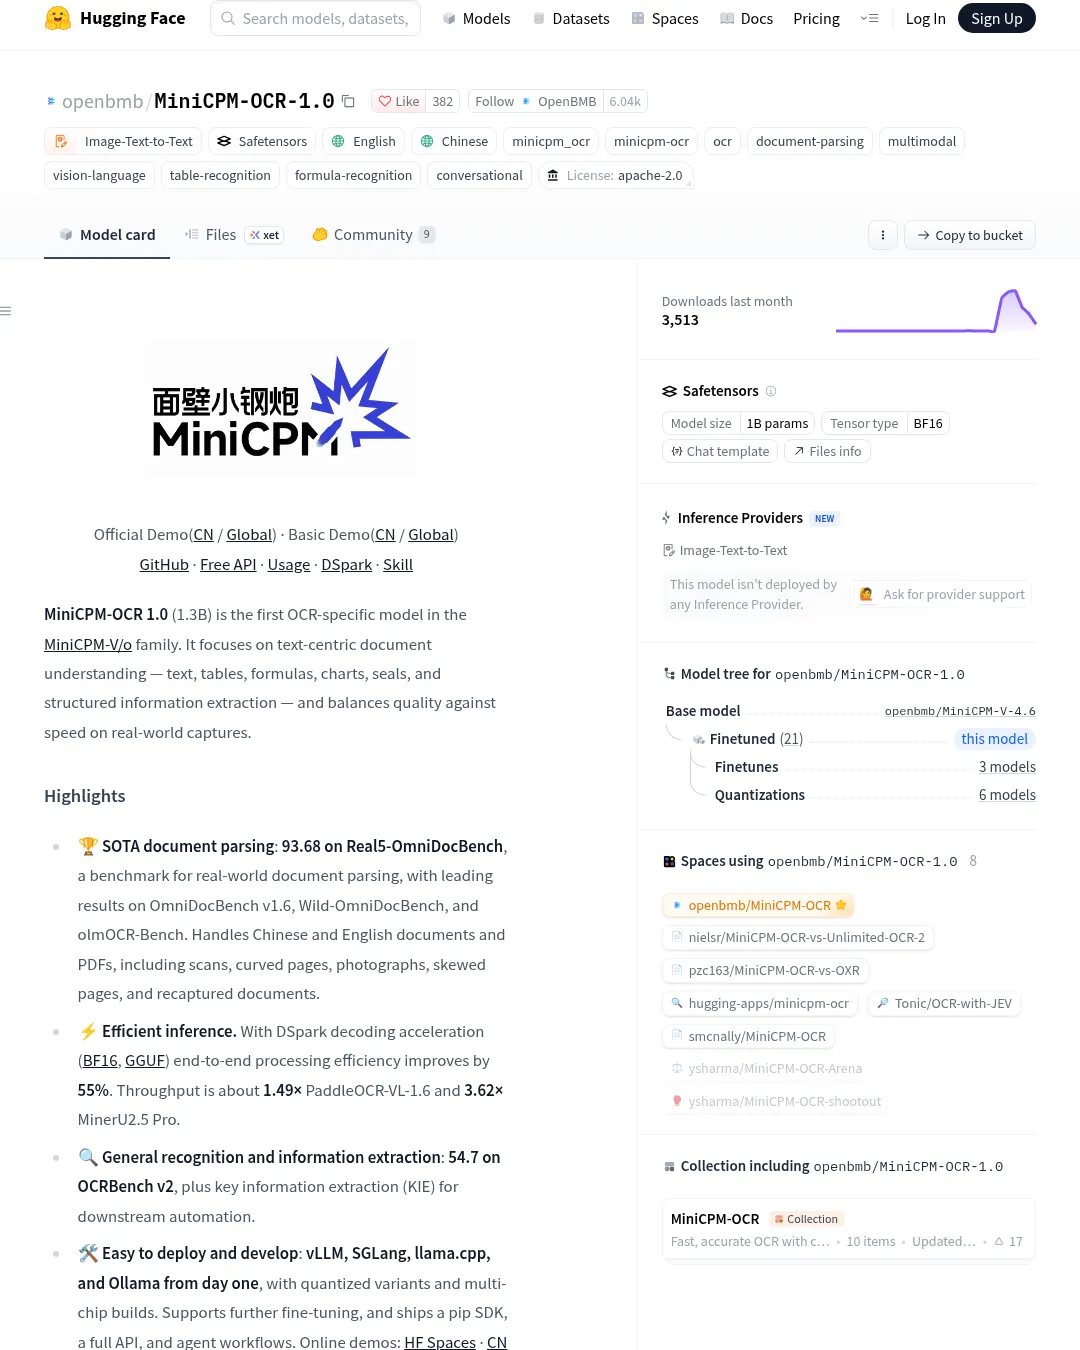
MiniCPM-OCR 1.0은 13억 개 파라미터를 가진 오픈소스 문서 인식 모델이다. 제작진은 실제 문서 분석 벤치마크 Real5-OmniDocBench에서 93.68점을 기록했다고 밝혔다. 중국어와 영어 문서의 글자·표·수식·차트·도장 인식과 구조화된 정보 추출을 지원한다.
제작진에 따르면 DSpark 디코딩 가속을 적용하면 전체 처리 효율이 55% 향상된다. 처리량은 PaddleOCR-VL-1.6의 약 1.49배, MinerU2.5 Pro의 3.62배라고 밝혔다. 이 비교는 가속 설정을 사용한 결과이며, 처리량은 페이지 내용과 백엔드, 동시 처리 수, 하드웨어에 따라 달라질 수 있다.
NVIDIA GeForce RTX 5090에서 OmniDocBench v1.6 이미지 1,651장을 이미지 단위 동시성 1로 처리했을 때는 초당 1.2페이지를 기록했다. 페이지 안의 영역들은 병렬로 인식한다. 네 가지 벤치마크(OmniDocBench v1.6, Real5-OmniDocBench, Wild-OmniDocBench, olmOCR-Bench)의 평균 점수는 각 벤치마크에 같은 가중치를 둔 산술평균이다. 벤치마크별 점수는 서로 직접 비교할 수 없다. 재현 가이드와 모델 가이드에서 설정과 처리량 정보를 확인할 수 있다.
모델은 MiniCPM-V 4.6을 기반으로 OCR에 맞게 학습했으며, SigLIP 비전 인코더와 Qwen3.5 언어 모델로 구성된다. PDF나 이미지를 읽어 PP-DocLayoutV3로 레이아웃을 감지하고, 영역별 내용을 인식한 뒤 읽기 순서에 따라 마크다운으로 조립한다. vLLM, SGLang, llama.cpp, Ollama, FlagOS 백엔드를 지원하며, 모델 가중치와 코드, 문서는 Apache License 2.0으로 공개됐다.
온라인 데모에서 문서 인식과 정보 추출을 체험할 수 있다. 로컬 배포는 SDK 튜토리얼을 참고하면 된다. DSpark를 사용할 때는 같은 릴리스의 기본 모델과 초안 모델을 함께 써야 하며, 다른 기본 체크포인트의 가중치와 섞어서는 안 된다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요