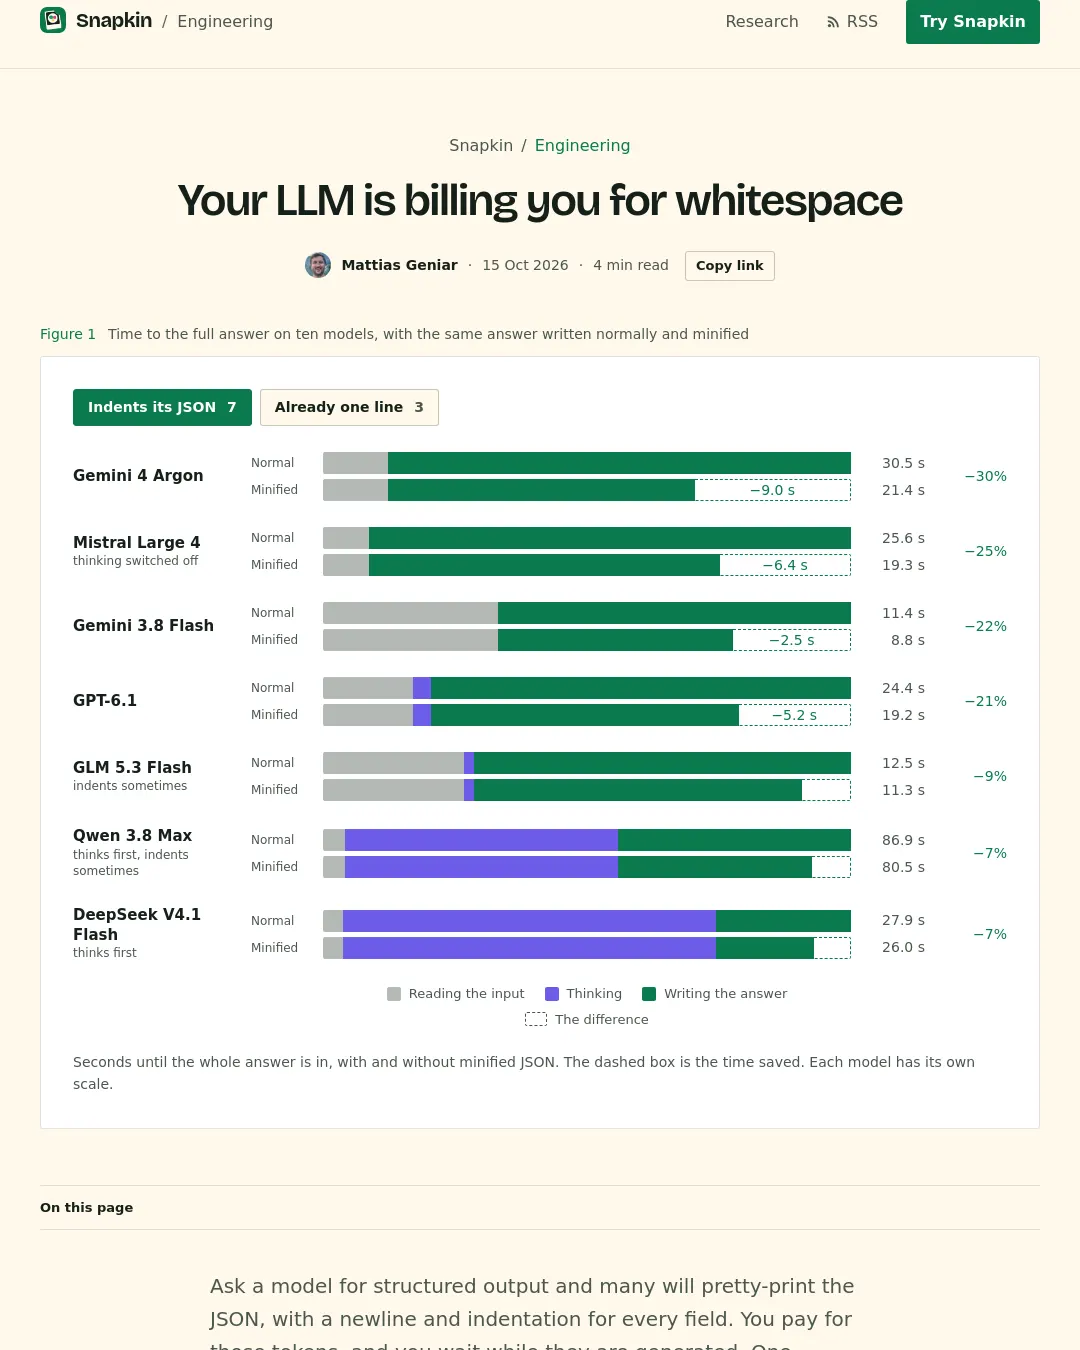
JSON을 한 줄로 출력하라고 지시하면 들여쓰기와 줄바꿈에 쓰이는 토큰을 줄일 수 있다. Snapkin이 9개 제공업체의 모델 10개를 시험한 결과, 7개 모델에서 응답 시간이 최대 30%, 호출 비용이 최대 28% 줄었고, 이미 한 줄 JSON을 출력한 3개 모델에서는 변화가 없었다.
측정에서는 같은 식사 사진과 프롬프트, JSON 스키마를 사용해 모델마다 지시를 추가한 경우와 추가하지 않은 경우를 각각 네 번 실행했다. 모델은 총 40개 답변 중 39개에서 한 줄 출력 지시를 따랐다. Mistral Large는 추론 기능을 켜면 답변을 끝내지 못해 추론을 끈 상태로 측정했다.
시간 절감 폭은 모델에 따라 달랐다. Gemini 4 Argon은 30.5초에서 21.4초로 30% 줄었고, Mistral Large 4는 25%, Gemini 3.8 Flash와 GPT-6.1은 21~22% 줄었다. 반면 추론에 시간이 오래 걸리는 DeepSeek V4.1 Flash와 Qwen 3.8 Max는 전체 응답 시간에서 출력 생성이 차지하는 비중이 작아 7% 절감에 그쳤다.
비용은 Gemini 4 Argon에서 호출 1,000회 기준 28%, GPT-6.1에서 25% 감소했다. Gemini 3.8 Flash와 Mistral Large 4는 13%, 추론 모델은 5~9% 줄었다. 이 측정에 포함된 모든 모델에서 출력 토큰 가격은 입력 토큰 가격의 최소 세 배였다. 다만 한 줄 출력은 입력 토큰이나 추론 토큰을 줄이지 않으므로, 입력 비용이나 추론 비용이 큰 경우 전체 절감 폭은 제한된다.
모델의 출력 형식은 요청에 따라서도 달라졌다. 작은 프롬프트와 간단한 스키마에서는 일부 모델이 지시 없이 한 줄 JSON을 출력했지만, 긴 시스템 프롬프트와 큰 스키마를 사용한 이번 요청에서는 Gemini 3.8 Flash, Gemini 4 Argon, Mistral이 들여쓰기한 답변을 냈다. Qwen은 추론 모드를 끈 경우에만 들여썼다. 따라서 실제로 사용하는 프롬프트에서 원시 출력을 확인한 뒤 지시를 적용하는 편이 낫다.
Claude Opus 5.5, Kimi K3, Grok 4.7은 처음부터 한 줄 JSON을 출력해 비용과 시간이 줄지 않았다. Snapkin은 지시를 넣었을 때 Grok의 추론 시간이 약 두 배 길어진 경우도 있었다고 밝혔다. 네 번의 실행에서 나타난 차이일 수 있어 잡음일 가능성도 있으며, 이미 한 줄을 출력하는 모델에 지시를 추가할 이점은 없다고 설명했다.
Snapkin은 같은 답변을 모델별 토크나이저로 원래 형식과 한 줄 형식으로 각각 계산해 토큰 차이를 비교했다. 시간과 비용 절감치는 줄어든 토큰 수에 각 모델의 출력 속도와 토큰 가격을 적용해 산출했다. 실제 적용 전에는 모델의 원시 출력을 확인하고, 소수의 시간 측정값만 비교하기보다 같은 답변의 토큰 수를 비교하라고 제안했다. Snapkin은 현재 식사 분석과 사용자의 수정 사항을 반영할 때 한 줄 JSON을 요청한다고 밝혔다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요