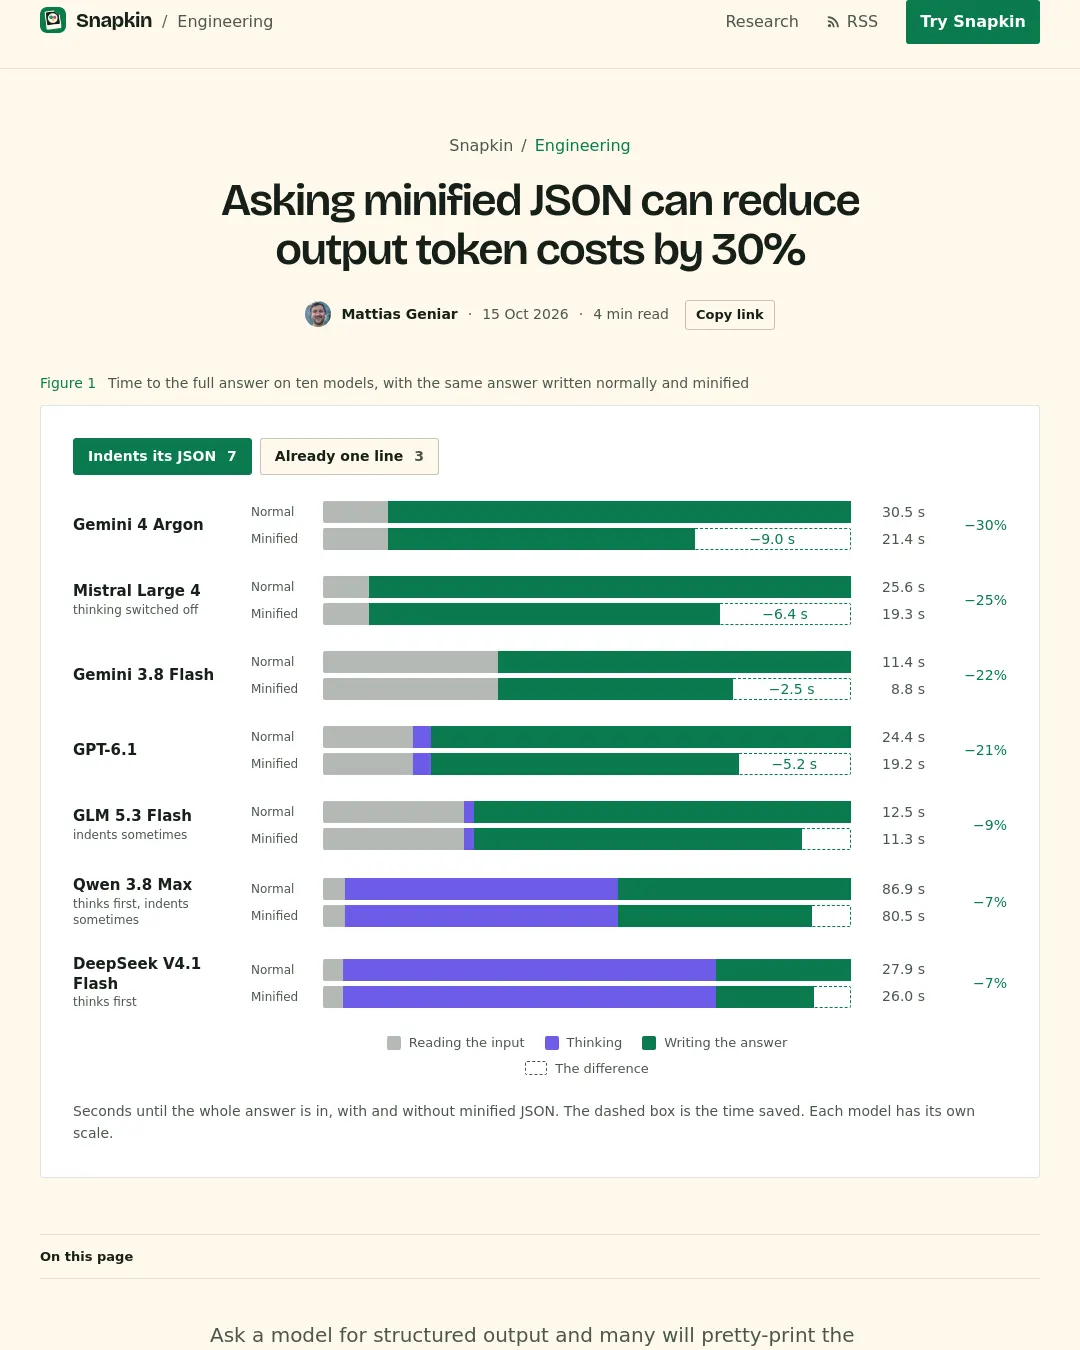
JSON 출력을 한 줄로 작성하라고 요청하면 들여쓰기와 줄바꿈에 쓰이는 토큰을 줄일 수 있다. Snapkin이 10개 모델을 비교한 결과, 7개 모델에서는 응답 시간과 비용이 감소했지만 이미 한 줄로 출력한 3개 모델에서는 차이가 없었다.
Snapkin은 같은 음식 사진과 프롬프트, JSON 스키마를 9개 제공업체의 모델 10종에 보내 지시문을 넣은 경우와 넣지 않은 경우를 각각 네 차례 실행했다. 모델들은 40개 응답 중 39개에서 지시를 따랐다. Mistral Large는 추론 기능을 켜면 답변을 끝내지 못해 추론을 끈 상태로 시험했다.
가장 큰 시간 절감은 바로 답변을 쓰기 시작하는 모델에서 나타났다. Gemini 4 Argon은 30.5초에서 21.4초로 30% 빨라졌고, Mistral Large는 25%, Gemini 3.8 Flash와 GPT-6.1은 21~22% 빨라졌다. 반면 추론에 약 20초와 45초를 쓰는 DeepSeek V4.1 Flash와 Qwen 3.8 Max는 전체 응답 시간 기준 절감 폭이 7%였다.
비용은 Gemini 4 Argon에서 28%, GPT-6.1에서 25% 줄었다. Gemini 3.8 Flash와 Mistral은 13%, 추론 모델은 5~9% 감소했다. 출력 토큰이 입력 토큰보다 최소 세 배 비싸더라도, 입력 비용이 답변 비용과 비슷하거나 더 크면 전체 절감률은 낮아진다. 추론에 쓰인 토큰은 줄어들지 않기 때문이다.
Claude Opus 5.5, Kimi K3, Grok 4.7은 시험에서 이미 한 줄 JSON을 출력해 지시문을 추가해도 절약 효과가 없었다. Snapkin은 네 차례 실행에서 Grok의 추론 시간이 지시문을 넣었을 때 약 두 배로 늘었지만, 표본이 네 번뿐이라 잡음일 수 있다고 밝혔다.
Snapkin은 모델의 실제 요청에서 원시 출력을 확인한 뒤, 들여쓰기가 있으면 한 줄 JSON을 요청하고 이미 한 줄로 출력한다면 지시문을 생략하라고 제안했다. 측정에서는 같은 답변을 모델별 토크나이저로 들여쓴 형식과 압축한 형식으로 각각 계산해 토큰 차이를 비교했다. Snapkin은 현재 음식 분석과 사용자가 입력한 수정 사항을 처리할 때마다 한 줄 JSON을 요청한다고 밝혔다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요