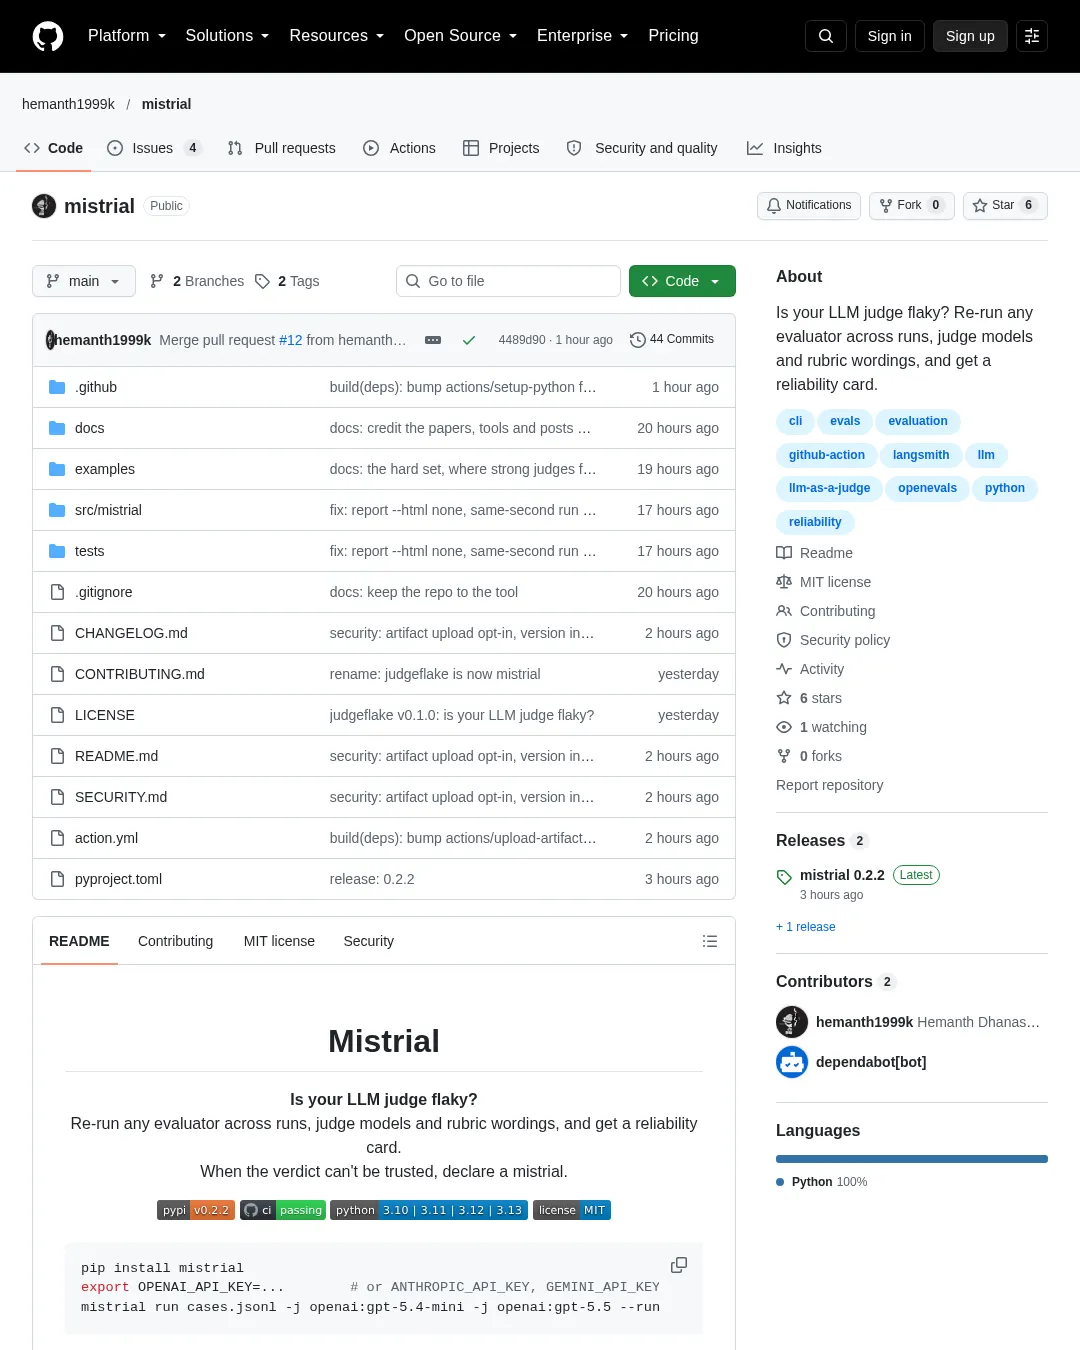
Mistrial은 같은 평가자에게 여러 번 판정을 맡기고 모델이나 평가 기준 문구를 바꿔 결과가 얼마나 달라지는지 측정하는 오픈소스 도구다. 기존 평가 함수나 LangSmith·openevals 평가자를 대상으로 신뢰도 보고서를 만들고, 불안정한 평가를 CI에서 감지하거나 다수결로 보완할 수 있다.
설치는 pip로 하며, API 키가 없어도 가짜 평가자를 실행하는 데모를 이용할 수 있다.
pip install mistrial
export OPENAI_API_KEY=... # or ANTHROPIC_API_KEY, GEMINI_API_KEY, GROQ_API_KEY ... see `mistrial providers`
mistrial run cases.jsonl -j openai:gpt-5.4-mini -j openai:gpt-5.5 --runs 5
데이터는 JSONL·JSON·CSV 형식으로 넣는다. 각 사례에는 inputs와 outputs가 필요하며, 기준 답변인 reference_outputs와 사람이 붙인 label은 선택 항목이다. OpenAI·Anthropic·Gemini 등 호스팅 모델과 로컬 Ollama 모델, 자체 평가 함수도 지정할 수 있다. API 키 없이 시험하려면 pipx run mistrial demo를 실행한다.
보고서에는 같은 평가자의 자기 일치도, 실행 사이에 판정이 바뀐 사례, 평가자 간 일치도, 사람의 라벨과 비교한 정확도, 파싱 감사 결과가 담긴다. 실행 결과는 .mistrial/runs/에 JSON으로 저장되고 응답은 캐시된다. 터미널 보고서 외에 HTML·JSON·마크다운 형식으로 내보낼 수 있으며, CI 게이트와 GitHub Action 연동도 지원한다.
제작자가 제시한 예시에서는 까다로운 32개 사례를 평가자 세 종류가 각각 다섯 번 판정했다. 이 실험에서 gpt-5.4-nano는 32개 중 5개 사례에서 판정을 바꿨고, gpt-5.5는 바꾸지 않았다. 제작자는 다수결 보정으로 gpt-5.4-nano의 자기 일치도가 92%에서 99%로 높아졌다고 보고했다. 이는 제작자가 제시한 특정 사례와 실행 결과이며, 다른 평가 데이터에서도 같은 결과가 난다는 뜻은 아니다.
Mistrial은 일관성과 정확도를 별도로 보여준다. 평가자가 계속 같은 오답을 낼 수도 있으므로, 자기 일치도만으로 평가 결과의 타당성을 판단해서는 안 된다. 제작자도 사례 수가 적을 때 카파 지표를 근거로 삼기 어렵다고 밝힌다. 프로젝트 저장소와 자세한 사용법은 Mistrial GitHub 저장소에서 확인할 수 있다. 연구 배경으로는 Rating Roulette과 Reliability without Validity를 제시한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요