TL;DR
- ML News는 머신러닝(ML) 중심 Hacker News 목록을 제공하며, 최근·과거·인기 게시물과 RSS를 탐색할 수 있는 서비스임.
- 소개된 연구에는 모델이 문맥을 직접 편집하는 방식, 에이전트용 격리 환경, 채팅 템플릿에 따른 자기지칭 표현 변화가 포함됨.
- 에이전트 학습·코딩 에이전트 설계 연구에서는 단계별 기여도 평가와 메모리 정리 방식이 성능 차이를 보임.
- 삼진법 대형 언어 모델(LLM)의 가중치 저장, 탐색 전략의 자기 개선, 실시간 데이터 기반 가중치 조정이 주요 기술 주제임.
- 로컬 인공지능(AI)의 와트당 지능 측정과 LLM 간 내부 문맥 직접 교환 등 효율성·통신 관련 연구도 소개됨.
ML News
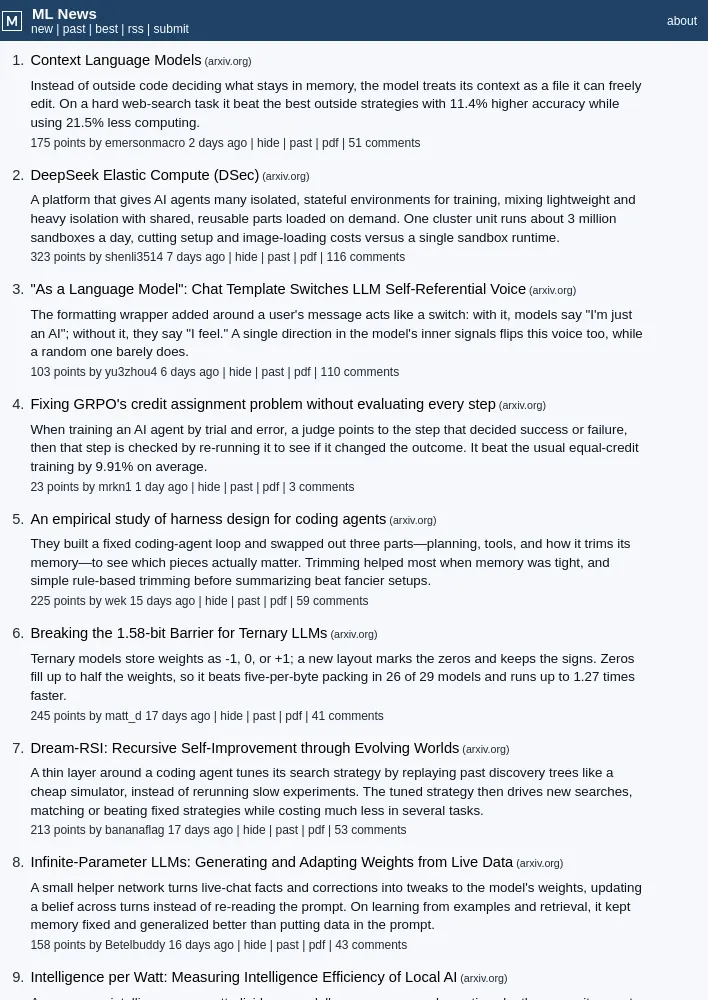
- ML News는 머신러닝 관련 Hacker News 게시물을 모아 보여주는 서비스이며, 메뉴에 new, past, best, rss, submit, about가 표시됨.
- 목록에는 논문·프로젝트 제목, 요약, 점수, 게시자, 게시 시점, PDF 및 댓글 관련 정보가 포함됨.
주요 게시물
- Context Language Models: 외부 코드가 메모리에 남길 내용을 결정하는 대신, 모델이 문맥을 자유롭게 편집할 수 있는 파일처럼 다룸. 어려운 웹 검색 과제에서 최선의 외부 전략보다 정확도가 11.4% 높고, 연산량은 21.5% 적음. 175점, emersonmacro, 2일 전, 댓글 51개.
- DeepSeek Elastic Compute (DSec): AI 에이전트 훈련을 위해 상태를 유지하는 다수의 격리 환경을 제공하며, 경량·강력 격리 방식과 요청 시 불러오는 공유 재사용 구성 요소를 결합함. 클러스터 단위 하나가 하루 약 300만 개 샌드박스를 실행하며, 단일 샌드박스 런타임보다 설정 및 이미지 로딩 비용이 낮음. 323점, shenli3514, 7일 전, 댓글 116개.
- “As a Language Model”: Chat Template Switches LLM Self-Referential Voice: 사용자 메시지에 덧붙는 형식 래퍼가 모델의 자기지칭 표현을 바꾸는 스위치처럼 작동함. 래퍼가 있으면 “나는 그저 AI”라고 하고 없으면 “나는 느낀다”고 표현하며, 모델 내부 신호의 특정 방향 하나도 표현을 전환하지만 무작위 방향은 거의 영향을 주지 않음. 103점, yu3zhou4, 6일 전, 댓글 110개.
- Fixing GRPO’s credit assignment problem without evaluating every step: 시행착오로 AI 에이전트를 훈련할 때 판정자가 성공 또는 실패를 결정한 단계를 지목하고, 해당 단계를 다시 실행해 결과가 바뀌는지 확인함. 통상적인 균등 기여도 학습보다 평균 9.91% 높은 성능을 보임. 23점, mrkn1, 1일 전, 댓글 3개.
- An empirical study of harness design for coding agents: 고정된 코딩 에이전트 실행 흐름에서 계획, 도구, 메모리 정리 방식의 세 요소를 바꿔 각 요소의 영향을 비교함. 메모리가 제한적일수록 정리의 효과가 컸으며, 요약 전에 단순한 규칙 기반으로 정리하는 방식이 더 복잡한 구성보다 나은 결과를 보임. 225점, wek, 15일 전, 댓글 59개.
- Breaking the 1.58-bit Barrier for Ternary LLMs: 삼진법 모델은 가중치를 -1, 0, +1로 저장하며, 새 레이아웃은 0의 위치를 표시하고 부호를 보존함. 가중치의 최대 절반이 0인 특성을 활용해 29개 모델 중 26개에서 바이트당 5개를 패킹하는 방식보다 나았고, 실행 속도는 최대 1.27배 높음. 245점, matt_d, 17일 전, 댓글 41개.
- Dream-RSI: Recursive Self-Improvement through Evolving Worlds: 코딩 에이전트에 얇은 계층을 더해 과거 탐색 트리를 저비용 시뮬레이터처럼 재생하고, 느린 실험을 다시 수행하지 않고 탐색 전략을 조정함. 조정한 전략은 새 탐색에 활용되며, 여러 과제에서 고정 전략과 같거나 더 나은 성능을 훨씬 낮은 비용으로 보임. 213점, bananaflag, 17일 전, 댓글 53개.
- Infinite-Parameter LLMs: Generating and Adapting Weights from Live Data: 작은 보조 네트워크가 실시간 대화의 사실과 정정을 모델 가중치 조정으로 변환해, 프롬프트를 다시 읽는 대신 대화 차례에 걸쳐 믿음을 갱신함. 예시 학습과 검색에서 메모리 크기를 고정한 채 데이터를 프롬프트에 넣는 방식보다 일반화 성능이 높음. 158점, Betelbuddy, 16일 전, 댓글 43개.
- Intelligence per Watt: Measuring Intelligence Efficiency of Local AI: 실제 질문에 대한 모델 정확도를 소비 전력으로 나누는 와트당 지능 점수를 제안해 노트북의 소형 모델이 질문을 처리할 수 있는지 평가함. 100만 개 질문에서 로컬 모델의 응답률은 88.7%였으며, 해당 점수는 2023년 이후 5.3배 증가함. 169점, pythonic_hell, 19일 전, 댓글 65개.
- Cache-to-Cache: Direct Semantic Communication Between LLMs (2025): 두 AI 모델이 문장으로 정보를 주고받는 대신 내부 메모리를 직접 공유하며, 작은 네트워크가 한 모델의 저장된 문맥을 다른 모델의 문맥에 혼합함. 텍스트 기반 교환보다 정확도가 높고 속도는 약 2.5배 빠름. 109점, rochansinha, 15일 전, 댓글 22개.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요