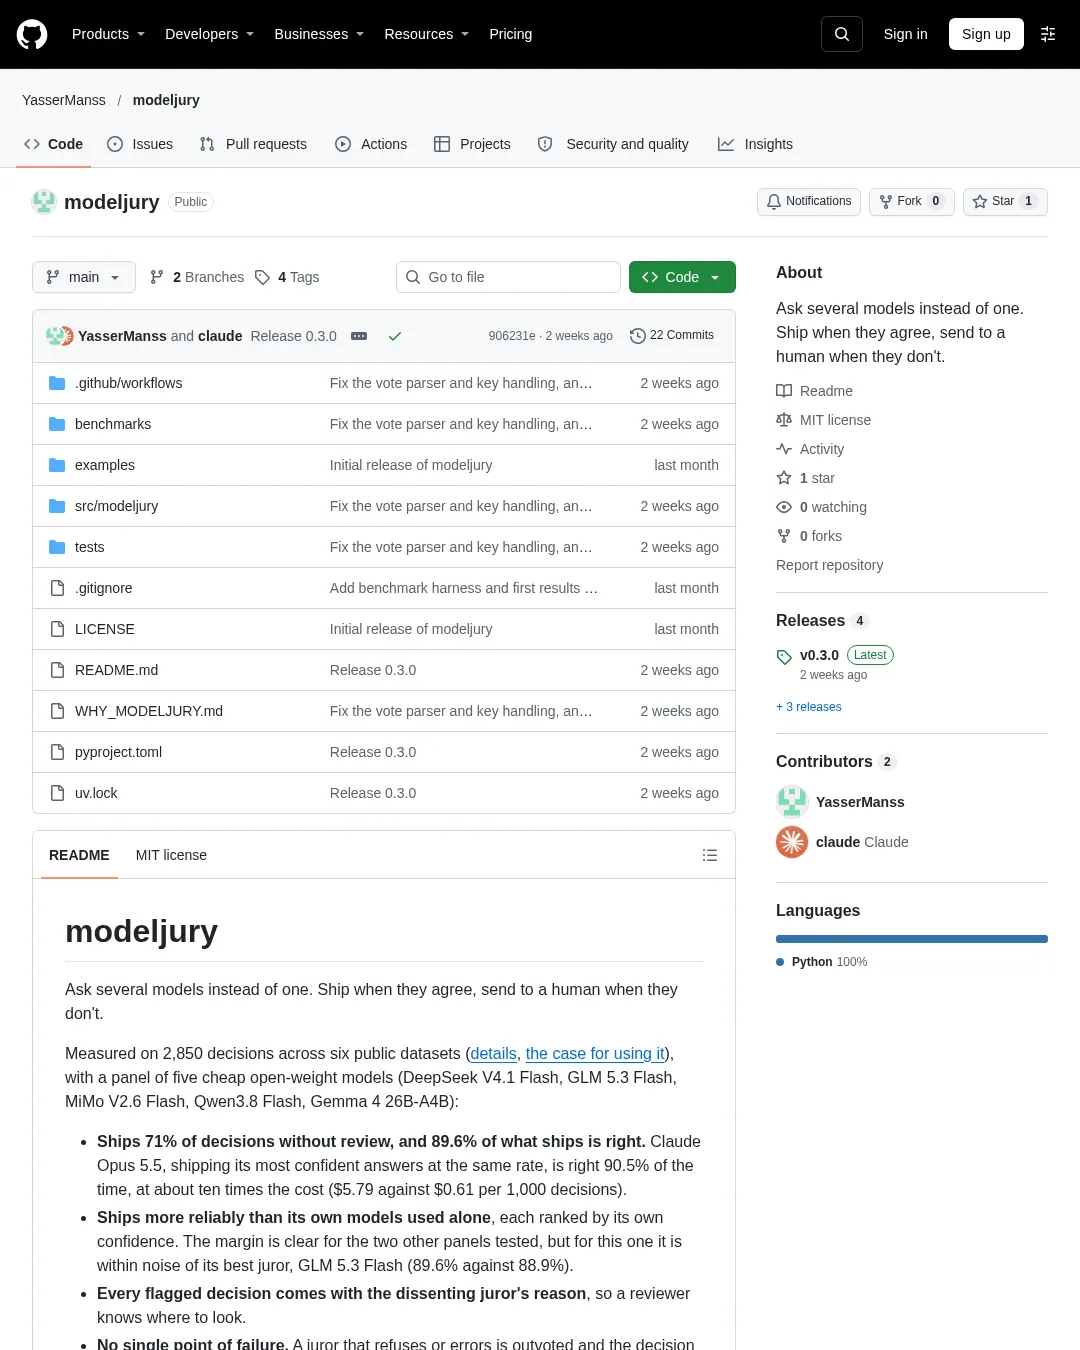
modeljury는 여러 모델의 판단이 일치하면 자동으로 처리하고, 의견이 다르면 사람에게 검토를 맡기는 파이썬 라이브러리다. 제작자는 공개 데이터셋 6개에서 2,850건을 평가했으며, 비용이 낮은 오픈 웨이트 모델 5개로 구성한 패널의 결과와 한계를 공개했다.
- 패널이 검토 없이 처리한 결정은 71%였고, 그중 정답은 89.6%였다. 같은 비율로 가장 자신 있는 답만 처리한 Claude Opus 5.5의 정답률은 90.5%였으며, 결정 1,000건당 비용은 약 10배인 5.79달러 대 0.61달러였다.
- 패널은 각 모델을 따로 사용하고 모델 자체의 신뢰도로 답을 골랐을 때보다 더 안정적으로 처리했다. 다만 이번 패널의 성능은 가장 우수한 구성원인 GLM 5.3 Flash와 통계적 오차 범위 안에서 비슷했다(89.6% 대 88.9%).
- 검토 대상으로 표시된 결정에는 반대 의견을 낸 모델의 이유가 함께 제공된다.
- 모델이 응답을 거부하거나 오류를 내도 해당 모델의 표를 제외하고 결정을 검토 대상으로 표시하므로, 한 모델의 실패로 결과가 사라지지는 않는다.
평가 결과와 한계
이번 평가에 사용한 패널은 저비용 오픈 웨이트 모델 5개로 구성됐다. DeepSeek V4.1 Flash, GLM 5.3 Flash, MiMo V2.6 Flash, Qwen3.8 Flash, Gemma 4 26B-A4B다. 세부 결과와 사용 근거는 벤치마크 결과와 사용 근거 문서에 공개돼 있다.
Claude Opus는 전체 정확도에서 패널보다 높았다(83.1% 대 80.1%). 긴 답변 비교와 77개 선택지가 있는 의도 분류에서도 Opus가 훨씬 나았다. 혐오 발언 분류에서는 패널 점수가 더 높았지만(76% 대 71%), 더 많은 게시물을 혐오 발언으로 표시했기 때문이다. 패널은 혐오 댓글의 80%를 찾아냈고 Opus는 62%를 찾아냈지만, 오탐률도 패널이 29%, Opus가 20%였다. 혐오 댓글이 절반인 벤치마크에서는 패널이 앞섰지만, 댓글 중 혐오 발언이 약 3분의 1보다 적은 환경에서는 Opus의 정확도가 더 높다.
이 패널은 다른 구성에 대한 평가를 마친 뒤 추가됐고, 같은 항목으로 점수를 매겼다. 따라서 새 표본에서 결과를 재확인하지는 않았다. 손실을 포함한 모든 수치는 RESULTS.md에 있으며, benchmarks/report.py와 benchmarks/stats.py로 원시 기록에서 전체 실행 결과를 다시 생성할 수 있다.
여러 모델에 답을 묻고 투표하는 방식 자체는 새로운 것이 아니다. 관련 연구로 Verga 외, 2024, “Replacing Judges with Juries”가 있다. modeljury는 이 방식을 실무에 적용하는 작은 라이브러리다. 모델 간 이견을 이유와 함께 검토 표시로 바꾸고, 그 표시가 얼마나 유효한지 벤치마크한다.
설치와 기본 사용
Python 3.10 이상이 필요하다.
pip install modeljury
# Claude 지원을 포함할 때
pip install "modeljury[claude]"
OpenAI 호환 엔드포인트를 지정해 패널을 구성할 수 있다. OpenAI, Ollama, vLLM, OpenRouter 등을 사용할 수 있다. 아래 예시는 로컬 Ollama에서 제공하는 모델 세 개를 사용한다.
from modeljury import Juror, convene

local = "http://localhost:11434/v1"
result = convene(
 question="Is this review spam?",
 evidence="'Best product ever!!! Visit cheap-deals.example for 90% off!!!'",
 options=["spam", "not spam"],
 jurors=[Juror(m, base_url=local) for m in ["llama3.1", "qwen3", "mistral"]],
)

print(result.verdict, result.needs_review)
for juror, choice, reason in result.dissent:
 print(f"{juror} disagreed: {choice}, {reason}")
호스팅 모델을 사용할 때는 OPENAI_API_KEY를 설정한다. OpenAI가 아닌 제공업체라면 OPENAI_BASE_URL도 설정하거나 각 Juror에 api_key=와 base_url=을 전달한다. OPENAI_API_KEY는 OPENAI_BASE_URL이 가리키는 엔드포인트로만 전송되며, 이 설정이 없으면 OpenAI로 전송된다. 따라서 다른 base_url을 쓰는 juror에는 자체 api_key=를 지정해야 한다. 위 예시의 Ollama처럼 키를 확인하지 않는 서버에는 키가 필요 없다. Claude에는 ANTHROPIC_API_KEY를 설정한다.
사용 예시와 결과 해석
from modeljury import Juror, convene

result = convene(
 question="Is this refund request fraudulent?",
 evidence=ticket_text,
 options=["fraud", "legit"],
 jurors=[
 Juror("gpt-4o-mini"),
 Juror("llama3.1", base_url="http://localhost:11434/v1"),
 Juror("mistral-small", base_url="https://api.mistral.ai/v1", api_key="..."),
 ],
)

result.verdict # "legit", or None on a hung jury
result.majority # True: the verdict won more than half of the whole panel
result.needs_review # True
result.dissent # [("mistral-small", "fraud", "Shipping address changed after purchase")]
result.failed # jurors that errored or gave an invalid answer
OpenAI Chat Completions API를 지원하는 엔드포인트라면 사용할 수 있다. juror를 문자열("gpt-4o-mini")로 지정하면 OPENAI_BASE_URL과 OPENAI_API_KEY를 사용한다.
다음 사례는 실제 실행 결과다. 하나의 로컬 27B 모델을 복제한 5개 juror를 temperature=1.0으로 샘플링했다. 여기에 실린 근거 문장은 조금 줄였고, 인용한 이유는 모델이 직접 생성한 문구다. 서로 다른 모델을 섞은 패널이라면 의견이 더 자주 엇갈릴 수 있다. 문서 끝의 주의사항도 참고해야 한다.
상반된 단서가 있는 환불
convene(
 question="Should this refund be approved?",
 evidence="Customer of 6 years, 40 prior orders, 2 prior refunds (both legitimate). "
 "Claims a $1,900 laptop arrived with a cracked screen. The photo's EXIF date is "
 "2 days before delivery. Courier marked it 'left at door', no signature. "
 "Customer says their phone clock is wrong and offers to send the laptop back.",
 options=["approve", "deny", "escalate"],
 jurors=jurors,
)
4대 1로 escalate가 선택돼 검토 대상으로 표시됐다. 다수 의견은 사진의 EXIF 날짜를 확인해야 한다는 것이었다. 소수 의견은 환불 승인 근거를 들었다.
승인: 6년 동안 거래했고 정당한 환불은 두 번뿐이었다. 이는 EXIF 날짜가 맞지 않는다는 점보다 더 중요한 근거다. 고객이 휴대전화 시계가 잘못 설정됐다고 설명한 것도 그럴듯하다.
네 팀 중 버그 담당 팀 정하기
convene(
 question="Which team should own this bug report?",
 evidence="'After upgrading to v4.2, CSV exports from the dashboard are missing every "
 "row created after 11pm. Only affects customers in Australia. Started the same day we "
 "moved the export job to a new server.'",
 options=["Frontend", "Data", "Infra", "Billing"],
 jurors=jurors,
)
4대 1로 Data가 선택됐지만 검토 대상으로 표시됐다. 네 juror는 내보내기 파이프라인의 시간대 처리 문제를 지목했다. 반대 의견은 가장 강한 단서를 짚었다.
Infra: 내보내기 작업을 새 서버로 옮긴 직후 버그가 시작됐다. 시간에 따른 필터링 오류는 새 인프라의 시간대 설정 문제에서 비롯됐을 가능성이 크다.
따라서 반대 의견만 읽어도 검토자가 먼저 살펴볼 곳을 알 수 있다.
빠르지만 위험한 캐시 병합
convene(
 question="Should this pull request be merged as is?",
 evidence="Adds a cache in front of the user-permissions lookup: p99 latency drops "
 "from 900ms to 40ms. TTL is 10 minutes. Tests pass. A revoked admin keeps admin "
 "rights for up to 10 minutes. Revocations happen about 3 times a month, and last "
 "week's outage was caused by the slow lookup.",
 options=["merge", "request changes", "merge with follow-up ticket"],
 jurors=jurors,
)
5대 0으로 merge with follow-up ticket을 선택해 검토 없이 처리했다. 다섯 juror 모두 지연 시간 개선과 10분의 유효 시간 창을 함께 고려했고, 권한 취소 때 캐시를 무효화하는 후속 작업을 등록하자고 했다.
풍자인가 위협인가
convene(
 question="Does this post violate the policy against threats of violence?",
 evidence="Policy: remove credible threats of violence. Satire and hyperbole are allowed. "
 "Post, replying to a council member's parking fee increase: 'If they raise parking "
 "again I swear I'll show up at the next meeting and make sure he never votes on "
 "anything again 🙂'. Author has no prior violations and often jokes about local politics.",
 options=["violates", "allowed"],
 jurors=jurors,
)
5대 0으로 allowed를 선택해 검토 없이 처리했다. 하지만 이 사례는 주의가 필요하다. 게시물은 표적과 장소를 언급하므로 사람인 중재자는 검토 대상으로 보낼 수 있다. 다섯 juror는 대부분 웃는 이모티콘을 근거로 같은 이유에서 게시물을 문제 삼지 않았다. 한 모델을 복제한 juror끼리는 맹점을 공유할 수 있어, 만장일치가 겉보기만큼 강한 증거는 아니다. juror들이 실제로 다른 판단을 내릴 수 있도록 서로 다른 모델 계열을 사용해야 한다.
모델 설정
convene()에 추가로 전달하는 키워드 인수는 각 juror의 chat.completions.create 호출에 전달된다. juror 자체의 params 값은 공통 설정을 덮어쓴다. temperature의 기본값은 0이다. Claude juror는 공통 인수 가운데 max_tokens만 받는다. 자세한 내용은 Claude 설명을 참고한다.
convene(..., temperature=0.3, max_tokens=200, jurors=[
 Juror("gpt-4o-mini"), # temperature=0.3, max_tokens=200
 Juror("o4-mini", params={"temperature": None, # None drops a param
 "reasoning_effort": "low"}), # adds a model-specific option
 Juror("qwen3", base_url="http://localhost:8000/v1",
 params={"temperature": 0.7, "extra_body": {"top_k": 20}}), # overrides temperature
])
시간 제한
timeout은 각 juror의 API 호출에 적용되는 요청 시간 제한이다. 무엇을 제한하고 무엇은 제한하지 않는지 구분해야 한다.
convene(question, evidence, options, jurors, timeout=60)
이 설정은 작업 시간을 제한하는 것이 아니라, 응답이 없는 시간을 제한한다. 바이트가 도착할 때마다 시간이 다시 계산된다. modeljury의 호출은 스트리밍하지 않으므로 juror가 생성한 토큰은 응답이 완성된 뒤에야 클라이언트에 도착한다. 느린 juror가 어떻게 처리되는지는 서버에 달려 있다.
- 응답이 끝날 때까지 아무것도 보내지 않는 서버에서는
timeout초 동안 작업한 뒤 요청 시간이 초과된다. 기본값 60초보다 오래 걸리는 juror는 중단되고 재시도된 뒤 최종 실패할 수 있으므로, 느린 하드웨어나 긴 추론에는timeout을 늘려야 한다. - 작업 중 연결 유지 바이트를 보내는 서버는 계속 데이터를 보내므로 시간이 만료되지 않는다. 벤치마크에서 OpenRouter가 그랬다. 한 juror는 300초 제한이 설정된 상태에서 1,915초 동안 실행한 뒤 65,536토큰의 응답을 성공적으로 반환했고, 다른 두 juror는 각각 131,072토큰을 생성했다.
시간 제한은 juror별이 아니라 요청 시도별로 적용된다. OpenAI 및 Anthropic SDK는 요청 실패와 시간 초과를 포함해 기본적으로 두 번 재시도하므로, 계속 시간 초과되는 juror는 포기하기 전까지 총 세 번 시도된다. 이 과정은 timeout의 세 배보다 오래 걸릴 수 있다. 직접 클라이언트에서 max_retries를 높이면 대기 시간은 더 늘어난다.
convene() 자체에는 마감 시간이 없다. juror를 병렬로 확인하지만 모든 juror의 응답을 기다리므로, 가장 느린 juror가 끝나야 반환한다. 패널 지연 시간은 가장 느린 juror의 응답 시간이며, 다른 juror가 빨라도 한 juror가 느리면 결정 전체가 지연된다.
실제로 juror가 수행할 작업을 제한하려면 max_tokens를 설정해야 한다. 이는 어떤 서버에서든 모델의 작업량을 제한하므로 실행 시간과 비용을 제한하는 이 문서의 유일한 옵션이다.
convene(..., max_tokens=512, jurors=[...])
모델의 최대 한도에 맞추기보다 필요한 응답 길이에 맞춰 값을 정한다. 기본 프롬프트는 선택지, 신뢰도, 한 줄 이유를 요청하므로 수십 토큰이면 된다. 추론 모델은 JSON을 출력하기 전에 상당히 더 많은 토큰이 필요하다. 값을 너무 낮게 설정하면 juror가 응답을 끝내지 못하고 표가 실패해 해당 결정이 검토 대상으로 표시된다. 안전한 처리 방식이지만 답을 받지 못한 비용은 이미 발생한다. modeljury는 OpenAI 호환 juror에 max_tokens 기본값을 설정하지 않으므로, 값을 지정하지 않으면 모델의 컨텍스트 한도까지 생성할 수 있다. Claude juror의 기본값은 16000이며 패널의 max_tokens 설정도 적용된다.
Claude 사용
Claude는 Anthropic Messages API를 사용한다. 추가 기능을 설치하려면 pip install modeljury[claude]를 실행한다.
from modeljury import Claude

jurors = [
 "gpt-4o-mini",
 "claude-sonnet-5-5", # any "claude-..." string works
 Claude("claude-opus-5-5", params={"output_config": {"effort": "low"}}),
]
- 인증 정보는
ANTHROPIC_API_KEY또는ant auth login프로필에서 가져온다. 직접 지정하려면api_key=를 전달한다. - 패널 공통 키워드 인수 가운데 Claude juror가 받는 것은
max_tokens뿐이다. 나머지는 OpenAI 매개변수이므로 Messages API 옵션은params에 넣는다. 최신 Claude 모델은temperature를 거부하므로 해당 값은 전송하지 않는다. max_tokens기본값은 16000이다. 패널의max_tokens나 juror의params={"max_tokens": ...}로 더 낮은 상한을 설정할 수 있다. 사고 과정 토큰도 이 한도에 포함되므로, 사고 과정이 한도를 모두 사용하면 답변이 나오지 않아 표가 실패한다.- Claude가 요청을 거부하면 표는
result.failed에 기록되고 해당 결정은 검토 대상으로 지정된다.
자체 서명 인증서와 사용자 지정 클라이언트
자체 서명 또는 내부 인증서를 사용하는 서버라면 verify에 인증서 경로를 지정한다. verify=False를 설정하면 인증서 검증을 완전히 끈다. 작동은 하지만 네트워크 경로에 있는 누구나 API 키와 근거 자료를 읽을 수 있으므로 인증서를 사용하는 편이 낫다. Claude에도 같은 옵션이 있다.
Juror("my-model", base_url="https://my-server:8000/v1", verify="/path/to/ca.pem")
Juror("my-model", base_url="https://my-server:8000/v1", verify=False)
프록시처럼 그 밖의 사용자 지정 기능이 필요하면 자체 SDK 클라이언트를 client=로 전달한다. 이 경우 juror의 base_url, api_key, verify는 무시되므로 클라이언트에 설정해야 한다. 타임아웃과 연결 제한을 유지하려면 일반 httpx.Client 대신 SDK의 DefaultHttpxClient를 사용한다.
from openai import OpenAI, DefaultHttpxClient

client = OpenAI(base_url="...", api_key="...", http_client=DefaultHttpxClient(proxy="http://proxy:3128"))
Juror("my-model", client=client)
사용자 지정 프롬프트
prompt=에는 {question}, {evidence}, {options}를 포함하는 str.format 템플릿을 전달한다. 일반 중괄호는 {{와 }}로 두 번 써야 한다. 기본 프롬프트는 modeljury.PROMPT다. 파서는 {"choice": ..., "confidence": ..., "reason": ...} 형식의 JSON을 읽으므로 사용자 지정 템플릿도 이 형식의 출력을 요청해야 한다.
투표 규칙
- 각 juror는 허용된 선택지 하나와 한 줄 이유를 제출한다. 신뢰도도 보고해
vote.confidence에 기록하지만, 모델이 신뢰도를 부정확하게 보고하는 경향이 있어 판정을 정할 때는 사용하지 않는다. - 판정은 가장 많은 표를 받은 선택지다.
- 모든 juror가 유효한 같은 선택지를 반환하지 않으면
needs_review는 참이다. - 동률이면 배심원단의 판정이 나지 않은 것으로 처리하고 검토가 필요하다.
agreement는 승리한 선택지가 유효 표 가운데 차지한 비율이다. 오류를 내거나 응답을 거부하거나 허용되지 않은 답을 한 juror는 집계에서 제외하고 result.failed에 기록한다.
다음은 juror 세 명과 fraud / legit 선택지를 사용할 때의 결과다.
| 투표 | verdict | agreement | majority | needs_review | 이유 |
|---|---|---|---|---|---|
| legit, legit, legit | legit | 100% | ✅ | ❌ | 모두 동의해 검토 없이 처리 |
| legit, legit, fraud | legit | 67% | ✅ | ✅ | 이견이 있으며 이유는 dissent에 기록 |
| legit, fraud, failed | None | 50% | ❌ | ✅ | 동률이므로 판정 보류 |
| legit, legit, failed | legit | 100% | ✅ | ✅ | juror 한 명이 실패 |
| legit, failed, failed | legit | 100% | ❌ | ✅ | 세 명 가운데 유효 표가 하나뿐 |
| failed ×3 | None | 0% | ❌ | ✅ | 유효 표가 없음 |
verdict는 최다 득표 항목이므로 선택지가 세 개 이상이면 과반이 없어도 승리할 수 있다. 예를 들어 표 5개가 A, A, B, C, D로 나뉘면 A가 agreement 40%로 판정되지만 majority는 거짓이다. majority는 실패한 juror를 포함한 패널 전체를 기준으로 하며, 판정에 패널 절반보다 많은 juror가 표를 던졌다는 뜻이다.
needs_review는 엄격한 규칙이다. 더 느슨한 기준을 쓰려면 majority나 agreement를 직접 확인한다.
if not result.majority: # 패널 절반보다 많은 지지를 받은 결정만 처리
 send_to_human(result)
juror가 하나뿐이면 반대 의견이 나올 수 없으므로, 실패한 경우에만 결정이 검토 대상으로 표시된다. juror를 하나만 전달하면 convene()이 경고한다.
참고 사항
- 모델 이름이 틀리면
result.failed에 해당 엔드포인트가 제공하는 모델 목록이 표시된다. 모델이 20개를 넘으면 가장 가까운 이름도 제안한다. - 이름이 같은 juror를 여러 번 사용하면(예: 서로 다른 엔드포인트의
llama3.1)llama3.1,llama3.1#2처럼 기록한다. - 응답은 대소문자와 앞뒤 공백을 무시하고 선택지와 비교한다. 따라서 이런 차이만 있는 선택지를 함께 쓰면 안 되며, 그렇지 않으면
convene()이ValueError를 일으킨다. - 응답의 표는
<think>블록 뒤에 있는choice를 포함한 마지막 JSON 객체에서 가져온다. 그 뒤에 잘못된 객체가 있어도 마지막 응답이 우선하며, 가능한 필드는 복구한다. timeout은 요청 시도마다 데이터가 도착하지 않는 시간을 제한할 뿐 juror의 전체 마감 시간은 아니다. 시간 제한 설명을 참고한다.
개발 및 라이선스
uv sync
uv run pytest
라이선스는 MIT다. 자세한 내용은 LICENSE를 참고한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요