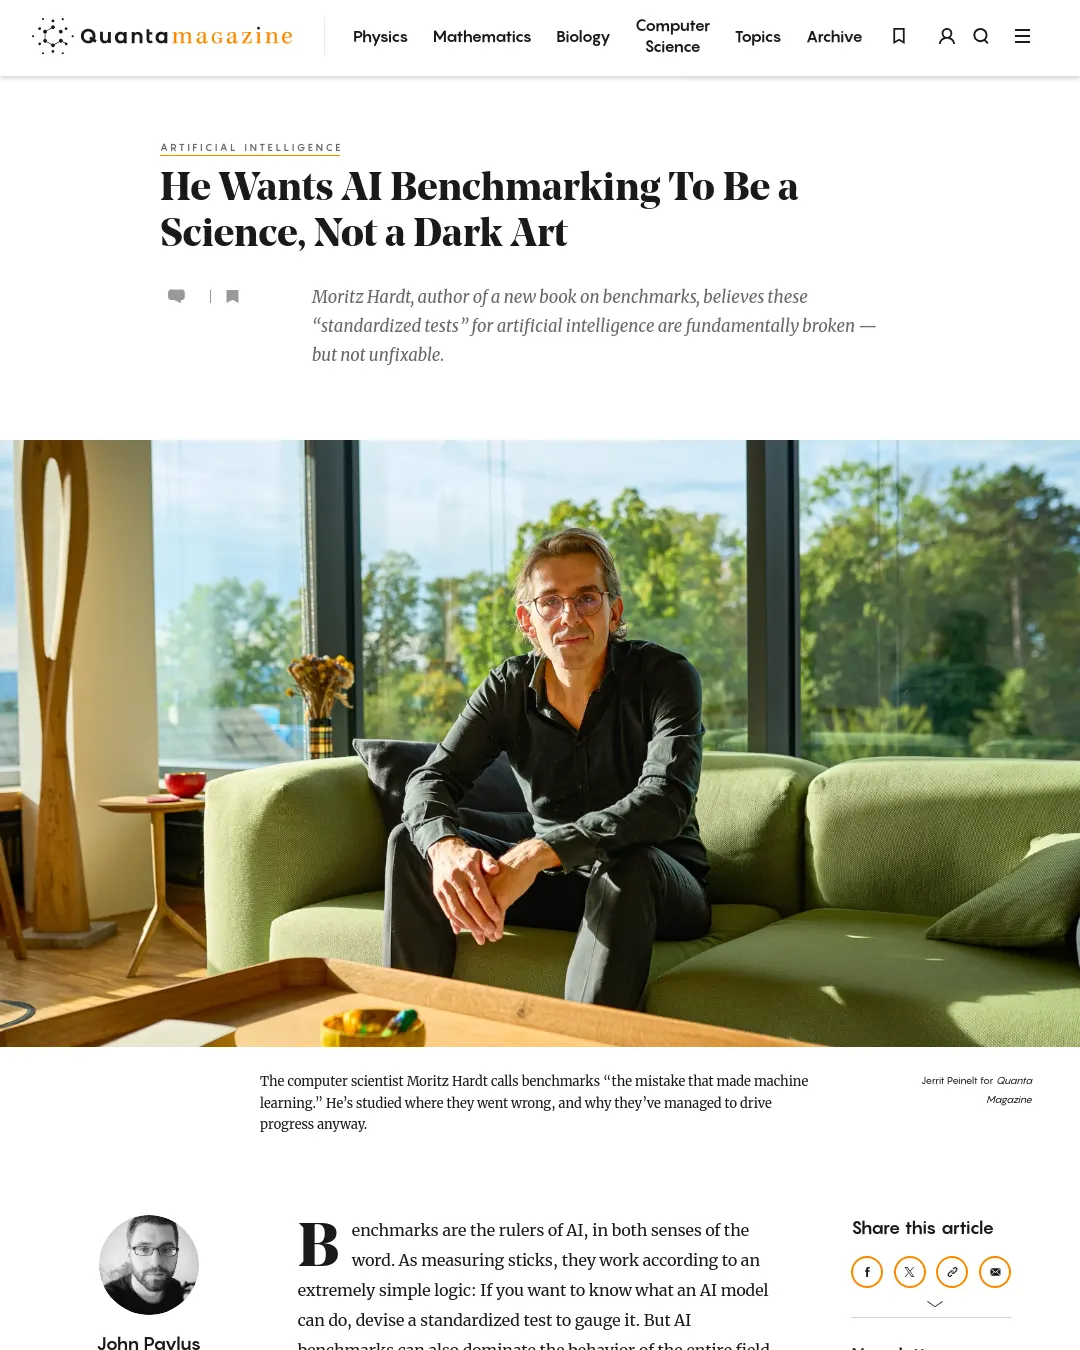
컴퓨터과학자이자 막스플랑크 지능형 시스템 연구소 소장인 모리츠 하트(Moritz Hardt)는 AI 벤치마크 점수가 모델의 능력을 제대로 나타내지 못한다고 지적한다. 그는 모델 간 순위는 유용할 수 있지만, 대규모 언어 모델 시대에는 벤치마크에 맞춘 학습이 순위의 신뢰성마저 흔들 수 있다고 본다.
벤치마크는 학습 데이터와 시험 데이터를 나누고, 시험 데이터로 모델을 비교해 순위를 매기는 방식이다. 1987년 미국 국방고등연구계획국(DARPA)의 음성 인식 벤치마크에서 당시 AI는 통계적 방법보다 낮은 성능을 보였고, 이는 AI 겨울이 시작되는 데 영향을 줬다. 반면 2012년 ImageNet에서는 8개 층으로 된 신경망이 이미지 분류에서 다른 알고리즘을 크게 앞서며 딥러닝 확산에 불을 붙였다.
하트는 벤치마크의 시험 데이터를 공개해 누구나 모델 개발에 활용할 수 있게 한 것이 문제라고 말한다. 시험 데이터를 반복해서 참고하면 모델이 사실상 그 데이터를 미리 알고 있는 것처럼 평가될 수 있다. 또 한 벤치마크에서 90% 정확도를 얻은 모델이 다른 데이터셋에서는 73%를 기록할 수도 있다. 따라서 점수 하나만으로 모델의 능력이나 추론 수준을 단정해서는 안 된다는 게 그의 설명이다.
그는 점수 자체보다 모델 간 상대 순위가 더 안정적일 수 있다고 본다. 같은 학습 데이터로 훈련한 모델이라면 한 시험에서 앞선 모델이 다른 데이터셋에서도 대체로 앞섰다는 것이다. 다만 하트는 이런 경향이 왜 나타나는지 포괄적으로 설명하는 이론은 아직 없으며, 경험적으로 관찰된 현상이라고 덧붙인다.
대규모 언어 모델에서는 이 전제가 흔들린다. 모델이 어떤 데이터로 훈련됐는지 알기 어렵고, 개발자가 특정 벤치마크에서 좋은 점수를 얻도록 학습 데이터를 구성할 수도 있기 때문이다. 하트는 새 모델이 출시될 때 이전에 공개된 벤치마크에서는 좋은 결과를 내지만, 이후 공개된 벤치마크에서는 성적이 낮아지는 일이 이런 ‘벤치맥싱’의 징후일 수 있다고 설명한다.
하트가 제안하는 방향은 모든 모델에 벤치마크와 관련된 데이터로 일정한 준비 과정을 거치게 하는 것이다. 그는 이를 고지대 훈련에 비유한다. 모델마다 벤치마크에 맞춰 준비하는 정도가 다르면 비교가 불공정해질 수 있지만, 모두에게 같은 준비 절차를 적용하면 점수가 부풀더라도 순위의 타당성을 회복할 수 있다는 주장이다. 이 방식에서는 별도의 학습 세트 없이 시험 세트와 평가 전 준비 절차를 두게 된다.
그는 벤치마크만으로 모델이 어떻게 작동하는지 알 수는 없다고 인정한다. 다만 단백질 접힘을 평가한 CASP 벤치마크가 단백질 접힘에 관한 과학 이론을 먼저 요구하지 않고도 연구를 진전시킨 사례처럼, 벤치마크가 장기적으로 새로운 과학 지식으로 이어질 수 있다고 본다.
하트의 관련 저서 The Emerging Science of Machine Learning Benchmarks는 벤치마크가 오랫동안 결함을 지녔으면서도 우연히 기계학습의 진전을 이끌었다는 주장을 다룬다. 그는 벤치마크가 모델의 절대적인 능력을 재는 도구라기보다, 이전보다 나은 모델이 나왔는지를 비교하는 지표로 쓰여야 한다고 설명한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요