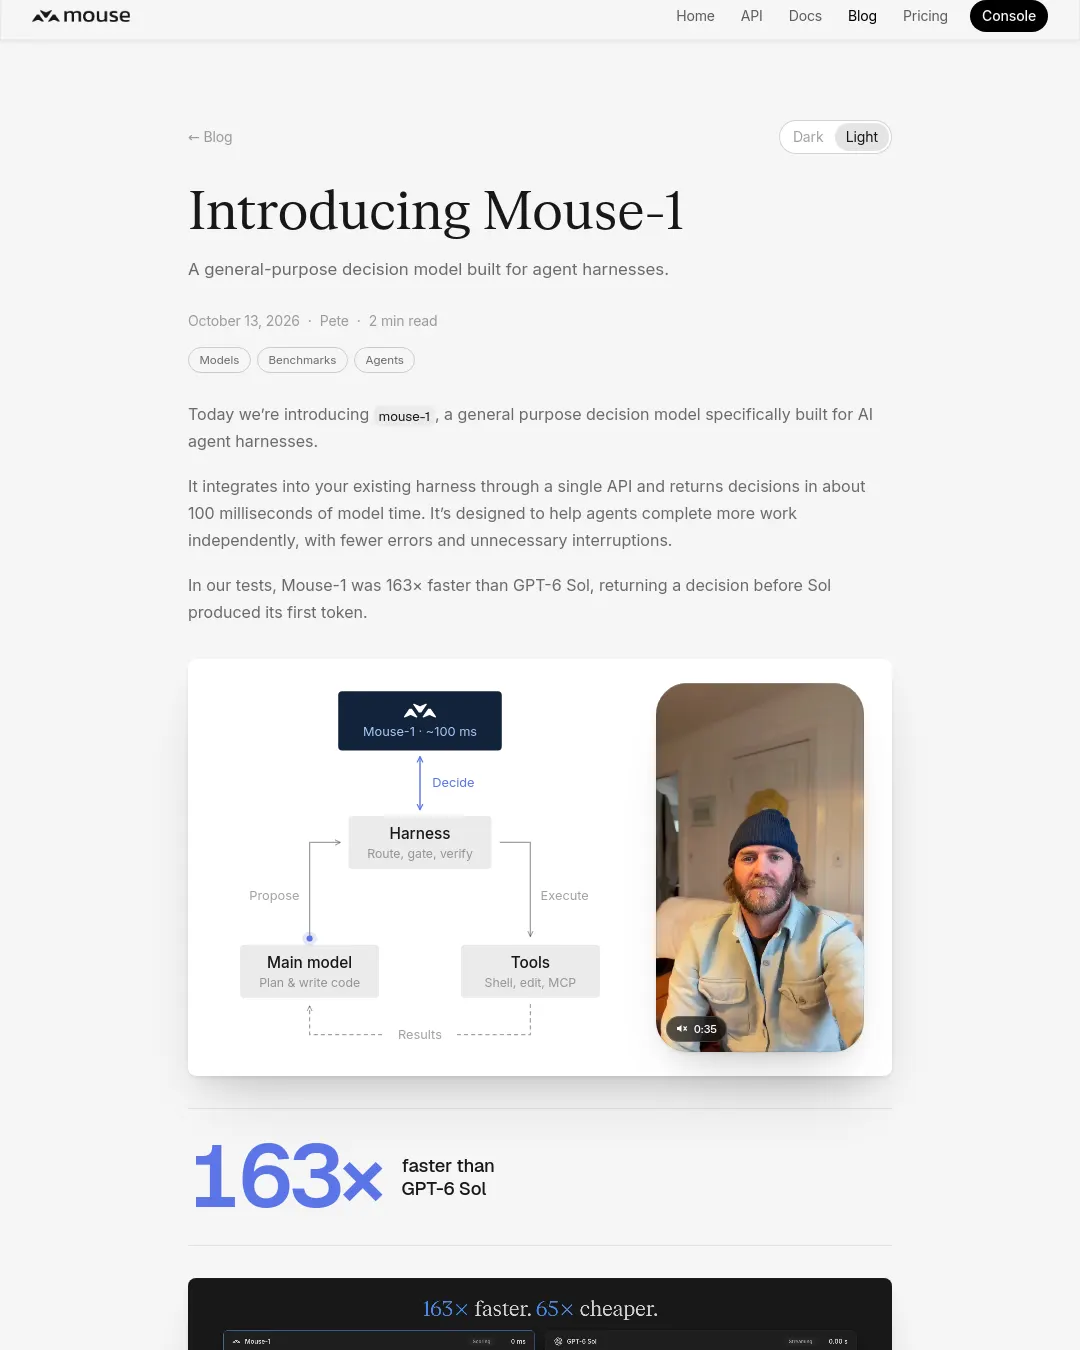
Mouse-1은 AI 에이전트가 도구 선택이나 다음 행동을 결정하도록 설계된 모델이다. 제작사는 기존 에이전트 실행 환경에 API 하나로 연결할 수 있고, 테스트에서 GPT-6 Sol보다 163배 빠르게 결정을 반환했다고 밝혔다.
제작사 평가에서 익숙하지 않은 도구와 저장소에 대한 평균 결정 정확도는 Mouse-1이 89.1%였다. 비교 대상으로 제시된 d3는 85.8%, Clef는 84.2%, OpenAI Decisions는 82.5%, d3-flash는 81.4%, Jev는 79.1%였다.
평가별로는 BFCL·API-Bank·When2Call·PhishNChips의 평균 점수에서 Mouse-1이 84.9%를 기록했다. BFCL 도구 선택 점수는 97.6%, API-Bank 도구 선택은 83.7%, When2Call에서 도구를 호출할지 판단하는 점수는 85.8%, PhishNChips 피싱 판단은 72.3%였다. 각 평가의 최고 점수는 각각 d3(86.0%), Clef(98.5%), Clef(91.9%), d3(86.4%), Clef(79.4%)였다. 이 종합 점수는 37개 작업으로 구성된 HF Decision Index와 별개라고 제작사는 설명했다.
제작사는 프롬프트 인젝션 평가에서 삽입된 지시문으로 인해 Mouse-1의 결정이 바뀐 비율이 0%였다고 밝혔다. 비교 모델의 결정 변경률은 d3-flash 27.6%, Clef 37.4%, d3 40.4%, OpenAI 53.9%, Jev 65.4%였다.
Mouse-1은 이미지 입력도 지원한다. 이미지를 같은 요청에 첨부하면 각 질문에 이미지가 반영되며, 제작사는 토큰당 가격과 확률 출력 방식이 텍스트 요청과 같다고 설명한다. 다만 이미지 입력은 베타이며, 공개된 이미지 벤치마크로 평가하지 않고 제시된 유형의 사례에서 확인했다고 밝혔다. 이미지 입력 안내
모델은 작업 맥락과 점수를 매길 선택지를 입력받아 각 선택지의 확률을 반환한다. 실행 방식은 개발자가 정하며, 어떤 결정을 사람의 검토에 맡길지도 지정할 수 있다. 제작사는 에이전트가 장시간 작동하면서 결정이 누적되는 상황에서 비용과 지연 시간을 줄이는 것을 목표로 했다고 설명한다.
제작사가 제시한 가격 비교에서 Mouse-1은 결정 1,000건당 0.10달러다. 비교 기준은 결정마다 입력 토큰 1,000개이며, 생성형 모델에는 출력 토큰 50개를 더했다. Mouse-1은 입력 토큰 100만 개당 0.10달러이고 출력은 무료다. 제작사는 자체 코딩 에이전트 실행 환경에 적용했을 때 지연 시간이 크게 개선됐다고 밝혔다.
| 모델 | 결정 1,000건당 비용 |
|---|---|
| TypeSafe Jev | $0.042 |
| Mouse-1 | $0.10 |
| OpenAI Decisions | $0.10 |
| Cloudflare Clef | $0.24 |
| Claude Haiku 4.5 | $1.25 |
| DeepSeek V4 | $1.52 |
| Gemini 3.7 Flash | $1.88 |
| Claude Sonnet 5 | $3.75 |
| Claude Opus 5 | $6.25 |
| GPT-6 Sol | $6.50 |
Mouse-1은 API로 제공되며 가격은 입력 토큰 100만 개당 0.10달러, 출력 무료다. API 안내
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요