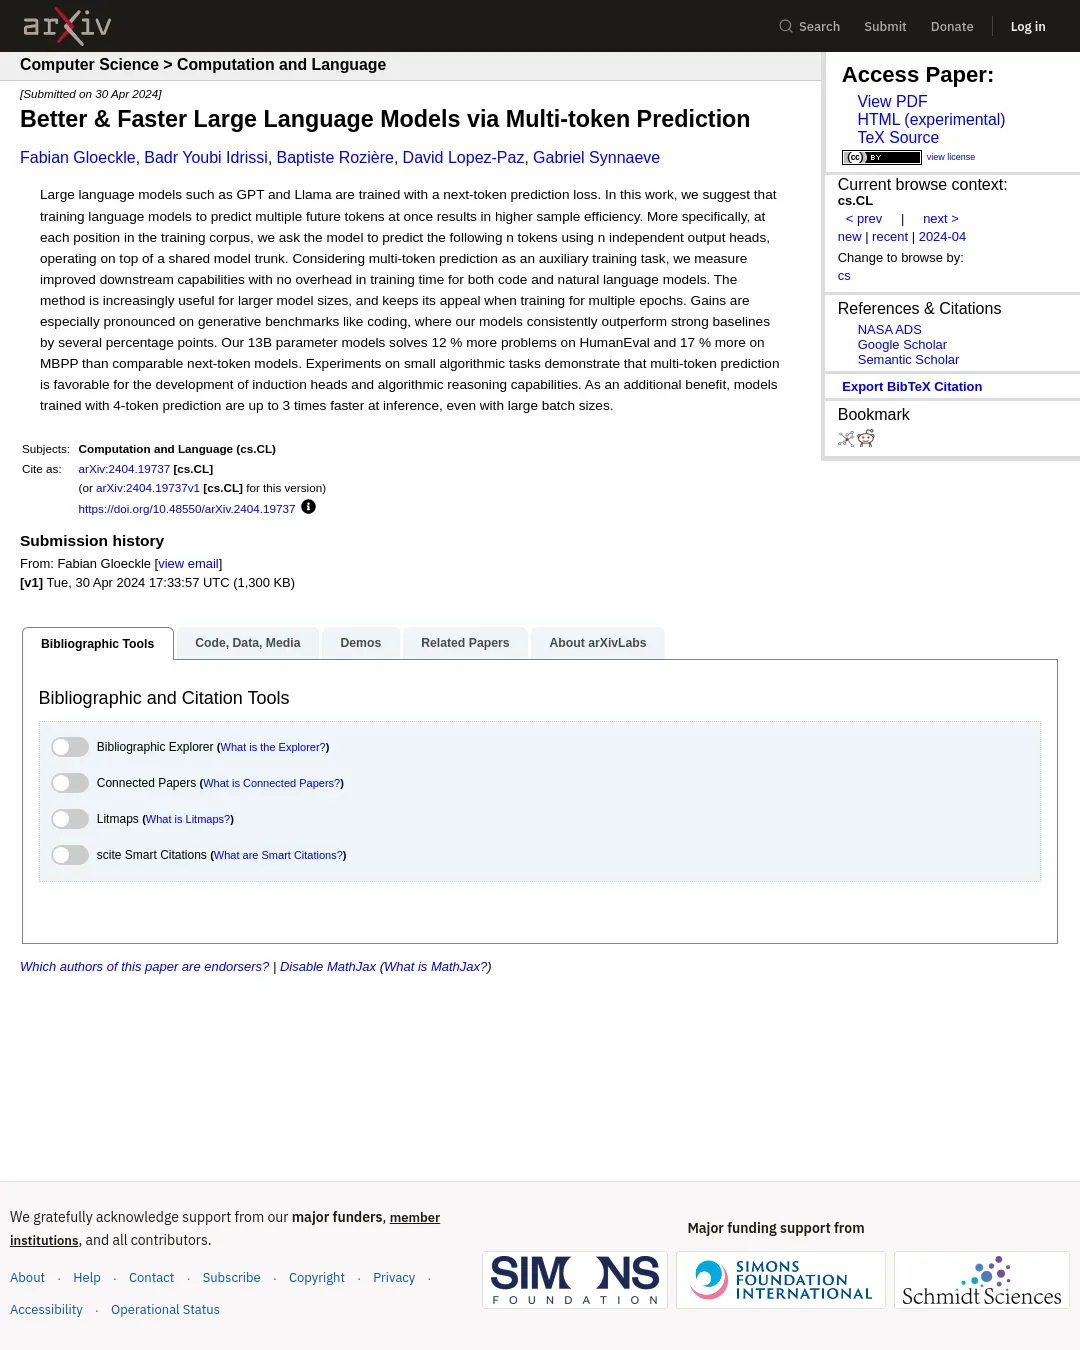
파비안 글뢰클레(Fabian Gloeckle) 등 연구진은 언어 모델이 다음 토큰 하나가 아니라 여러 개의 미래 토큰을 함께 예측하도록 학습하면, 코드와 자연어 작업에서 성능이 높아지고 추론 속도가 빨라질 수 있다고 보고했다. 2024년 4월 30일 공개된 논문에 따르면 4개 토큰 예측으로 학습한 모델은 추론 속도가 최대 3배 빨랐다.
연구진은 학습 말뭉치의 각 위치에서 공유 모델 본체 위에 둔 독립 출력 헤드들이 뒤따르는 여러 토큰을 예측하게 했다. 이를 보조 학습 과제로 적용했을 때 학습 시간에 추가 부담 없이 후속 작업 능력이 향상됐다고 설명했다. 효과는 모델이 클수록 두드러졌으며, 여러 에포크를 학습하는 경우에도 이 방식의 이점이 유지됐다.
13B 매개변수 모델은 비교 가능한 다음 토큰 예측 모델보다 HumanEval에서 12%, MBPP에서 17% 더 많은 문제를 풀었다. 연구진은 특히 코드 생성 벤치마크에서 강한 기준 모델을 몇 퍼센트포인트 앞섰다고 밝혔다. 다만 이 결과는 논문에 제시된 실험에 관한 것으로, 모든 모델이나 작업에서 같은 개선이 나타난다는 뜻은 아니다.
논문은 작은 알고리즘 과제 실험에서 다중 토큰 예측이 유도 헤드와 알고리즘 추론 능력의 발달에도 유리했다고 보고했다. 자세한 내용은 논문과 PDF에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요