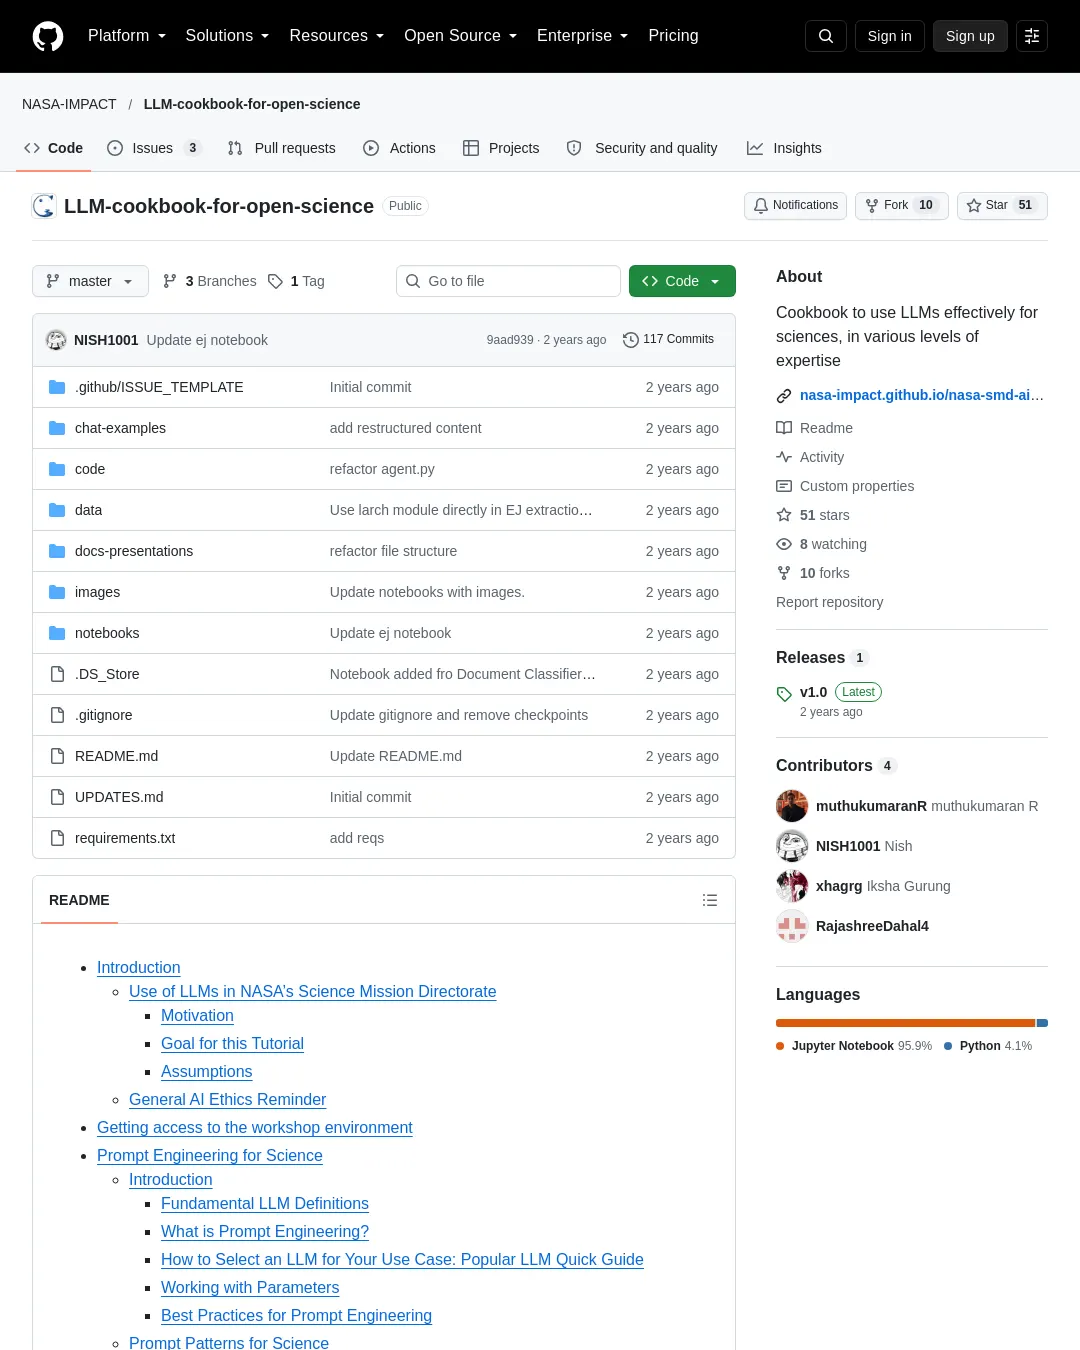
NASA IMPACT의 오픈 과학용 LLM 안내서는 과학자가 연구에서 대규모 언어 모델(LLM)을 활용하는 방법을 익히도록 프롬프트 작성부터 데이터 검색, 챗봇 프로토타입, 모델 미세조정까지 다룬다. 각 주제에는 재사용할 수 있는 프롬프트 틀과 과학 분야 예시, 활용 시 유의점이 포함돼 있다.
안내서는 LLM이 데이터와 문헌 검색, 코드 작성·수정 같은 과정의 시간을 줄이고 연구 데이터의 발견과 접근성을 높일 수 있다고 설명한다. Gentemann 등(2021)의 연구를 인용해 프로젝트 시간의 80%가 데이터 정리에 쓰이고 분석과 결과 공유에는 20%만 남는 경우가 많다고 제시한다. 다만 이 자료는 LLM의 한계를 비판적으로 살피고 윤리 지침과 안전장치를 마련해야 한다고 강조한다. 생성 결과는 사용자가 확인해야 하며 민감한 정보를 입력하지 말고, 가능한 경우 공개 모델·데이터·작업 흐름·코드를 활용하라고 권한다.
NASA 과학임무국(SMD)을 위한 교육 자료로, 검색 증강 생성(RAG), 프롬프트 엔지니어링, 인코더와 디코더 모델의 차이 등을 다룬다. 자료는 LLM과 인프라가 빠르게 바뀌므로 활용 방법과 모범 사례도 달라질 수 있다고 전제한다. 특정 플랫폼에 종속되지 않고 Azure, Bedrock, Vertex, IBM WatsonX 등을 폭넓게 고려하며, 과학계의 필요와 NASA의 오픈 과학 원칙에 부합하는 공개 모델이 앞으로 등장할 것으로 기대한다고 설명한다.
실습 환경과 프롬프트 작성
워크숍 실습 환경은 다음 순서로 준비한다.
- 자격 증명 페이지에서 접속 정보를 받은 뒤 NASA IMPACT 로그인 페이지에 접속해 로그인한다.
Applications탭에서Amazon SageMaker Studio를 열고 JupyterLab으로 이동한다.Create JupyterLab Space를 선택해 공간 이름을 지정한다. 안내서의 예시는Workshop이다.- 초기화가 끝나면 인스턴스 유형을
ml.t3.large, 저장 공간을50으로 설정하고Run Space를 누른다. 오류가 나면 이미지 설정에서Latest를 선택할 수 있다. - JupyterLab 인스턴스를 열고
https://github.com/nasa-impact/smd-llm-workshop.git저장소를 복제한다. 안내서에는 화면에서git을 선택한 다음Git Clone Repo를 누르고 저장소 주소를 붙여 넣어 복제하는 방법도 나와 있다.
프롬프트는 LLM에 요청할 때 주는 질문이나 지시다. 안내서는 첫 프롬프트를 동사로 시작하고, 원하는 결과가 나올 때까지 수정하며, 문맥을 초기화하거나 다른 지시를 주려면 긴 대화를 이어가기보다 새 세션을 시작하라고 권한다. 긴 자료는 작은 부분으로 나누고 개인정보나 민감한 정보를 입력하지 않아야 한다. 과학적 사실은 신뢰할 수 있는 동료 검토 자료와 대조하고, RAG를 쓸 때는 Science Discovery Engine 같은 선별된 출처를 활용하며 인용의 균형과 공정성도 확인하라고 안내한다. 저작권을 존중하고 독창적인 결과물을 만들며, 생성 결과의 근거를 확인하고 출처를 밝히는 것도 권고한다.
자료는 프롬프트 작성에 쓰이는 주요 개념도 설명한다. 토큰은 모델이 처리하는 입력 단위로 단어 전체나 일부 등이 될 수 있으며, 토크나이저가 텍스트를 숫자로 바꾼다. 문맥 창은 한 번의 입력·응답 과정에서 처리할 수 있는 토큰 수의 한계다. 임베딩은 단어의 의미와 문맥을 나타내는 숫자 벡터다. 모델 매개변수는 신경망에 담긴 지식과 모델 규모를 가리키지만, 모델이 클수록 성능이 항상 좋은 것은 아니다. 프롬프트 매개변수에는 응답의 창의성에 영향을 주는 온도와 최대 응답 길이 등이 있다. 미세조정은 프롬프트 엔지니어링만으로 해결하기 어려운 과제에서 모델의 동작을 개선하기 위해 수행할 수 있다.
LLM 선택에는 모든 상황에 맞는 완벽한 모델이 없으며 사용 사례와 필요에 맞춰야 한다고 안내한다. 자료에 실린 가격과 모델 규모는 안내서가 제시한 값이다.
| 모델 | 매개변수 수 | 비용 | 공개 여부 | 자료 |
|---|---|---|---|---|
| GPT-3.5 | 175 billion | 채팅 인터페이스는 무료. Turbo API는 입력 100만 토큰당 $0.50, 출력 100만 토큰당 $1.50 | 비공개·독점 | 가격 |
| GPT-4 | 1 trillion 초과 | 입력 100만 토큰당 $30.00, 출력 100만 토큰당 $60.00 | 비공개·독점 | 모델 문서 |
| GPT-4 Turbo | 1 trillion 초과 | GPT-4보다 저렴함. 입력 100만 토큰당 $10.00, 출력 100만 토큰당 $30.00 | 비공개·독점 | 모델 문서 |
| LLaMA 2: 7B | 7 billion | 해당 없음 | 공개 | Hugging Face |
| LLaMA 2: 70B | 70 billion | 해당 없음 | 공개 | Hugging Face |
| Mixtral | 7x8 billion | 해당 없음 | 공개 | Mistral 발표 |
사용 가능한 설정은 인터페이스와 선택한 모델에 따라 다르다. 안내서가 든 예로는 응답의 창의성을 조절하는 온도(보통 0~2), 응답 길이와 비용에 영향을 주는 최대 길이, 특정 문자열 뒤에 응답을 멈추게 하는 중단 시퀀스, 결과의 다양성을 조절하는 Top P(보통 0~1), 같은 표현을 반복할 가능성을 낮추는 빈도 페널티, 새로운 주제를 다룰 가능성을 조절하는 존재 페널티가 있다.
과학 연구에 활용할 프롬프트 패턴
자료는 패턴을 시작점으로 삼아 대괄호 안의 항목을 과제에 맞게 바꾸라고 안내한다. 패턴은 출력 형식 조정, 사용자와의 상호작용, 질문 개선, 오류 확인, 문맥 제어로 나뉜다. 이는 White 등의 프롬프트 패턴 카탈로그를 참고한다.
출력 형식을 조정하는 패턴에는 다음이 있다.
- 레시피 패턴은 목표와 이미 알고 있는 재료·단계를 주고, 빠진 절차까지 포함한 완전한 순서를 요청한다. 예시 프롬프트는 “나는 [과제]를 하려 한다. [A, B, C 단계]가 필요하다는 것은 안다. 완전한 단계별 절차를 제시하고 빠진 단계를 채워 달라”는 형태다. 과학 예시로는 Landsat 8 Level-1 자료의 다운로드와 지리 참조, 복사휘도로의 변환, 태양 및 대기 보정 작업을 ENVI에서 수행하는 절차, 또는 게 성운의 적외선 자료를 찾기 위해 좌표를 확인하고 여러 천문 카탈로그를 검색하는 절차가 제시된다. 자료의 평가 메모는 데이터 작업에서 답변이 충분해 보였지만 ChatGPT가 알지 못하는 더 나은 검색·작업 방법이 있을 수 있다고 짚는다. 예시
- 출력 자동화 패턴은 모델이 추천한 단계를 자동 수행할 스크립트도 만들게 해 수작업을 줄이려는 방식이다. 틀은 “[자동화할 작업]을 [조건이나 매개변수]에 따라 수행하는 스크립트를 만들고, [원하는 형식이나 언어]로 출력하라”는 내용이다. 예시는 NASA 외계행성 아카이브로 지난주 새로 확인된 행성 수와 행성명·주성명·발견 방법을 모아 CSV로 요약하기, HAPI API로 Parker Solar Probe 자료를 배열에 저장하고 JSON으로 요약하기, USGS 자료에서 규모 4.0 초과 지진의 위치·규모·깊이·잠재적 피해 지역을 모아 주간 보고서를 CSV로 만드는 작업이다. 안내서의 평가 메모는 당시 스크립트를 검증할 수 없었으며, 접근 지점이 맞아 보이는지만 확인했다고 밝힌다. 예시
- 페르소나 패턴은 특정 관점이나 직업을 맡아 답하게 한다. 틀은 “[주제나 문제]에 관한 질문에 [직업]인 것처럼 답하라”다. 중력파를 천체물리학자처럼, 가스 행성의 형성을 행성과학자처럼, 우주 비행이 생명체에 미치는 영향을 우주생물학자처럼 설명하는 예가 있다. 평가 메모에 따르면 중력파 설명을 요청했을 때 긴 문단만 나오거나 상호작용이 이어지는 등 결과가 일관되지 않았다. 설명이 과학자의 전문 용어 수준에 맞지 않을 때도 있었지만, 중력파 데이터 검증과 다중신호 천문학에 대한 기초 설명은 도움이 됐다고 적었다. 예시
상호작용을 조정하는 뒤집힌 상호작용 패턴은 모델이 사용자에게 질문하도록 해 대화를 목표로 이끈다. 틀은 “바로 설명하지 말고, [주제]를 더 잘 이해하도록 질문을 하나씩 해 달라”는 식이다. 별의 형성이나 우주 기상에 관해 질문을 주고받는 예가 있다. 평가 메모에서는 모델이 사용자의 답이 맞는지 피드백하지 않고 질문만 하거나, 하나씩 묻는 대신 질문 10개를 한꺼번에 제시하는 경우가 있었다고 한다. 예시
질문 개선 패턴은 사용자가 더 구체적이고 분명한 질문을 만들도록 돕는다. “원래 질문을 [관심 있는 세부 사항]에 초점을 맞춰 더 구체적이고 명확하게 다듬어 달라”는 틀을 쓴다. 번개 형성에서 얼음 입자의 역할, 우주 비행이 유전자에 미치는 영향이 예시다. 평가 메모는 다듬은 질문을 그대로 다시 입력하면 모델이 답을 하기보다 질문의 명확성을 논하는 경우가 많았으며, 답을 원한다면 “다음 질문에 답하라”고 분명히 지시해야 했다고 설명한다. 예시
대안 접근법 패턴은 문제를 해결할 여러 방법을 요청한다. 특정 문제에 적용할 수 있는 자료·방법·도구·알고리즘을 고려해 서로 다른 접근법을 제시하라고 한다. 우주에서 지구를 연구하는 방법, 외계행성을 탐지하는 방법, 지구 표면 반사도를 구하는 방법이 예시다. 예시
인지 검증 패턴은 질문을 작은 하위 질문으로 나누도록 한다. 여러 측면을 살펴 더 충분한 답변을 얻도록 “[처음 질문]을 이해하는 데 도움이 될 하위 질문을 제안하라”는 식으로 요청한다. 개기일식 중 일어나는 일이나 천체물리학의 신흥 연구 분야가 예시다. 안내서의 평가 메모는 이 패턴이 잘 작동하고 사용하기도 간단했다고 말한다. 예시
오류 확인용 사실 점검 목록 패턴은 답변의 근거가 된 사실을 나열하게 해 사용자가 결과를 검증하도록 돕는다. “앞으로 답변을 만들 때마다 답변에 필요한 사실을 모아 출력 끝에 점검 목록으로 제시하라”는 틀을 사용한다. 우주 기상이 지구에 미치는 영향과 금성의 온실가스 효과가 예시다. 안내서의 평가 메모에서는 목록을 후속 질문에 활용할 수 있었지만, 특정 사실만 포함하라는 제한은 잘 작동하지 않았고 결과가 사실 목록이라기보다 후속 질문이나 검색어에 가까울 때도 있었다고 설명한다. 예시
문맥 관리자 패턴은 대화에서 포함하거나 제외할 정보를 지정한다. “[주제]를 설명할 때 [하위 주제]만 다루고 [다른 하위 주제]는 무시하라”는 형식이다. 외계행성 탐지에서 중력렌즈 방식만 다루고 통과 방식을 제외하기, 번개 중 화산 분출로 발생한 경우만 다루기, 금성의 온실효과만 살피기 등이 예시다. 평가 메모는 “통과 방식을 무시하라”처럼 짧고 느슨하게 요청했을 때도 모델이 통과 방식을 답변에 포함했다며, 지시를 구조화할 필요가 있다고 지적한다. 예시
여러 패턴을 결합하면 복잡한 과제에 쓸 수 있다. 안내서는 페르소나·레시피·출력 자동화 패턴을 조합해 과학 데이터 거버넌스와 관리에 관한 요구사항 문서나 절차 계획을 만드는 예를 든다. Modern Scientific Data Governance Framework(mDGF)를 참고 자료로 삼아 정부 지침과 조직 정책에 관한 질문에 답하거나 문서를 작성한다. 제공된 참고 문서만 사용하고 답변의 근거가 된 구절을 인용하도록 지시한다. 답을 찾지 못하면 “답을 찾지 못했다”고 하고, 범위 밖 질문에는 “이 질문은 내가 답할 수 있는 범위 밖이다”라고 응답하게 한다. 문서 작성을 요청받으면 먼저 프로젝트의 핵심 자산(데이터, 메타데이터, 디지털 콘텐츠, 코드, 소프트웨어), 거버넌스 활동(기획·설계, 모니터링, 생성·큐레이션, 공유, 사용·재사용, 보존), 필요한 문서 유형(요구사항 또는 절차)을 차례로 묻는다. 프로젝트 필요 사항은 Entities/Assets, Governance Activities, Type 키를 가진 JSON 형식으로 기록하도록 한다. 노트북 예시
프로토타입과 데이터 검색
LangFlow를 이용한 활동은 오픈사이언스 데이터 저장소(OSDR)용 RAG 챗봇의 빠른 프로토타이핑을 다룬다. OSDR은 GeneLab과 Ames Life Sciences Data Archive(ALSDA)를 포함한 NASA 우주생물학 데이터에 공개적으로 접근할 수 있는 저장소다. 이 데이터로 미세중력, 방사선 등 우주 환경에 노출됐을 때 DNA·RNA·단백질·대사산물이 어떻게 변하는지 살펴볼 수 있다. 안내서는 Science Discovery Engine(SDE)의 신뢰할 수 있도록 선별된 NASA SMD 자료를 검색 기반으로 삼고, 사전 구축된 LangFlow 구성요소를 이용해 설정을 최소화하는 방식을 제시한다.
기존 작업 흐름 템플릿을 사용하거나 직접 만들고, SDE 검색기를 특정 주제에 맞게 조정한 뒤 채팅 화면이나 Python 인터페이스로 챗봇과 상호작용한다. 평가 활동에서는 Promptlab의 흐름을 Jupyter Notebook으로 내보내 SDE 검색기의 검색 성능을 정량 평가하고 챗봇 답변의 품질을 정성 평가한다. 과학자는 권위 있는 분야별 자료를 직접 검색해 작업을 효율화할 수 있고, 데이터 관리자는 선별된 자료를 챗봇 개발에 활용하는 방법을 살펴볼 수 있다는 것이 안내서의 설명이다. OSDR · SDE · 평가 노트북
LangFlow는 LangChain을 활용해 빠르게 실험하고 프로토타입을 만드는 도구다. 그래픽 사용자 인터페이스에서 드래그 앤 드롭 방식으로 작업 흐름을 구성하고, 내장 채팅 화면에서 실시간으로 상호작용할 수 있다. 프롬프트 매개변수와 체인·에이전트를 편집하고 처리 과정을 추적하거나 작업 흐름을 내보내는 기능도 소개한다. IMPACT ML-and-Dev 팀이 개발·관리하는 Promptlab은 이를 수정한 인스턴스로, LLM 작업 흐름을 만들고 공유하기 쉽게 하며 RAG에 SDE 자료를 연결하는 사용자 지정 커넥터와 재사용 가능한 사전 정의 작업 흐름을 제공한다. LangFlow · Promptlab
LangChain을 활용한 지구과학·천체물리학 데이터 검색 활동은 자연어 질의로 자료와 관측값을 찾는 앱을 만드는 방법을 다룬다. 지구과학자는 특정 지역·기간의 현상 자료를 찾을 수 있다. 예시는 “2005년 로스앤젤레스 지역의 오존 자료를 찾고 싶다”는 검색이다. 천체물리학자는 특정 천체 주변의 자료나 관측값을 찾으며, 예시로 남쪽고리성운에서 1각분 이내의 자료 검색을 든다. 초보자는 천체의 교차 식별 정보를, 숙련자는 관련 서지 코드로 논문을 검색할 수 있다.
지구과학 자료 검색에는 Common Metadata Repository(CMR)를, 천체물리학 검색에는 SIMBAD와 ADS 등을 포함한 Astroquery 서비스를 사용한다. LangChain으로 기존 데이터·정보 시스템을 연결하고 ReACT 패턴으로 상호작용을 조정한다. 안내서는 LLM과 호환되는 도구를 정하고, 구조화된 데이터 상호작용을 구현하며, 정확성과 신뢰성을 정량 검증하라고 권한다. 체인은 논리적으로 나눌 수 있는 각 처리 단계를 연결하는 데 쓰고, 에이전트 작업 흐름은 가능한 한 단순하게 유지한다. 공개 모델을 시험하고 모델 버전별 성능과 추론 비용을 비교하며, 앱을 공개할 때는 API 키 보관과 배포 확장성을 고려해야 한다. 체인이 실패하거나 에이전트가 환각을 일으킬 수 있다고 가정해 대체 경로를 마련하고 사용자 기대를 조정하라고도 안내한다. LangServe는 앱을 RESTful 서비스로 배포하는 확장 기능, LangSmith는 체인과 에이전트를 디버깅하고 평가하는 도구로 소개된다.
자료에는 CMR 에이전트와 천체물리학 에이전트의 노트북 예시가 각각 있다. 또 Astro 에이전트 노트북도 제공한다. LangChain은 모델·프롬프트 패턴·정보 저장소를 연결해 LLM 기반 앱을 만드는 오픈소스 프레임워크이며, LangFlow와 Promptlab의 기반이자 앱 개발자가 독립적으로 사용할 수 있는 도구라고 설명한다. Hugging Face 모델과 데이터셋을 연결할 수 있고 OpenAI, Vertex AI, Azure, AWS Bedrock, Hugging Face 모델 사이를 바꿀 수 있다고 안내한다.
NASA SMD 인코더 모델 미세조정
마지막 활동은 기존 NASA SMD 인코더 모델을 과학 주제별 데이터 큐레이션에 맞게 조정하는 방법을 다룬다. 방대한 과학 자료에서 주제와 관련된 데이터를 골라내면 연구 초보자나 새 분야에 들어가는 사람의 검색을 도울 수 있다는 취지다. 예시 과제는 환경 정의 지표 자료를 분류해 SDE에서 주제별 검색 앱을 만드는 것이다. 인코더 모델과 라벨이 붙은 학습 자료로 분류기를 훈련하고, 디코더 모델 및 원샷·퓨샷 학습과 비교한 뒤 정량 평가를 수행한다.
자료는 인코더 모델 미세조정을 사전 학습 모델에 과제별 계층을 연결하고 과제별 데이터로 모델을 훈련하는 방식으로 설명한다. 텍스트 분류, 개체명 인식, 요약처럼 입력을 구조화된 출력으로 바꾸는 작업에 적합하며, 출력이 다른 모델이나 시스템으로 이어지는 더 큰 처리 과정의 일부로 쓰일 때 강점을 보인다고 안내한다. 분류 노트북
디코더 모델은 과제별 예시를 학습해 입력에 맞는 자유 형식의 텍스트를 생성하도록 미세조정한다. 질의응답, 텍스트 생성, 대화 시스템, 함수 호출 같은 작업에 적합하고, 모델의 출력이 최종 결과인 독립 시스템에서 쓰일 때 강점을 보인다고 설명한다. 디코더 모델 전체를 처음부터 끝까지 미세조정하는 방법은 비용이 지나치게 많이 들고 사전 학습 과정에서 얻은 연결을 손상시킬 수 있다. 대신 저랭크 적응(LoRA)으로 매개변수 일부만 갱신하면 계산 비용을 줄이면서 원래 능력을 보존할 수 있다고 안내한다. 추출 노트북
미세조정 모범 사례로는 양보다 품질을 중시해 라벨이 붙은 데이터를 정리하고, 필요하면 노이즈 추가·자르기·합성 데이터 생성 등으로 다양성을 높이는 방법이 제시된다. 데이터 규모와 복잡성에 맞는 모델을 선택해 과적합과 과소적합을 피하고, 마지막 몇 개 계층부터 미세조정한 뒤 앞쪽 계층을 점진적으로 풀어 학습할 수 있다. 사전 학습 지식의 급격한 망각을 막도록 작은 학습률을 쓰고, 검증 손실이 오르기 시작하면 조기 종료하며 최적 모델을 체크포인트로 저장하라고 한다. 드롭아웃·가중치 감소·배치 정규화와 역번역, 바꿔 쓰기, 단어 마스킹 같은 데이터 증강 기법도 열거한다.
최적화에는 AdamW 같은 적응형 학습률 최적화기를 사용할 수 있으며, 과제에 맞는 평가 지표를 선택해야 한다. 데이터와 모델 버전은 DVC로 관리하고, MLflow나 Weights & Biases 같은 도구로 실험을 기록하고 진행 상황과 결과를 비교하는 방법도 제안한다. 전체 안내서와 워크숍 자료
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요