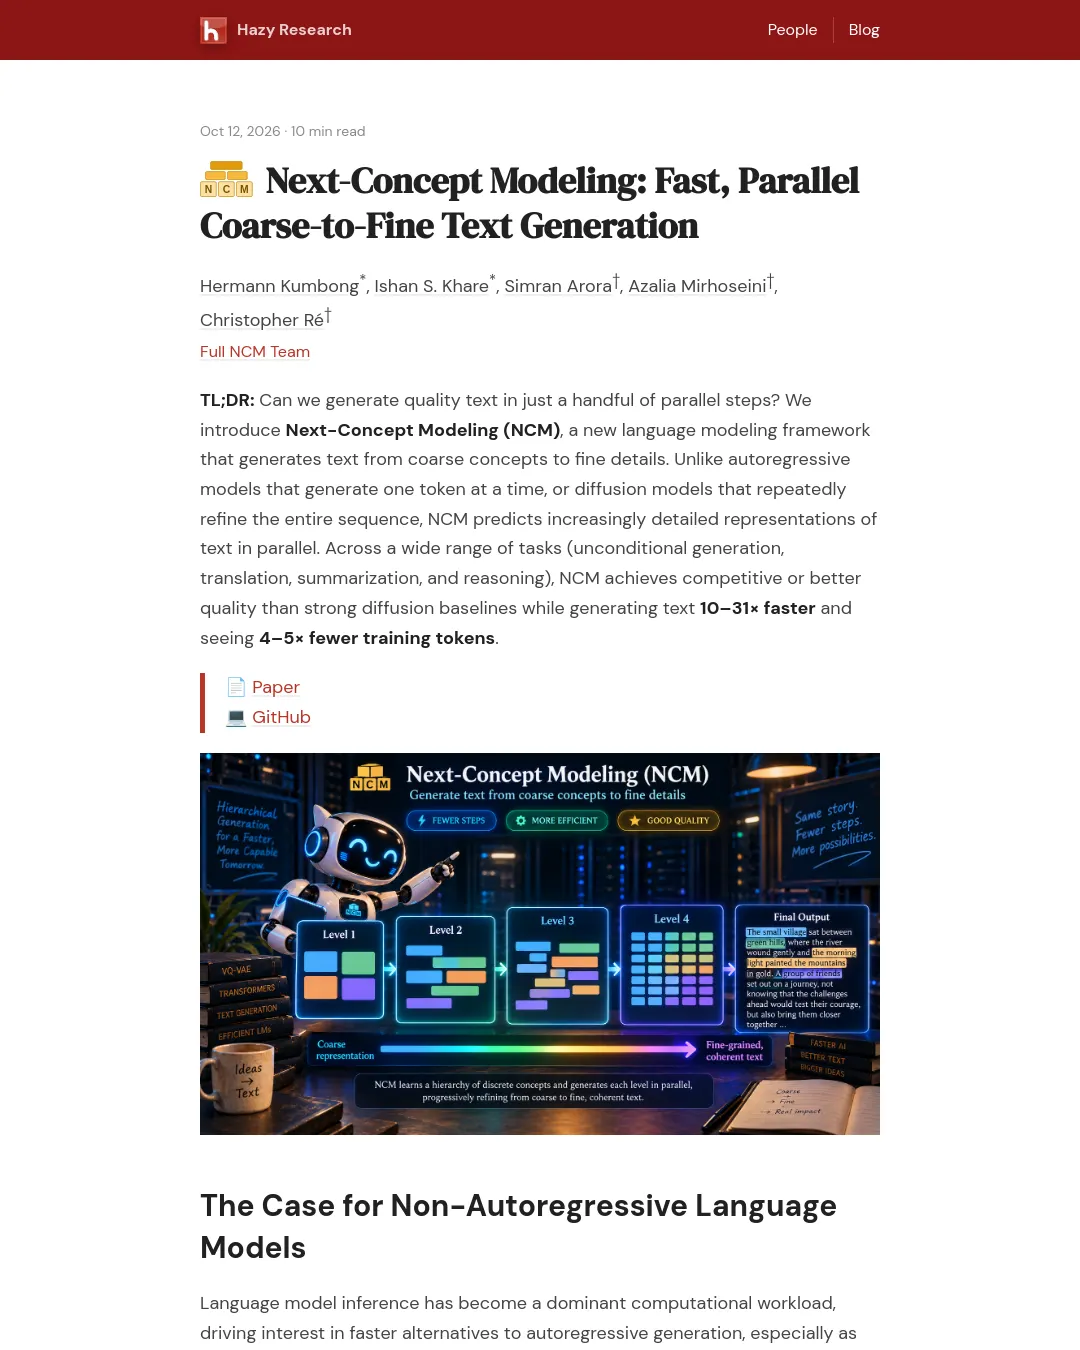
스탠퍼드 연구팀이 텍스트를 큰 개념에서 세부 표현으로 단계적으로 생성하는 언어 모델 프레임워크 Next-Concept Modeling(NCM)을 소개했다. 연구팀은 여러 과제에서 강력한 확산 언어 모델과 비슷하거나 더 나은 품질을 내면서 생성 속도는 10~31배 빠르고 학습 토큰은 약 4~5배 적게 썼다고 보고했다.
NCM은 텍스트를 거친 표현부터 세밀한 표현까지 이어지는 이산 코드의 계층으로 나타낸다. 먼저 다중 스케일 토크나이저가 이 표현을 만들고, 다음 단계에서는 트랜스포머가 앞선 단계의 복원 결과를 바탕으로 각 계층의 코드를 병렬 예측한다. 생성된 코드 계층은 토크나이저가 텍스트로 복원한다. 한 번에 토큰 하나씩 생성하는 자기회귀 모델이나 매 단계 전체 시퀀스를 다듬는 확산 모델과 다른 접근이다.
연구팀은 TinyStories, One Billion Word(LM1B), OpenWebText에서 언어 모델링을 평가했고, WMT14 독일어-영어 번역과 XSum 요약, 스도쿠 추론도 시험했다. 언어 모델링에서는 강력한 기준선과 비슷하거나 더 나은 품질을 11배 적은 함수 평가 횟수로 얻었다고 보고했다. NVIDIA H100 SXM 80GB GPU에서 비조건부 생성은 LM1B에서 21배, OpenWebText에서 10배 빨랐으며, XSum에서는 기준선의 ROUGE-L 점수를 맞추면서 31배 빠르게 생성했다고 밝혔다.
스도쿠에서는 모든 난이도에서 자기회귀 및 확산 기준선보다 높은 성능을 보였고 함수 평가 횟수도 더 적었다. 다만 연구팀은 개념에서 세부로 생성하는 방식이 전체 계획 수립에 도움이 된다는 설명을 가설로 제시했다. 모델 규모를 키운 결과는 예비 결과라고 밝혔으며, 토크나이저와 생성기를 함께 학습하거나 문제 난도에 따라 계산량을 조절하는 방안은 향후 과제로 남겼다.
학습 토큰은 LM1B에서 확산 기준선보다 약 4.9배, OpenWebText에서 약 4배 적게 사용했다. 이 수치에는 토크나이저와 생성기의 학습이 모두 포함된다. 연구팀은 결과의 세부 내용과 실험을 논문에 공개했으며, 구현은 GitHub 저장소에서 확인할 수 있다. 비교·평가에는 VAR의 이미지 접근법을 참고해 텍스트용 토크나이저를 구성했고, 데이터셋으로 TinyStories, One Billion Word, OpenWebText를 사용했다. 연구팀은 생성 품질 평가에 생성 퍼플렉시티만으로는 충분하지 않을 수 있다는 점도 언급했다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요