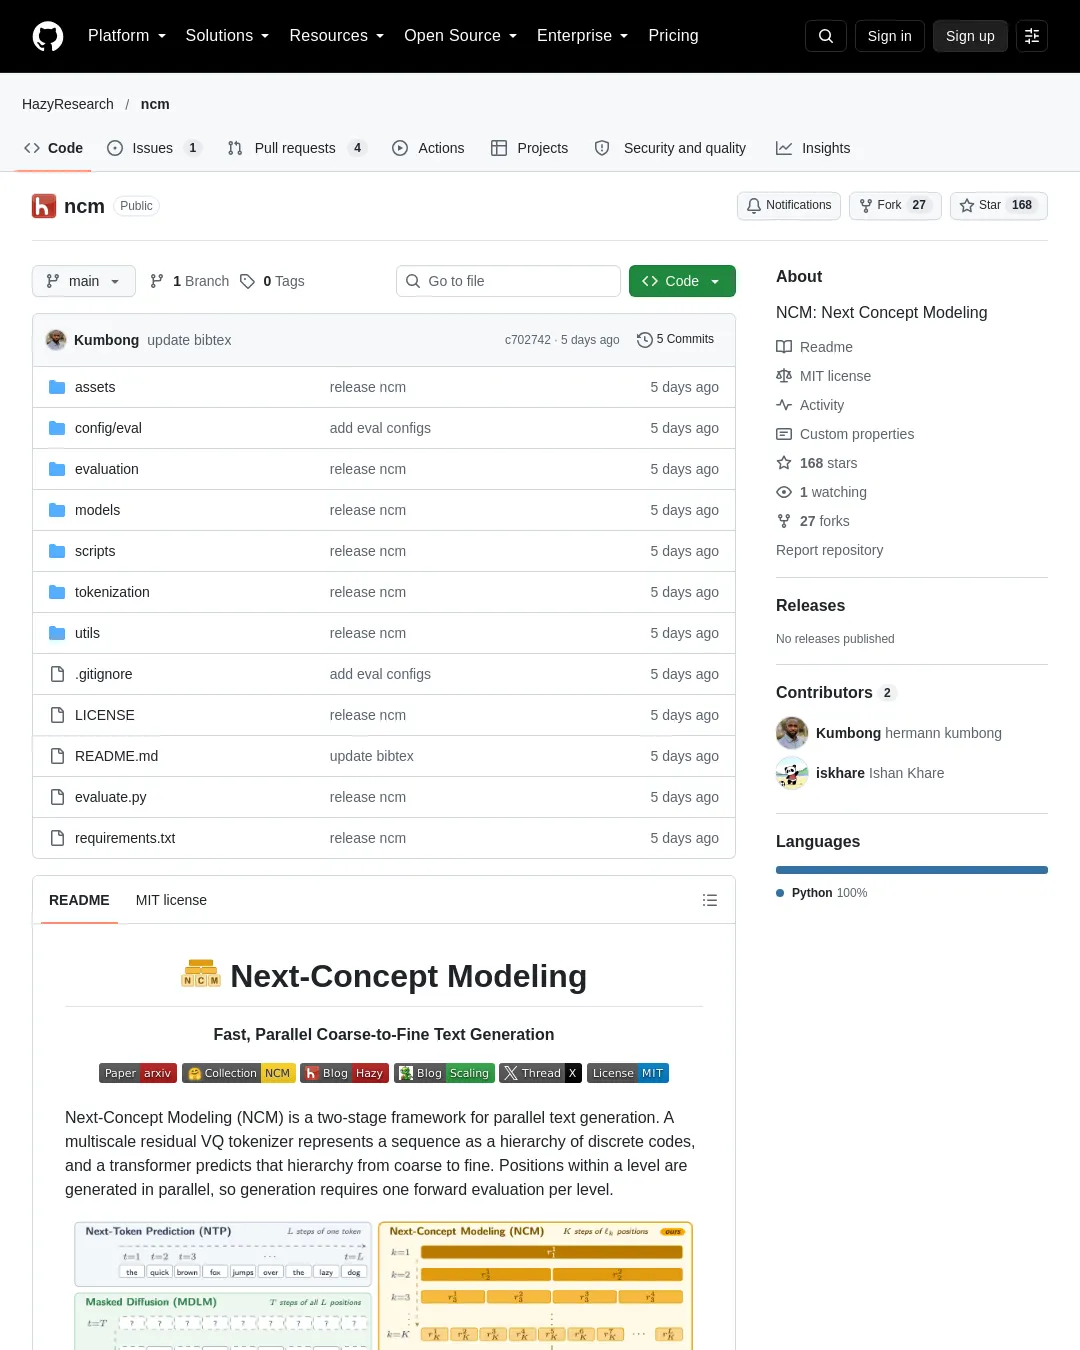
HazyResearch가 공개한 Next-Concept Modeling(NCM)은 텍스트를 여러 단계로 나눠 병렬 생성하는 프레임워크다. 저장소는 여러 작업과 데이터셋에서 강력한 확산 모델 기준선과 같거나 더 나은 품질을 내면서 9~31배 빠르게 생성한다고 설명한다.
NCM은 다중 스케일 잔차 벡터 양자화(VQ) 토크나이저로 텍스트를 단계별 이산 코드로 나타내고, 트랜스포머가 이를 거친 표현부터 세밀한 표현까지 예측한다. 각 단계 안의 위치는 병렬로 생성하며, 전체 생성에는 단계 수만큼의 순전파 평가가 필요하다.
모델 가중치와 토큰화된 데이터셋은 Hugging Face 컬렉션에서 제공한다. 공개 모델은 고정된 토크나이저와 다음 개념 생성기로 구성된다. 대상 작업과 데이터셋은 XSum, WMT14 De–En, 스도쿠 난이도별 모델, LM1B, TinyStories, OpenWebText다. 논문은 arXiv에서, 구현과 평가 설정은 GitHub 저장소에서 확인할 수 있다.
설치에는 Python 3.10 이상과 CUDA를 지원하는 PyTorch 환경이 권장된다.
git clone https://github.com/HazyResearch/ncm.git
cd ncm
pip install -r requirements.txt
체크포인트와 평가 입력을 내려받은 뒤 작업에 맞는 설정으로 평가를 실행한다.
hf download hazyresearch/ncm-checkpoints --local-dir artifacts
hf download hazyresearch/ncm-datasets --repo-type dataset --local-dir data
python evaluate.py --config config/eval/<task>.yaml --checkpoint-dir artifacts/<task> --data-dir data/<task>
# <task> is one of xsum, wmt14, sudoku-easy, sudoku-medium or sudoku-hard

python evaluate.py --config config/eval/<dataset>.yaml --checkpoint-dir artifacts/<dataset>
# <dataset> is tinystories, owt or lm1b-<size> with <size> one of small, medium or large
평가 스크립트는 GPU별 생성 결과를 합쳐 작업별 지표를 출력한다. XSum은 ROUGE와 생성 퍼플렉시티, WMT14는 sacreBLEU·chrF·길이 비율, 스도쿠는 해결률·셀 정확도·유효 격자 비율을 측정한다. TinyStories, OpenWebText, LM1B는 5개 시드에서 각각 256개의 무조건부 샘플을 생성해 GPT-2 large 기준 생성 퍼플렉시티와 단어 단위 엔트로피를 계산하며, LM1B에는 FLM 점수 산정 프로토콜을 적용한다. XSum과 WMT14에는 --cfg <scale>로 classifier-free guidance를 추가할 수 있고, 안내된 WMT14 결과는 --cfg 1.0을 사용한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요