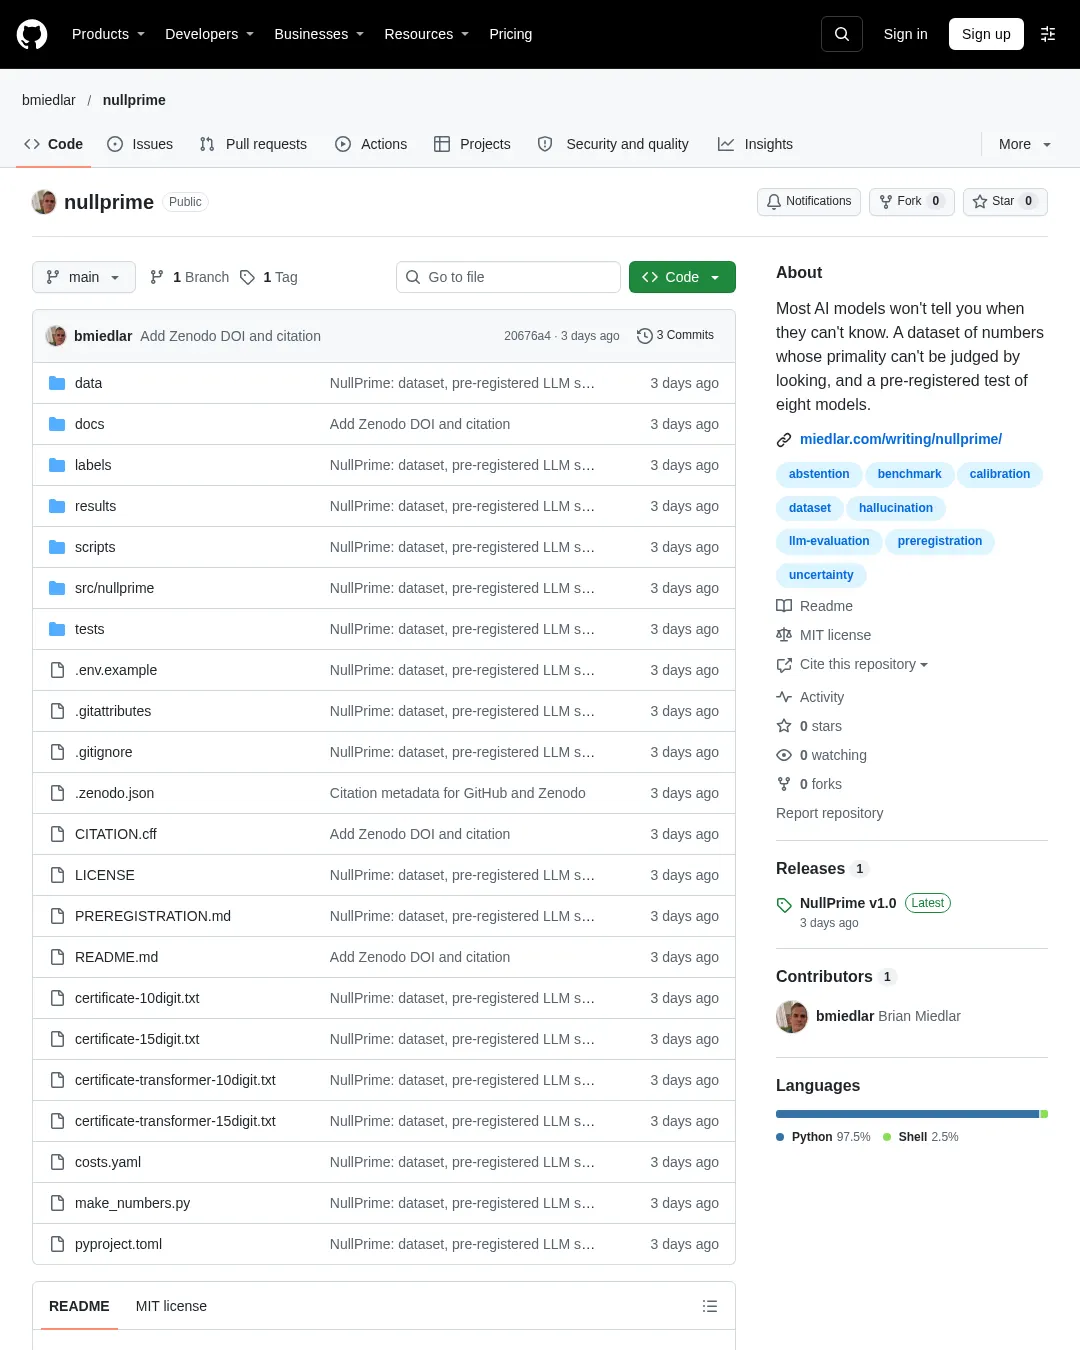
NullPrime은 숫자만 보고 소수인지 합성수인지 알아낼 수 없도록 만든 평가 자료다. 이를 이용한 대규모 언어 모델(LLM) 시험에서는 일부 모델이 답을 모른다고 밝히기보다 거의 모든 문제에 판정을 내렸고, 코드 도구를 쓸 수 있을 때는 대부분 높은 정답률을 보였다.
NullPrime의 각 항목은 소수 또는 합성수로 라벨링한 정수다. 모든 수에서 B보다 작은 소인수는 걸러냈으며, 각 라벨의 비율은 절반씩이다. 일반적인 수에서 소수 여부를 가늠하는 작은 소수로 나누어떨어지는지의 패턴을 제거한 셈이다. 라벨은 무작위가 아니다. 정확하고 결정적이며 짧은 프로그램으로 확인할 수 있지만, 숫자가 표현된 방식만으로는 추론할 수 없다.
이 자료는 불확실성 추정, 답변 보류, 선택적 예측, LLM 보정 등 모델이 모르는 것을 알아차린다고 주장하는 방법을 시험하기 위한 대조군이다. 제작자 브라이언 미들라(Brian Miedlar)는 NullPrime 저장소와 연구 설명을 공개했다.
10자리 수, B=1000 조건에서 각 분할에 3,000개씩을 사용하고, 학습·시험 데이터를 70 대 30으로 나눠 시드 5개로 반복한 인증 결과는 다음과 같다. 신뢰구간은 시험 정확도를 합산한 값의 95% 구간이며, 우연히 맞힐 때의 기준은 0.500이다.
| 학습기 | null 학습 | null 시험 | contrast 시험 |
|---|---|---|---|
| 로지스틱 회귀 | 0.546 | 0.498 ± 0.010 | 0.691 |
| 랜덤 포레스트 (400) | 1.000 | 0.503 ± 0.010 | 0.926 |
| 그래디언트 부스팅 | 0.995 | 0.499 ± 0.010 | 0.922 |
| k-최근접 이웃 (15) | 0.603 | 0.497 ± 0.010 | 0.622 |
| MLP (256,128) | 1.000 | 0.503 ± 0.010 | 0.699 |
| 숫자 트랜스포머 (2개 층) | 0.797 | 0.499 ± 0.010 | 0.580 |
contrast는 같은 범위와 특성을 사용하되 필터를 적용하지 않은 분할이다. 같은 학습기들이 이 분할에서는 62~93%를 기록했다. NullPrime 제작자는 이를 근거로 학습기 자체가 작동하며, 필터가 소수 여부의 신호를 제거한다고 설명한다. 유연한 학습기는 학습 데이터에서 0.99~1.00의 정확도를 내지만, 새 숫자에서는 우연 수준에 머문다.
인증에는 각 숫자의 마지막 12자리와 처음 40개 소수(2부터 173까지)로 나눈 나머지 등 숫자당 52개 특성을 사용했다. 숫자 트랜스포머는 숫자를 자릿수 토큰으로 바꾸고 왼쪽을 채워 16자리로 만든 뒤, 2층 트랜스포머 인코더로 처리했다. 15자리 조건에서는 null 0.501, contrast 0.575를 기록했다. 제작자는 트리 모델에는 나머지 값이 직접 주어지지만 트랜스포머는 원래 숫자에서 나눗셈 가능성을 파악해야 하므로 차이가 난다고 설명한다. 두 분할을 같은 모델로 비교하면 각 시드에서 각각 0.50과 0.58 수준이었다.
NullPrime에는 세 분할이 있다. null은 B보다 작은 모든 소수와 서로소인 소수·합성수를 균형 있게 담은 대조군이고, contrast는 같은 범위에서 필터를 적용하지 않아 제거된 신호를 확인하는 데 쓰인다. easy에는 13 이하의 소인수를 가진 합성수가 들어간다. 데이터 설정은 10자리([1e9, 1e10), B=1000)와 15자리([1e14, 1e15), B=10,000)다.
LLM 시험은 OSF에 2026-10-17 사전 등록됐다(등록 기록, 시험 절차). 어려운 숫자 조건에서 모델별로 300개를 시험한 결과, 평범하게 답을 물었을 때 8개 모델 중 5개는 거의 모든 문제에 판정을 내렸고, 그중 절반가량은 틀린 답을 사실처럼 제시했다. 판정에 틀린 소인수를 근거로 든 경우도 많았으며, 정답을 맞힌 경우에도 그런 오류가 나타났다.
답변으로 ‘판단할 수 없다’를 허용하자 Haiku, Sol, 두 Gemini 모델과 gpt-oss는 어려운 숫자의 91~100%에서 답을 보류했다. Opus는 64%, DeepSeek는 34%였고 GPT-6 Luna는 한 번도 보류하지 않았다. 쉬운 숫자에서는 거의 아무도 답을 보류하지 않았다. 질문에 언급하지 않은 코드 도구를 사용할 수 있게 했을 때는 거의 모든 모델이 도구를 사용해 89~100% 정답률을 보였다. 추론 기능을 켜자 Haiku의 확신에 찬 오답 비율은 9%에서 0%로 줄었지만, Luna·Argon·DeepSeek는 40~49%를 유지했다. 전체 결과와 조건은 연구 설명에서 확인할 수 있다.
직접 새 숫자를 만들려면 의존성 없는 파이썬 파일인 make_numbers.py를 내려받아 실행할 수 있다. 직접 생성한 숫자는 공개된 자료가 향후 학습 데이터에 들어갈 가능성을 피하는 데 도움이 된다고 제작자는 설명한다.
python make_numbers.py 50 15
명령은 15자리 숫자 50개를 만들며, 소수는 절반이고 10,000보다 작은 소인수는 없다. 답은 answers.csv에 기록된다. 공개 데이터는 10자리 null, 10자리 contrast, 10자리 easy, 15자리 null, 15자리 contrast, 15자리 easy에서 내려받을 수 있다. 대화형 AI에 숫자를 붙여 넣고 소수인지 물어보는 시험용 예시와 답은 문서에 있다.
이 결과는 소수 판정이 어렵다는 뜻이 아니다. Miller-Rabin은 마이크로초 단위로 정확한 답을 낸다. 또 제작자는 이를 인식론적 불확실성으로 보지 않는다. 제공된 특성에는 소수 여부에 관한 정보가 없으므로 데이터를 더 모아도 도움이 되지 않는다는 설명이다. 현상 자체도 새롭지는 않으며, 제작자는 선행 연구 정리에서 Zhang 등(2017), Charton(2024), Lowry-Duda(2025)를 언급한다. 이번 공개의 새 점으로는 균형을 맞추고 검증할 수 있는 대조군과 LLM 시험 절차를 꼽는다.
시험의 전체 모델 답변 18,642건은 저장소의 결과 파일에 공개됐다. 프롬프트와 답변, 판정, 확신도, 언급한 소인수와 나눗셈 여부, 도구 호출 등이 담겼다. 규칙으로 판독하기 어려운 답변의 수동 라벨은 labels 디렉터리에 있다. 코드 라이선스는 MIT, 데이터 라이선스는 CC-BY-4.0이며, 데이터셋은 Zenodo에 등록됐다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요