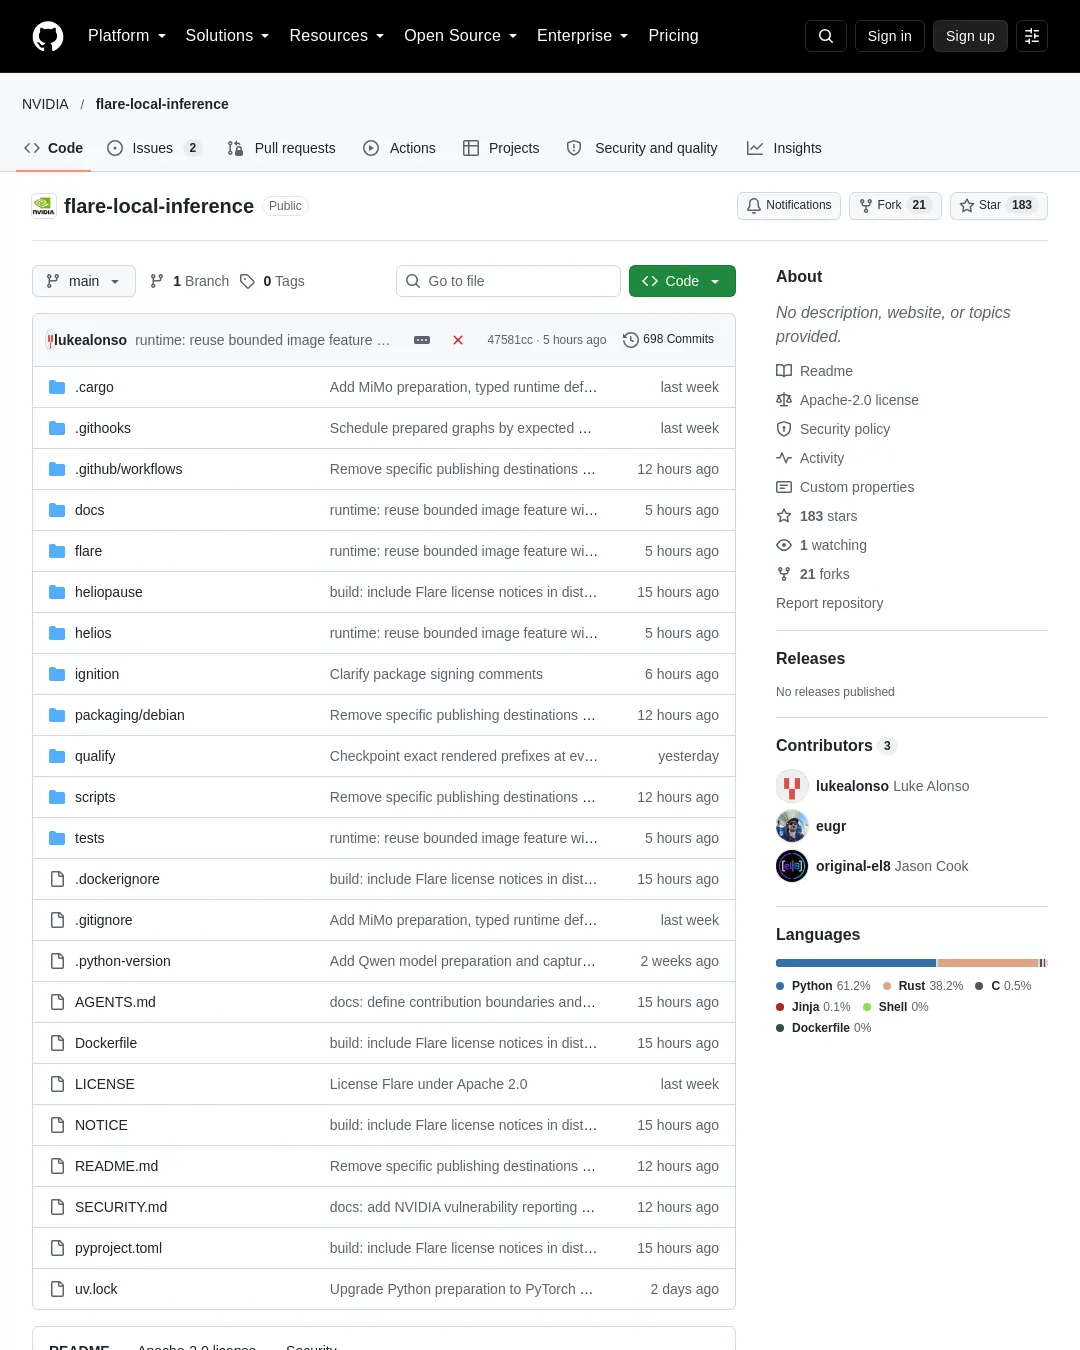
엔비디아의 Flare는 SM120·SM121 GPU를 탑재한 시스템에서 긴 대화, 코딩 에이전트, 반복적인 도구 사용을 겨냥한 로컬 추론 서버다. 지원 모델과 준비된 용량이 정해져 있어, 해당 범위에 맞는 워크스테이션이나 DGX Spark 같은 소형 시스템에서 사용할 수 있다.
Flare는 모델 준비 단계에서 PyTorch, Transformers, FlashInfer/b12x를 사용해 모델을 불러오고 커널을 조정하며 실행을 컴파일하고 CUDA 그래프를 캡처한다. 준비 작업은 서비스 시작 전에 끝난다. 이후 Rust 기반 Helios 실행 환경이 Python 없이 준비된 패키지를 서비스한다. 모델별 계산은 모델 레시피가 맡고, 실행 환경은 스케줄링과 캐시 저장, 요청 처리를 담당한다.
Flare는 더 많은 모델과 하드웨어, 배포 방식을 지원하는 vLLM보다 범위를 좁혀 일부 모델과 로컬 작업에 집중한다. 따라서 실제로 실행할 수 있는 모델은 지원 레시피와 미리 준비한 용량에 달려 있다. Rust를 사용한다는 점만으로 성능이 보장되는 것은 아니며, 성능은 GPU 작업과 메모리 이동, 스케줄링에 좌우된다. vLLM도 CUDA 그래프를 사용하므로 실제 모델과 작업을 기준으로 두 엔진을 비교해야 한다.
모델 준비와 서비스 안내에서 시작할 수 있다. 설정은 CLI 안내, 설계 배경은 핵심 설계 문서에서 확인할 수 있다. vLLM의 지원 범위는 공식 문서, CUDA 그래프 사용에 관한 내용은 설계 문서에 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요