TL;DR
- Offlineisbetter는 비싼 하드웨어나 클라우드 API에 의존하지 않고 CPU에서 실행하는 텍스트 인코딩 모델을 구축하는 프로젝트임.
- 모델의 초점은 감정 분석, 텍스트 태깅, 문서 검색 등이며 자동회귀 생성과 같은 디코딩 작업은 대상이 아님.
- 첫 모델 offline-sentiment-small은 감정 분석용 2억 3천만 파라미터 모델임.
- Ryzen 9950X3D CPU 단일 스레드에서 Stanford NLP의 SST-2 검증 세트를 이용해 벤치마크를 수행함.
- offline-sentiment-small은 검증 F1 0.9489, p95 지연 시간 80.32ms를 기록했으며, 매개변수 효율과 낮은 지연 시간의 모델을 누구나 쉽게 이용할 수 있게 하는 것이 프로젝트의 철학임.
Offlineisbetter 소개
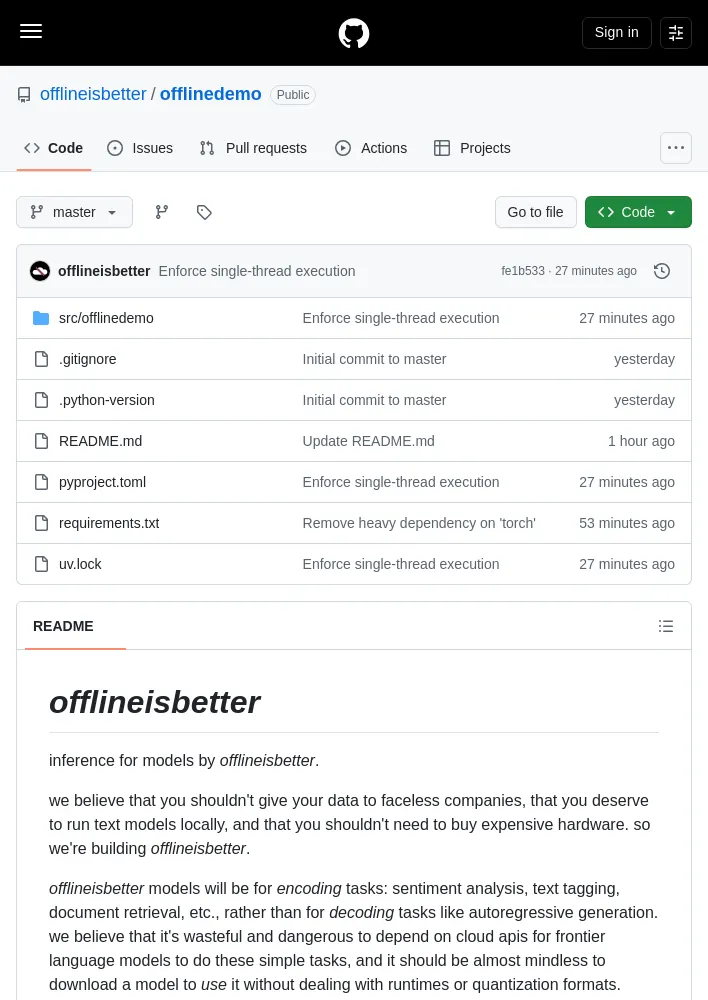
- Offlineisbetter는 모델 추론을 제공하며, 개인 데이터를 익명의 기업에 맡길 필요 없이 텍스트 모델을 로컬에서 실행할 수 있어야 하고 고가 하드웨어도 필요하지 않아야 한다는 관점에서 출발함.
- 모델은 자동회귀 생성과 같은 디코딩 작업보다 감정 분석, 텍스트 태깅, 문서 검색 등 인코딩 작업에 초점을 둠.
- 간단한 작업을 위해 최첨단 언어 모델용 클라우드 API에 의존하는 것은 낭비이자 위험이라는 입장임.
- 런타임이나 양자화 형식을 직접 다루지 않고도 모델을 내려받아 사용할 수 있는 방식을 지향함.
직접 사용하기
- 첫 모델은 offline-sentiment-small이라는 감정 분석용 소형 텍스트 모델이며, 파라미터 수는 2억 3천만 개임.
offlinedemo를 설치하고 저장소의 릴리스 페이지에서 모델 아카이브를 내려받아 압축을 해제한 뒤, 체크포인트가 들어 있는 디렉터리를 지정해 데모를 실행하는 절차임.
벤치마크
- 벤치마크는 Stanford NLP의
stanfordnlp/sst2검증 세트를 이용한 이진 감정 분류 기준이며, Ryzen 9950X3D CPU 단일 스레드에서 모두 수행함. - 모델별 파라미터 수, p95 지연 시간, 검증 F1은 다음과 같음.
- offline-sentiment-small: 2억 3천만 개, 80.32ms, 0.9489
- distilbert-base: 6천7백만 개, 66.15ms, 0.9321
- roberta-base: 1억 2천5백만 개, 469.65ms, 0.9396
- modernbert-base: 1억 4천9백만 개, 530.73ms, 0.9396
철학
- 핵심 철학은 매개변수 효율이 높고 지연 시간이 낮은 모델을 누구나 쉽게 사용할 수 있어야 한다는 것임.
- Hugging Face와
transformers.pipeline을 이용하면 Python 세 줄로 감정 분석을 실행할 수 있지만, Offlineisbetter는 매개변수 효율이 더 높고 이미 양자화되어 있으며 연산 그래프가 최적화된 모델을 지향함.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요