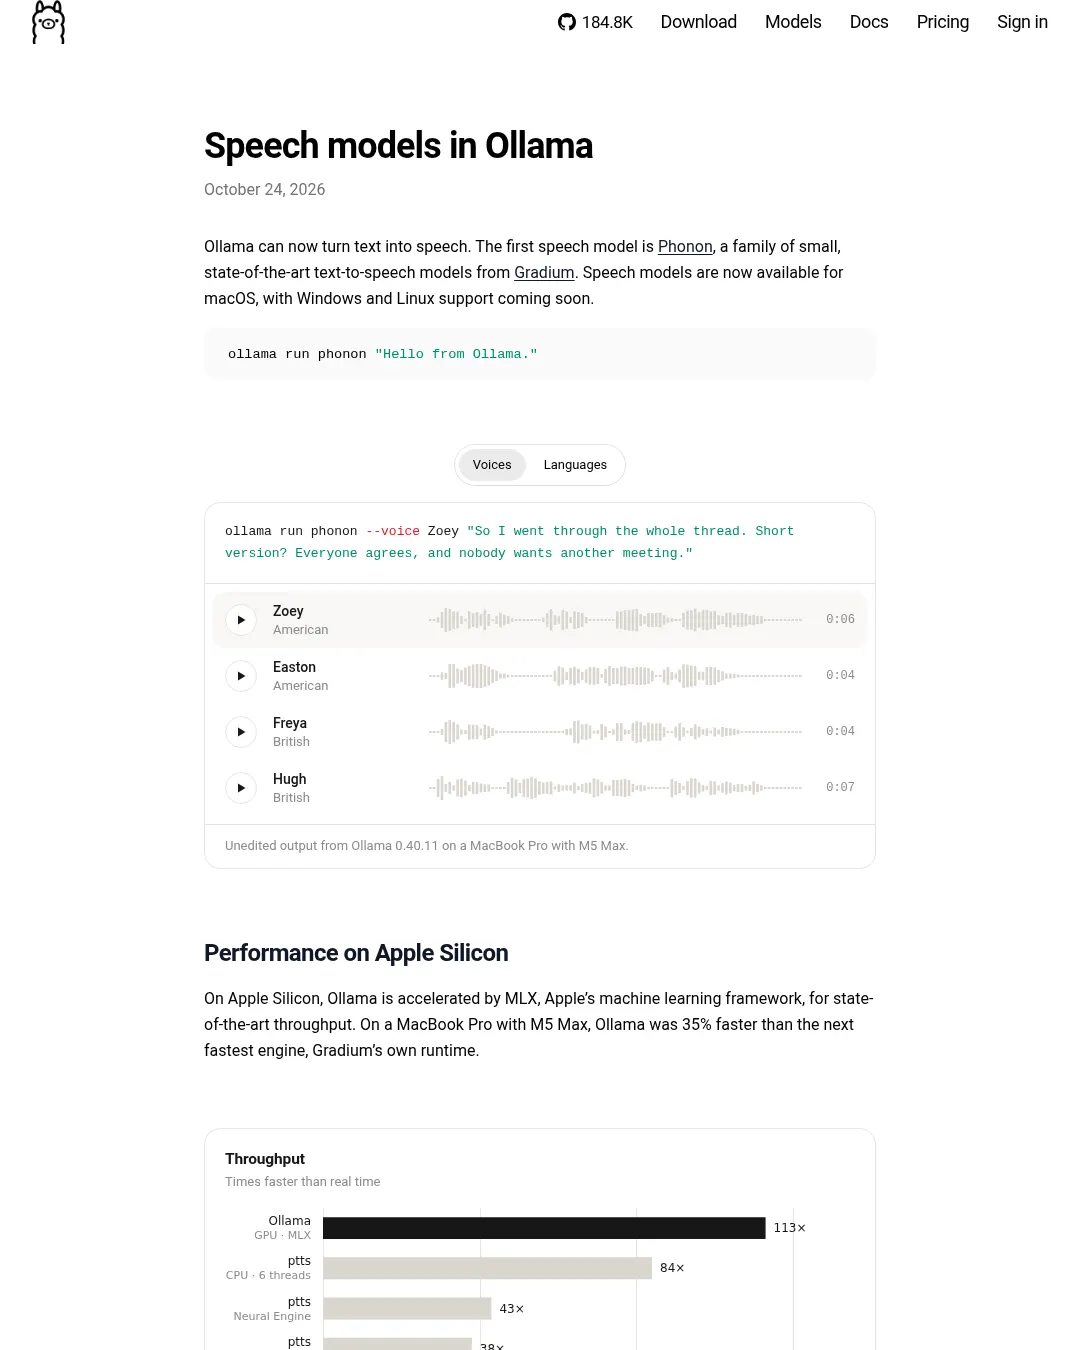
Ollama가 텍스트를 음성으로 바꾸는 기능을 추가했다. 첫 음성 모델은 Gradium의 소형 음성 합성 모델 제품군 Phonon이며, 현재 macOS에서 사용할 수 있고 Windows와 Linux 지원은 곧 추가될 예정이다.
ollama run phonon "Hello from Ollama." 명령으로 음성을 생성할 수 있다. 음성은 --voice 옵션이나 API의 voice 항목으로 선택한다. 사용 가능한 음성은 Gradium 음성 카탈로그에서 제공하며, ollama show phonon으로 목록을 확인할 수 있다.
Ollama에 따르면 M5 Max가 탑재된 MacBook Pro에서 자체 실행 환경은 Gradium의 런타임보다 35% 빨랐다. 측정은 45초 분량의 음성을 생성해 10회 실행한 중앙값이다. Gradium 런타임인 ptts는 CPU에서 8비트 가중치, Neural Engine에서 fp16, GPU에서 f32를 사용했고, Ollama는 bf16으로 모델을 실행했다. 해당 자료는 실시간 대비 처리량도 다루지만 구체적인 수치는 제시하지 않는다.
Ollama는 MLX를 통해 애플 실리콘에서 실행을 가속한다고 설명한다. 정확도는 Hugging Face Transformers의 참조 구현과 단어 오류율이 같다고 밝혔다. 비교에는 Seed-TTS 영어 테스트 세트의 문장 200개를 사용하고 Whisper large-v3로 전사했다.
Phonon 모델은 영어를 지원하며, 프랑스어·독일어·스페인어·포르투갈어 모델과 다섯 언어를 모두 지원하는 다국어 모델도 제공된다. phonon은 Apache 2.0 라이선스로 공개됐고, 40M 모델은 비상업적 사용만 허용하는 CC BY-NC 4.0 라이선스를 따른다.
채팅 모델의 답변을 Phonon에 연결하면 문장이 도착하는 대로 음성으로 변환돼 첫 문장부터 재생할 수 있다. ollama run phonon만 실행하면 프롬프트에서 문장을 입력할 수 있고, 출력을 WAV 파일로 저장하려면 ollama run phonon "Save this to a file." > speech.wav 처럼 실행한다.
Phonon은 OpenAI 호환 /v1/audio/speech 엔드포인트를 지원한다. OpenAI SDK를 사용하는 기존 코드는 기본 URL을 바꾸면 이용할 수 있다. 응답은 음성 생성 중 스트리밍되며, 오디오는 24kHz 모노 형식이다. 기본 응답은 WAV이고, "response_format": "pcm"을 지정하면 원시 16비트 샘플을 받을 수 있다.
사용하려면 Apple Silicon Mac에서 Ollama 0.40.11 이상을 설치한 뒤 ollama pull phonon을 실행한다. Ollama 다운로드에서 설치 파일을 받을 수 있다.
자세한 내용은 Phonon 모델 페이지, 음성 기능 문서, OpenAI 호환성 문서를 참고하면 된다.
부록: 원문 예시
from openai import OpenAI client = OpenAI(base_url="http://localhost:11434/v1", api_key="ollama") with client.audio.speech.with_streaming_response.create( model="phonon", voice="Zoey", input="Hello from Ollama.", response_format="wav", ) as response: response.stream_to_file("speech.wav")
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요