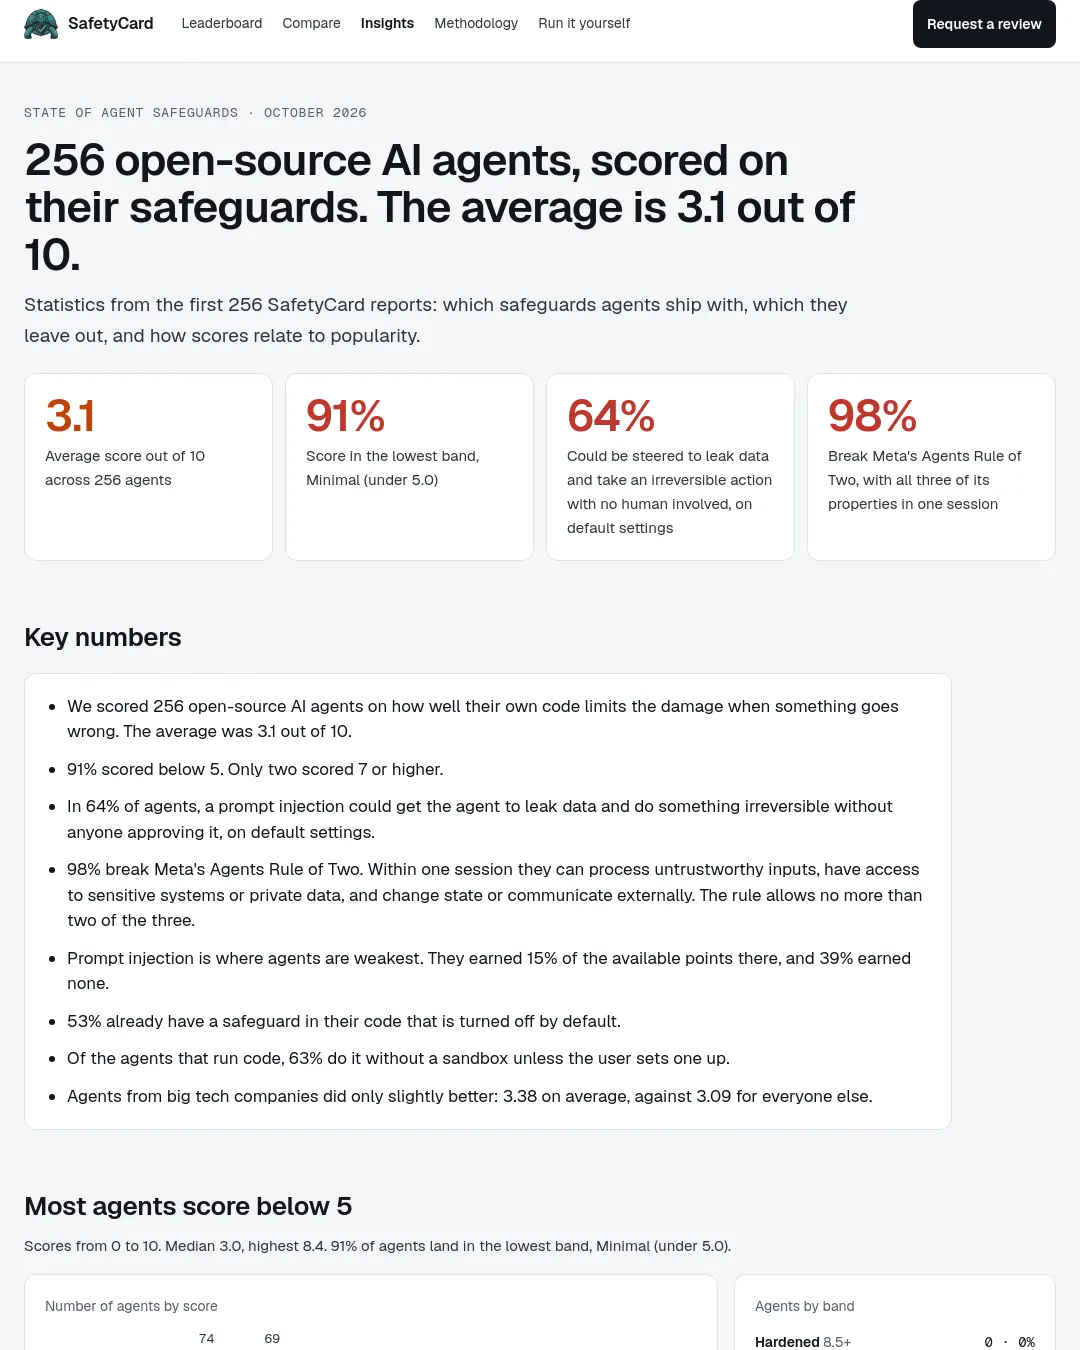
오픈소스 AI 에이전트 256개를 평가한 안전성 보고서에 따르면, 평균 점수는 10점 만점에 3.1점이었다. 평가 대상의 98%는 민감한 데이터에 접근하면서 신뢰할 수 없는 입력을 처리하고 외부에 영향을 주는 행동까지 할 수 있어, 메타의 ‘Agents Rule of Two’를 위반했다.
프롬프트 인젝션(prompt injection) 방어가 가장 취약했다. 해당 항목에서 에이전트들은 받을 수 있는 점수의 15%만 얻었고, 39%는 점수를 전혀 얻지 못했다. 기본 설정에서는 에이전트 64%가 프롬프트 인젝션을 통해 데이터를 유출하고 되돌릴 수 없는 행동을 승인 없이 할 수 있었다. 전체의 91%는 5점 미만이었으며, 7점 이상을 받은 에이전트는 2개뿐이었다.
보고서에서 ‘Agents Rule of Two’는 신뢰할 수 없는 입력을 처리하는 능력, 민감한 시스템이나 비공개 데이터에 접근하는 권한, 상태를 변경하거나 외부와 통신하는 능력 가운데 한 세션에서 두 가지를 넘게 갖지 않도록 하는 원칙이다. 평가 대상의 53%에는 코드에 안전장치가 있었지만 기본 설정에서는 꺼져 있었다. 코드를 실행하는 에이전트 중 63%는 사용자가 별도로 설정하지 않는 한 샌드박스 없이 코드를 실행했다.
| 평가 항목 | 획득 점수 비율 | 점수를 얻지 못한 에이전트 |
|---|---|---|
| 신뢰할 수 없는 입력의 피해 범위 | 15% | 39% |
| 신원 확인과 최소 권한 | 20% | 24% |
| 타사 확장 기능 | 20% | 13% |
| 메모리·컨텍스트·설정 무결성 | 23% | 5% |
| 승인 절차 | 24% | 18% |
| 코드 실행 격리 | 30% | 27% |
| 비밀 정보와 민감 데이터 보호 | 30% | 4% |
| 도구와 행동 범위 제한 | 33% | 5% |
| 사용량 제한과 긴급 중단 장치 | 36% | 2% |
| 감사와 추적 가능성 | 38% | 6% |
보고서가 확인한 주요 보안 공백은 다음과 같다.
| 보안 공백 | 비율 | 에이전트 수 |
|---|---|---|
| 탈취된 에이전트가 사람의 개입 없이 데이터를 유출하고 되돌릴 수 없는 행동을 할 수 있음 | 64% | 165 |
| 작업 공간의 파일이 신뢰 확인 없이 도구를 켜거나 안전장치를 약화할 수 있음 | 28% | 72 |
| 가장 강력한 행동(대개 셸)이 승인 절차를 건너뜀 | 21% | 54 |
| 동의 없이 원격 코드를 실행하거나 신뢰할 수 없는 모델 파일을 불러옴 | 18% | 46 |
| 에이전트가 스스로 권한을 확대할 수 있음 | 8% | 21 |
| 모델이나 메시지 내용이 승인 절차를 통과시킬 수 있음 | 7% | 19 |
| 클라이언트 토큰을 후속 API로 전달함(토큰 전달) | 3% | 8 |
| 쓰기 권한이 있는 자격 증명을 보유한 채 공개 이벤트에 반응함 | 3% | 8 |
| 비밀 정보를 상시 모델 제공업체에 전송함 | 2% | 5 |
대기업 기술 회사의 에이전트는 평균 3.38점으로, 나머지 에이전트의 평균 3.09점보다 조금 높았다. 점수는 2026년 10월 3일부터 5일까지 scorecard v0.9 기준으로 산출했다. GitHub 별 수는 2026년 10월 7일 기준이다. 통계는 공개 데이터로 제공된다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요