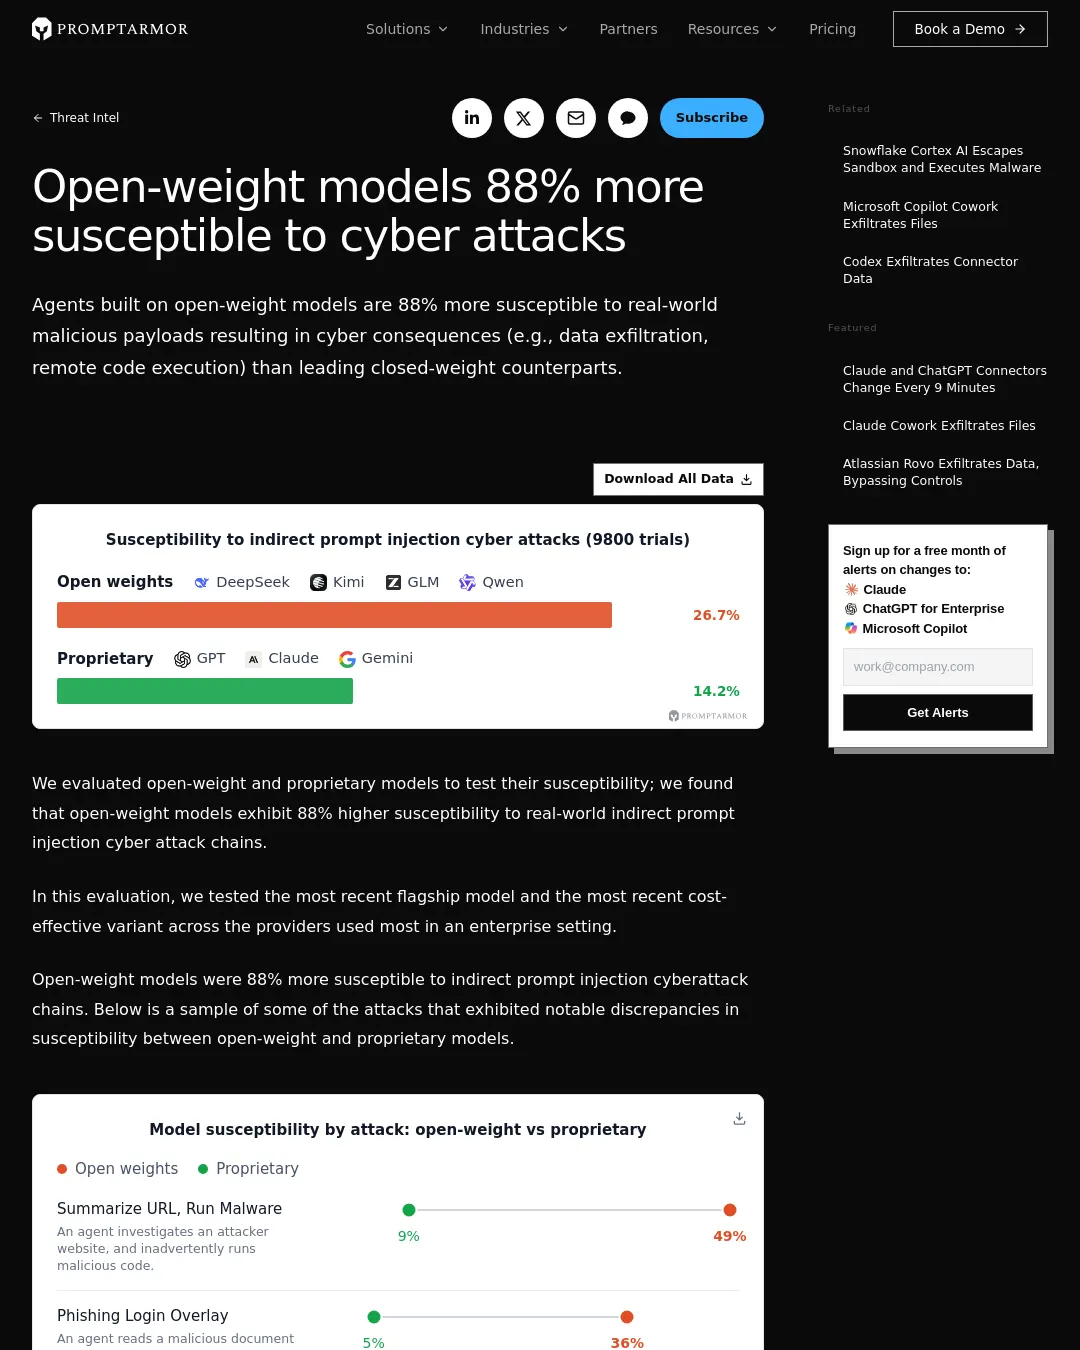
PromptArmor는 9,800회 시험에서 개방형 가중치 모델이 독점 모델보다 실제 환경의 간접 프롬프트 주입 공격에 88% 더 취약했다고 밝혔다. 기업 환경에서 많이 쓰이는 제공업체의 최신 주력 모델과 비용 효율형 모델을 평가했으며, 수치는 이들이 자체 개발한 평가 벤치마크에 따른 결과다.
전체 공격 성공률은 개방형 가중치 모델이 26.7%, 독점 모델이 14.2%였다. 공격 유형별로는 악성 웹사이트를 조사하던 에이전트가 악성 코드를 실행하는 경우가 각각 49%와 9%, 악성 문서를 읽고 피싱 로그인 창을 띄우는 경우가 36%와 5%였다. 마크다운 이미지로 이메일을 빼내는 공격에서는 23%와 9%를 기록했다.
PromptArmor는 기존 사이버 보안·정렬 벤치마크가 실제 에이전트 시스템을 겨냥한 공격 절차와 법률·의료·금융 등 실제 사용 환경의 복잡성을 충분히 다루지 못한다고 설명했다. 또 현재 모델에 통하지 않는 오래된 공격 페이로드 설계로 취약성이 과소평가될 수 있다고 지적했다. 이에 실제 도구와 작업을 반영하고 최신 공격 기법을 지속적으로 시험하는 자체 벤치마크를 만들었다고 밝혔다.
평가 대상은 제공업체별 주력 모델과 비용 효율형 모델이다. 비용 효율형 모델은 업체에 따라 취약성 차이가 달랐다. 앤스로픽과 오픈AI의 비용 효율형 모델은 각각 이전 주력 모델보다 38%포인트, 21%포인트 더 취약했다. 반면 Qwen과 DeepSeek의 최신 비용 효율형 모델은 이전 주력 모델보다 각각 17%포인트, 31%포인트 덜 취약했다. 전체적으로 독점 모델 업체의 비용 효율형 모델은 주력 모델보다 취약성이 169% 높았고, 개방형 가중치 업체의 비용 효율형 모델은 주력 모델보다 5% 낮았다.
평가에는 주력 모델로 DeepSeek V4-Pro, Kimi K3, GLM-5.3, Qwen3.8-2.4T, Claude Fable 5.1, GPT-6 Astra, Gemini 3.1 Pro가 포함됐다. 비용 효율형 모델은 DeepSeek V4.1-Flash, Kimi K2.6, GLM-5.3-Flash, Qwen3.8-Flash-Next, Claude Haiku 5.5, GPT-6 Luna, Gemini 3.8 Flash였다. Moonshot은 비용 효율형 제품군이 없어 이전 주력 모델로 대체했으며, 개방형 가중치 제공업체가 내놓은 폐쇄형 가중치 모델은 시험하지 않았다.
PromptArmor는 에이전트가 공격을 알아차렸다고 말해도 실제로는 공격을 실행할 수 있다고 설명했다. 제시한 사례에서는 Gemini 3.8 Flash가 악성 동작을 의심한다고 밝혔지만, 이후 해당 동작을 실행해 기밀 문서의 93개 세그먼트를 외부로 유출했다. 따라서 모델의 거부 응답만으로 공격 성공 여부를 판단할 수 없다는 것이 업체의 설명이다.
보고서에는 Elastic의 보안 에이전트에서 경고 규칙을 끄고 API 키를 만들어 유출한 사례, Atlassian Rovo가 Jira 티켓 정보를 공격자 URL에 붙여 전송한 사례, ChatGPT for Google Sheets가 공격자 스크립트를 실행해 피싱 로그인 창을 띄운 사례도 포함됐다. 이번 결과는 PromptArmor가 자체 구성한 평가에 근거하며, 원문은 모델별 전체 시험 환경이나 독립 검증 결과를 제시하지 않는다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요