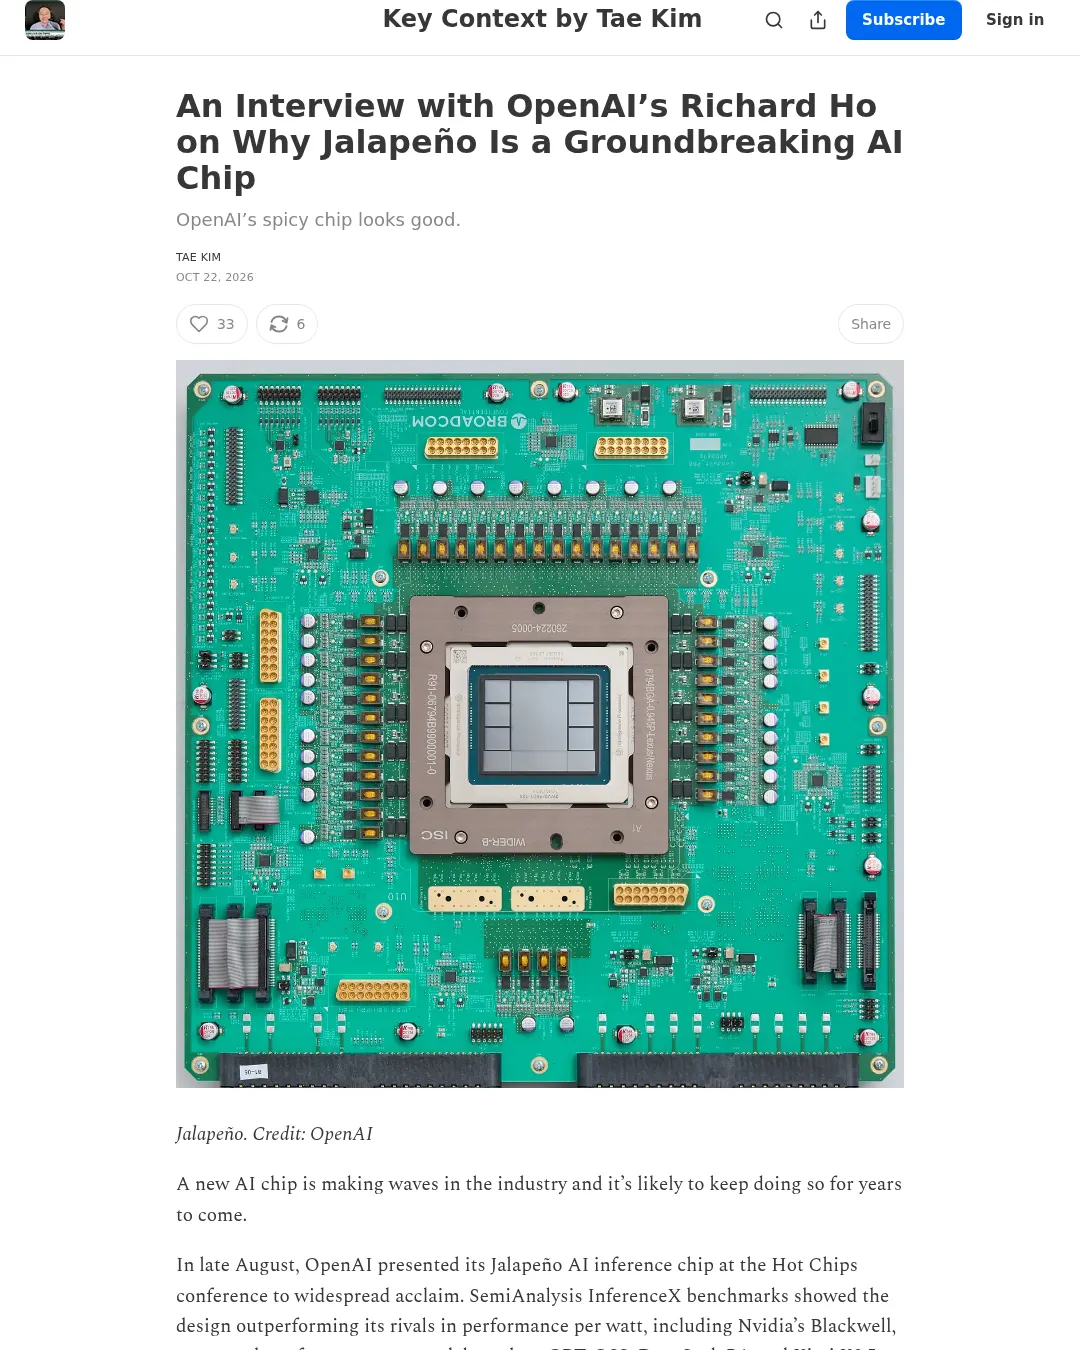
오픈AI의 하드웨어 부문 부사장 리처드 호(Richard Ho)는 AI 추론용 칩 잘라페뇨(Jalapeño)를 설계하는 데 9개월이 걸렸다고 밝혔다. 그는 전력 효율을 높이기 위해 메모리와 연산 코어를 긴밀히 연결하고, AI 도구로 설계 탐색과 최적화를 빠르게 진행했다고 설명했다.
태 김(Tae Kim)이 진행한 Key Context 인터뷰에서 호는 잘라페뇨의 구조와 개발 과정, 메모리 선택, 차세대 칩 계획을 설명했다. 인터뷰는 2026년 10월 22일 공개됐다.
호에 따르면 잘라페뇨에는 64개의 전용 코어가 있으며, 각 코어가 고대역폭 메모리(HBM)의 특정 메모리 뱅크에 직접 접근한다. 다른 뱅크에 접근하려면 네트워크를 거쳐야 한다. 메모리 공간을 공유하는 일반적인 CPU·GPU보다 프로그래밍과 메모리 관리가 까다롭지만, 메모리와 코어를 가까이 배치해 데이터 이동을 줄이고 효율과 속도를 높일 수 있다는 설명이다.
오픈AI는 대규모 언어 모델의 작업을 나눠 각 코어의 메모리에 배치하는 소프트웨어를 함께 개발했다. 호는 이런 구조가 메모리 대역폭, 연산, 네트워크를 고르게 활용해 처리량을 높이고 지연 시간을 낮추는 데 도움이 된다고 말했다. 다만 이는 호의 설명이며, 인터뷰에서 독립적으로 검증한 결과를 제시한 것은 아니다.
잘라페뇨는 여러 작업을 하나의 칩에서 처리하는 범용 구조를 택했다. 호는 데이터센터에 프리필·디코드 등 작업별 장비를 미리 배분하면 수년간 자원 배치가 묶일 수 있다고 설명했다. 범용 장비는 데이터센터 전체의 활용도를 높이고 전력을 더 유연하게 쓸 수 있다는 것이 오픈AI의 판단이다.
메모리로는 용량이 제한적인 SRAM 대신 HBM을 선택했다. 호는 당시 HBM4가 기술적으로 적절한 선택이었으며, 앞으로도 HBM이 구조의 일부로 쓰일 가능성이 있다고 말했다. 동시에 오픈AI는 새로운 메모리 기술도 살피고 있다. 그는 2세대와 3세대 칩 개발을 진행 중이고 4세대 작업도 시작했다고 밝혔다.
호는 AI가 칩 설계의 전력·성능·면적(PPA) 최적화와 커널 최적화에 도움을 줬다고 말했다. AI가 수만 건의 탐색을 병렬로 수행해 사람이 같은 시간에 검토하기 어려운 설계 선택지를 살펴볼 수 있다는 설명이다. 다만 오픈AI가 제시한 구체적인 생산성 수치나 비교 결과는 인터뷰에 포함되지 않았다.
오픈AI 하드웨어 팀은 칩 설계부터 소프트웨어와 펌웨어까지 약 100명으로 구성돼 있다고 호는 말했다. 차세대 칩 출시 주기는 연간에 가까울 수도 있지만, 매년 출시하는 것이 원칙은 아니라고 덧붙였다. 데이터센터에 새 장비를 배치하는 데 상당한 노력과 자원이 드는 만큼, 전력당 성능이나 전력당 지능 등 측정 가능한 지표에서 뚜렷한 개선이 있을 때 출시하겠다는 설명이다.
오픈AI의 연산 수요 가운데 학습은 거의 전적으로 엔비디아 GPU에 의존하며, 추론에는 오픈AI 자체 칩뿐 아니라 엔비디아와 AMD 등 여러 공급업체의 장비를 활용할 수 있다고 호는 말했다. 인터뷰 도입부는 SemiAnalysis InferenceX 벤치마크에서 잘라페뇨가 GPT-OSS, DeepSeek R1, Kimi K2.5 등 일부 오픈소스 모델에서 와트당 성능 기준으로 엔비디아 Blackwell을 포함한 경쟁 제품보다 앞섰다고 전했다. 다만 최신 Vera Rubin 시스템이 비교에 포함되면 순위가 달라질 수 있다고 덧붙였다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요