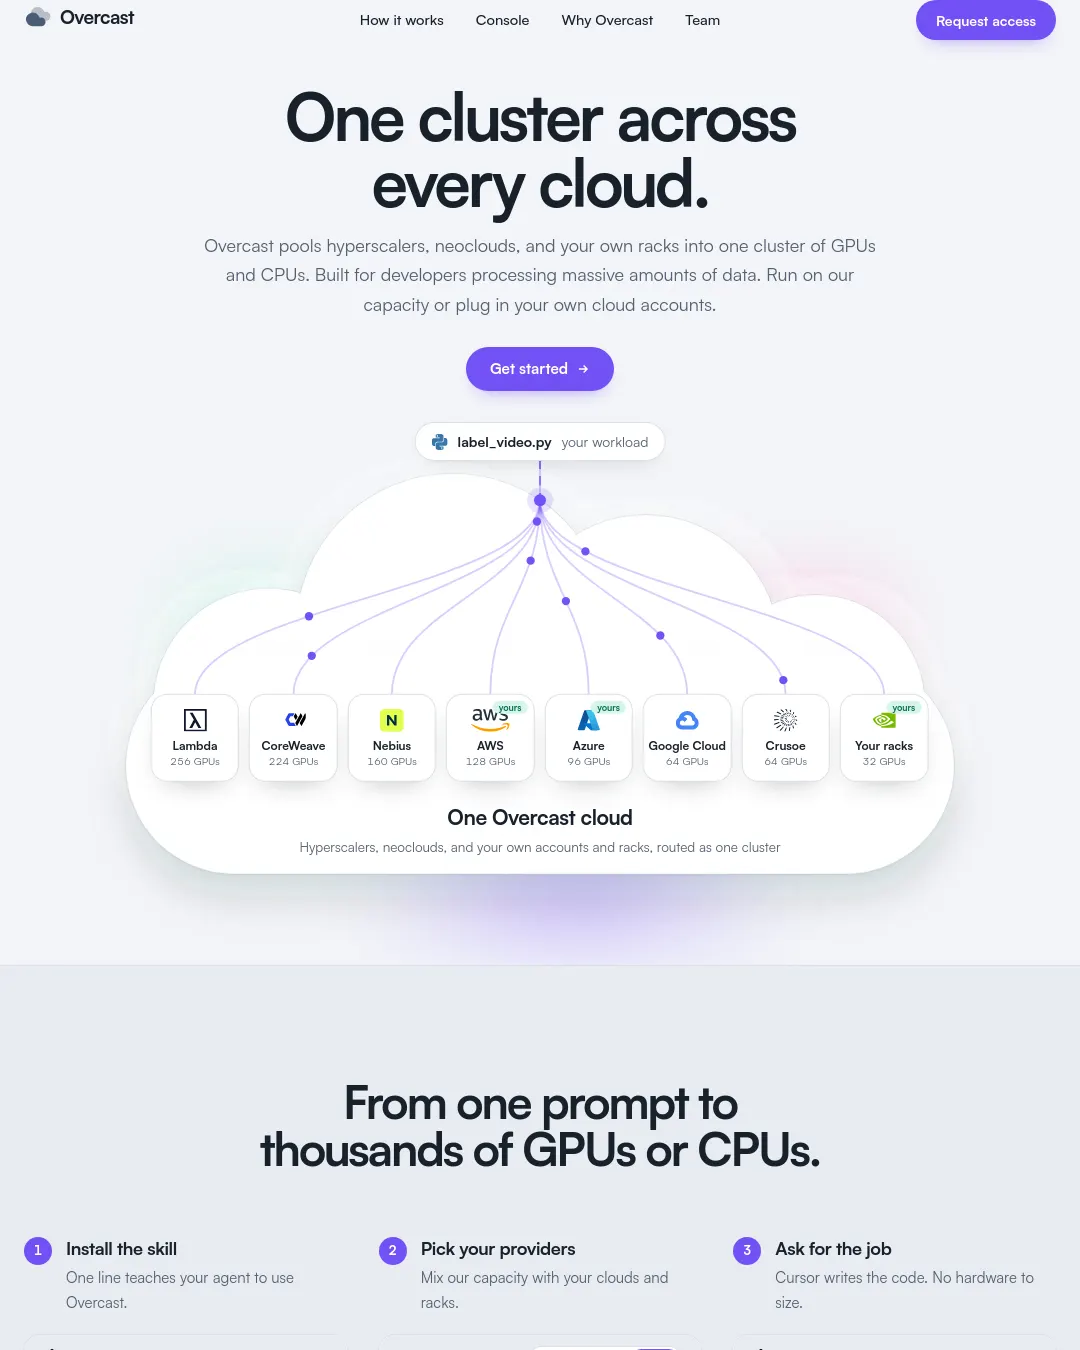
Overcast는 대형 클라우드, 네오클라우드, 자체 서버를 하나의 GPU·CPU 클러스터처럼 묶어 대규모 데이터 작업을 실행하는 서비스를 소개했다. 사용자는 Overcast가 제공하는 컴퓨팅 자원을 쓰거나 AWS·Azure·Google Cloud 계정과 자체 서버를 연결하고, 작업별로 비용·보안·속도 중 우선순위를 선택할 수 있다.
서비스 측 설명에 따르면 작업은 조건에 맞춰 여러 제공업체에 분산되며, 사용하지 않는 클러스터는 작업이 끝나면 0으로 축소된다. 지출 한도를 설정할 수 있고, 회수된 스폿 인스턴스의 장비는 몇 초 안에 대체되며 완료된 결과는 보존된다고 Overcast는 밝혔다.
Overcast가 공개한 비용·시간 비교는 실제 실행 측정값이 아니라 공개 요금표를 바탕으로 한 추정치다. 문서 4,000만 건 요약은 H100 GPU 기준 Overcast 미사용 시 6만8,800달러·3.3일, 사용 시 3만5,100달러·12시간으로 제시했다. 영상 36억 프레임 객체 탐지는 각각 1만1,500달러·13시간과 1만800달러·8시간, 외환 전략 5,000개 백테스트는 CPU 기준 2,200달러·12시간과 1,400달러·6시간으로 제시했다. 산정 방식
Overcast는 작업별로 가장 저렴하거나 보안성이 높거나 빠른 컴퓨팅 자원을 선택할 수 있다고 설명한다. 가격 예시로 H100 GPU 시간당 3.99달러부터라고 제시했으며, AWS에서는 6.88달러라고 비교했다. 민감한 데이터 작업은 사용자의 계정과 서버에 남길 수 있고, 지출 한도 안에서 운영할 수 있다는 설명도 덧붙였다. 동적 하드웨어 작동 방식
서비스는 에이전트에 getovercast.com/skill.md의 Overcast 스킬을 설치해 요청을 전달하는 사용 흐름도 소개했다. 예시에서는 Cursor가 코드를 작성하고, Overcast가 1,024개 GPU에 작업을 배포해 결과를 S3로 전송한다. 이는 소개 페이지의 시나리오이며, 실제 성능이나 비용 절감 결과를 측정한 사례로 제시된 것은 아니다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요