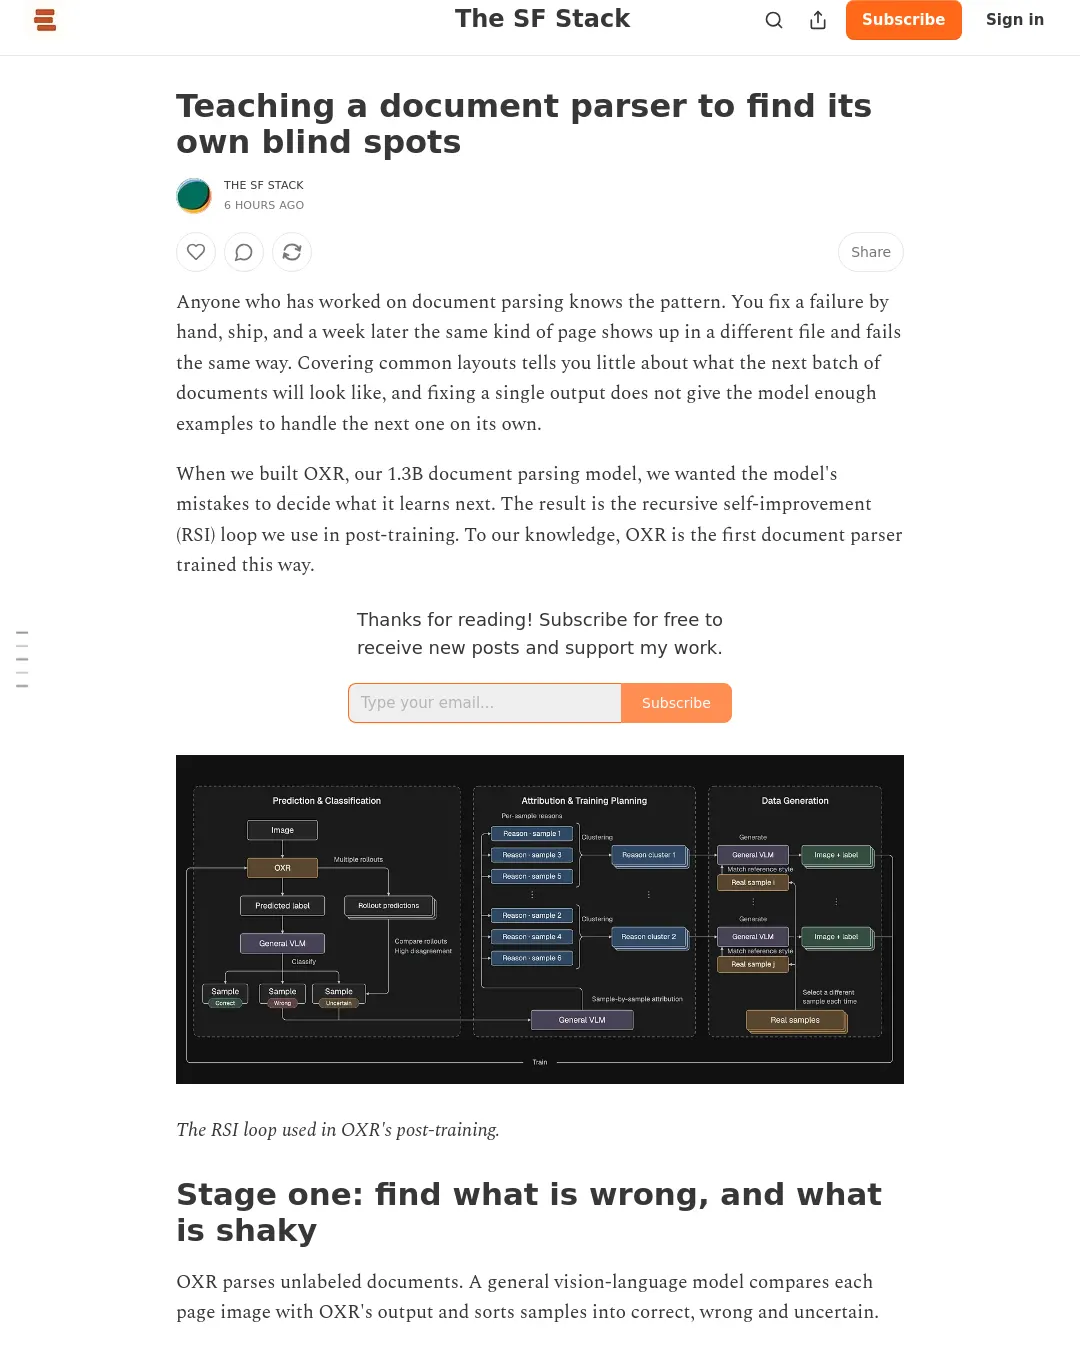
SoMark Team은 문서 파싱 모델 OXR의 후속 학습에 모델의 오류와 불안정한 예측을 활용하는 재귀적 자기 개선(RSI) 과정을 적용했다고 밝혔다. 팀은 자신들이 아는 한 OXR이 이 방식으로 학습한 첫 문서 파서라고 설명한다.
일반 비전-언어 모델이 문서 이미지와 OXR의 출력을 비교해 결과를 맞음·틀림·불확실로 분류한다. OXR이 같은 페이지를 여러 번 파싱해 결과가 서로 다르면 불확실 신호로 잡는다. 예측이 다르다는 사실만으로 답이 틀렸다고 단정하지는 않는다. 내용은 유지하면서 크기 조정, 흐림, 압축을 적용했을 때 불일치가 커지는지도 신호로 활용한다.
비전-언어 모델은 오류가 표시된 샘플의 원인을 가설로 제안하고, 별도의 클러스터링 모델이 비슷한 원인을 묶는다. 이후 비전-언어 모델이 실제 문서의 레이아웃과 시각적 스타일을 참고해 새 문서를 그리는 코드를 작성한다. 생성된 이미지와 라벨은 규칙 기반 검사를 통과해야 학습에 들어가며, 새 데이터에 사람이 직접 라벨을 붙이지는 않는다.
학습이 끝나면 갱신된 모델로 실제 문서를 다시 파싱해 과정을 반복한다. SoMark Team은 평가기가 이전에 틀렸다고 판단한 샘플 가운데 새 모델이 맞혔다고 판단하는 수를 추적한다고 밝혔다. 데이터 준비는 자동화하지만, 학습을 시작할 시점과 유지할 모델, 배포 시점은 사람이 결정한다.
팀은 OXR이 공개된 점수 기준으로 olmOCR-Bench, OmniDocBench, DocParsingBench에서 1위에 올랐으며, 단일 RTX PRO 6000에서 진행한 종단 간 속도 시험에서는 21개 모델 가운데 가장 빨랐다고 주장한다. 이 결과는 팀이 밝힌 비교 결과다. OXR의 코드와 가중치는 공개돼 있으며, 상업적 이용은 총 펀딩액 또는 연간 매출이 200만 달러 미만인 경우 무료다. 라이선스는 Apache 2.0을 기반으로 한 맞춤형 라이선스다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요