이 인터랙티브 기사에서는 사각형 찾기 게임을 통해 머신러닝의 학습과 일반화, 그리고 실제 적용에서 생길 수 있는 취약점을 살펴본다. 데스크톱이나 큰 화면에서 보는 것이 좋으며, 일부 인터랙티브 요소는 모바일에서 완전히 이용할 수 없을 수 있다.
사각형 찾기 게임
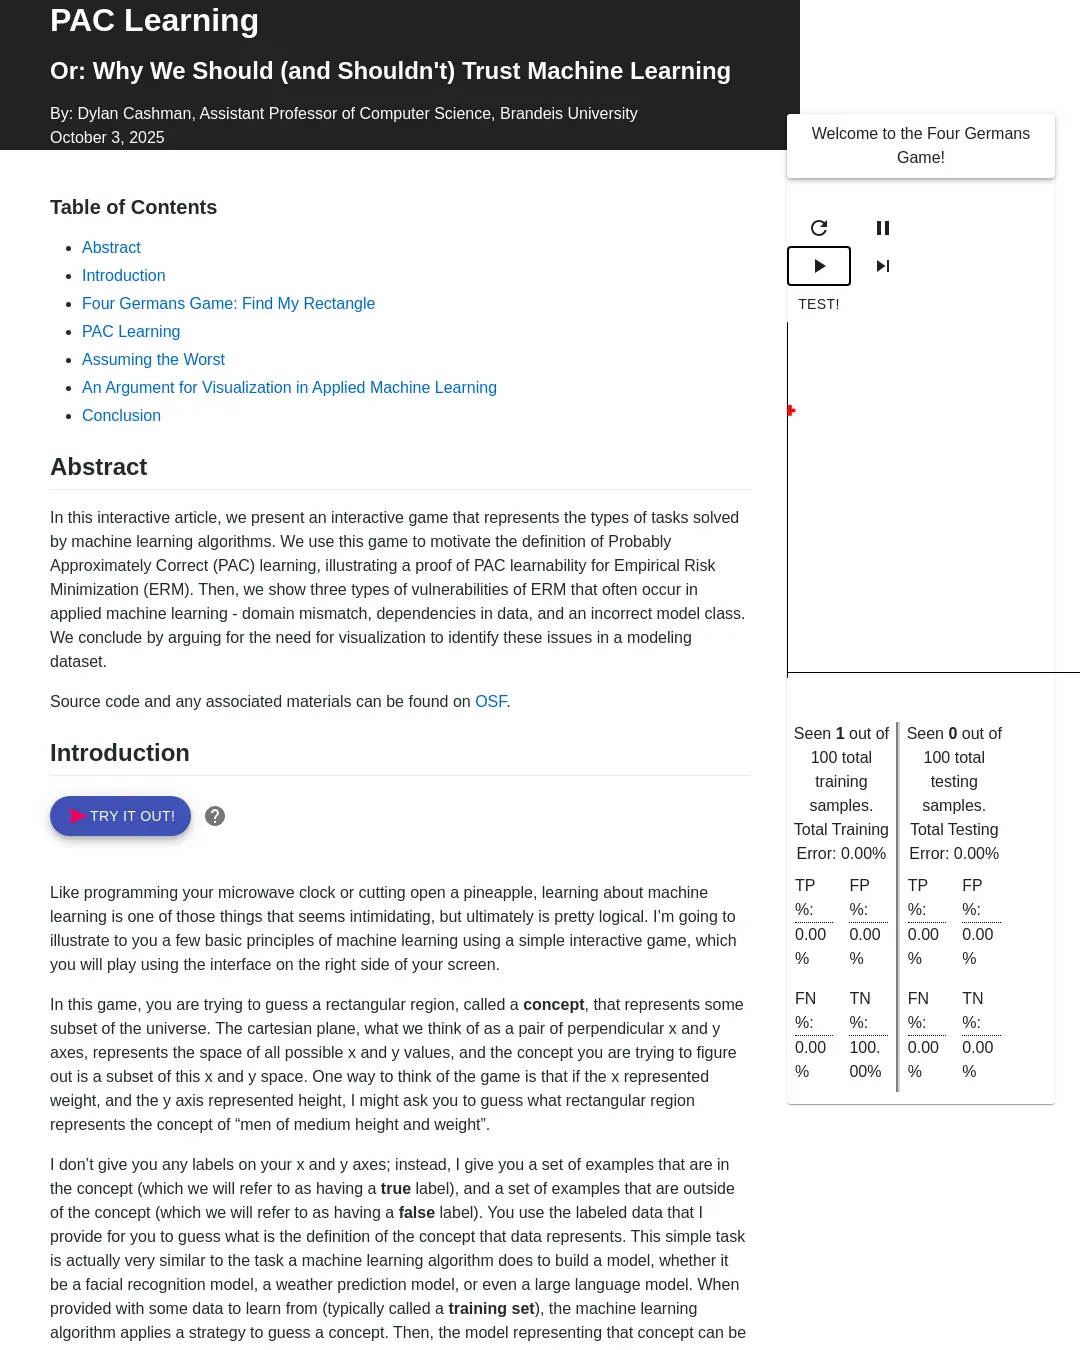
게임의 목표는 가능한 x·y 값의 공간에서 어떤 개념을 나타내는 사각형을 맞히는 것이다. 예를 들어 x축이 체중, y축이 키라면 ‘키와 체중이 중간 정도인 남성’에 해당하는 영역을 추측할 수 있다. 축에 붙은 설명 대신, 정답 영역 안팎에 있는 예시와 각 예시의 참·거짓 라벨이 주어진다. 플레이어는 이 학습 데이터로 개념을 추측한다.
오른쪽 인터페이스에서 평면을 클릭해 사각형을 끌어 그린 다음 TEST!를 누르면, 학습에 사용하지 않은 데이터로 추측을 평가한다. 새로 그은 사각형이 새 점을 올바르게 분류한 참 양성(TP)·참 음성(TN) 비율과 잘못 분류한 거짓 양성(FP)·거짓 음성(FN) 비율이 표시된다. 지표 위에 마우스를 올리면 설명을 볼 수 있다.
새 게임을 시작할 때마다 브라우저가 추측할 새로운 무작위 사각형을 정한다. 학습 데이터는 한꺼번에 나타나지 않고 조금씩 추가되며, 재생을 멈추거나 다시 시작하고 속도를 두 배로 바꿀 수 있다. 점이 10~20개만 주어진 시점에 게임을 멈추고 영역을 추측해 볼 수도 있다. 초반에 어떤 점을 받았는지에 따라 추측이 쉬울 수도, 거의 불가능할 수도 있다. 적은 데이터로는 지금까지 본 학습 점과 일치하는 개념을 고를 수 있지만, 시험 데이터에서는 오류가 클 수 있다.
이 게임은 머신러닝 알고리즘이 제한된 학습 데이터로 실제 현상을 근사하는 모델을 만든 뒤, 보지 못한 데이터에서도 잘 작동하기를 기대하는 과정을 단순화해 보여준다. 학습 데이터에서 오류가 적더라도 시험 데이터에서 오류가 적다는 보장은 없다. 학습 데이터가 실제 현상을 대표하지 않거나, 데이터가 부족하거나 잡음이 있거나, 실제 정답은 원인데 사각형을 가정하는 것처럼 잘못된 모델을 사용하면 문제가 생길 수 있다.
게임을 소개한 글은 이 설정을 통해 학습 가능성을 설명한 1989년 논문을 언급한다. 터프츠 대학교 명예교수 안셀름 블루머(Anselm Blumer)가 처음 이 게임을 알려줬으며, 블루머와 에렌포이히트, 하우슬러, 워머스가 함께 쓴 논문은 ‘Four Germans Paper’로 알려졌다. 이 게임은 기계학습 이론의 한 틀인 확률적 근사적 정답 학습(PAC learning)을 설명하는 데 쓰인다. PAC 학습은 어떤 조건에서 알고리즘이 실제 환경에서도 학습 데이터에서와 비슷한 성능을 낼 가능성이 높은지 살펴본다.
기계학습은 스팸 필터부터 자율주행차, 병원의 환자 분류 소프트웨어, 범죄 예측 소프트웨어, 얼굴 인식, 이미지·장면 분류, 대규모 언어 모델의 텍스트 생성까지 다양한 용도로 쓰인다. 예컨대 스팸 발송자의 전략이 바뀌면 과거 스팸으로 학습한 데이터가 새로운 스팸을 대표하지 못해 필터가 놓칠 수 있다. 학습 때와 다른 데이터를 배포 환경에서 만나면 관찰된 것보다 성능이 나빠질 수 있으며, 오류가 사람에게 큰 영향을 미치는 용도에서는 이런 위험을 이해하고 배포 여부를 판단해야 한다. 글은 PAC 학습이 모델을 만들기 전부터 이런 위험을 예상하는 데 도움을 줄 수 있다고 설명한다.
학습 전략과 PAC 학습
학습 데이터가 전혀 없는 상태에서는 어떤 알고리즘도 무작위로 문제를 푸는 것보다 나을 수 없다는 ‘최적화의 공짜 점심 없음(No Free Lunch)’ 정리가 소개된다. 기계학습 이론 연구자 데이비드 월퍼트(David Wolpert)는 지도학습이나 탐색 문제에 균일한 분포를 가정하면 모든 알고리즘의 성능이 같다고 설명했다. 정보가 없으면 오류가 10%일지 90%일지, 사각형을 완벽하게 맞혀 오류가 0%일지 알 수 없다.
반대로 정답 영역 안팎의 점을 각각 5개씩, 총 10개 받았다고 해도 정답과 얼마나 가까운지 보장할 수 있는지 생각해 볼 수 있다. 양성 예시를 딱 맞게 둘러쌀지, 아직 보지 못한 데이터를 고려해 여백을 둘지에 따라 전략이 달라진다. 사람은 예시를 보며 전략을 바꿀 수 있지만, 머신러닝 알고리즘은 명확히 정의되어야 하므로 대체로 단순한 규칙을 따른다. 글은 다음 세 가지 전략을 제시한다.
- 가장 좁은 맞춤(Tightest Fit)은 지금까지 본 양성 예시를 모두 포함하는 가장 작은 사각형을 고른다. 관측된 표본과 일치하는 영역 중 가장 작으며 위험 최소화 원리와 관련 있다. 이 방식은 정답 영역을 과소 추정한다.
- 가장 넓은 맞춤(Loosest Fit)은 양성 예시를 모두 포함하면서 음성 예시는 사각형 안에 들어오지 않도록 가장 넓은 사각형을 고른다. 정답 영역을 과대 추정한다.
- 최대 여백(Maximum Margin)은 양성·음성 예시를 모두 포함하면서 두 종류의 예시에서 가능한 한 멀리 떨어진 사각형을 고른다.
PAC 학습은 충분한 라벨 데이터가 주어졌을 때, 표본을 지나치게 불운하게 뽑지 않는다는 조건 아래 모델의 오류가 어떤 값 엡실론(ε)보다 작다는 경계를 증명할 수 있는 알고리즘이 존재하는지를 다룬다. 이때 그 경계가 성립할 확률은 최소 1−δ다. 글은 케언스와 바지라니의 책 1장을 바탕으로 PAC 학습을 설명하고, 게임이 PAC 학습 가능하다는 증명을 다룬다고 밝힌다. 정의와 증명에 필요한 가정은 기계학습 알고리즘의 잠재적 취약점을 이해하는 데도 연결된다.
기계학습 모델은 학습 데이터 일부에서 보인 성능이 실제 환경에서도 유지될 것이라고 확실히 알 수 없다. 따라서 실제 환경의 데이터가 학습 데이터와 크게 다르면 성능이 나빠질 수 있으며, 데이터셋을 시각화하면 적용된 기계학습에서 생기는 문제를 찾아내는 데 도움이 된다는 것이 글의 결론이다.
게임과 관련 자료의 소스 코드는 OSF에서 확인할 수 있다. 참고 자료로 블루머 외의 논문, PAC 학습 논문, 케언스와 바지라니의 책을 제시한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요