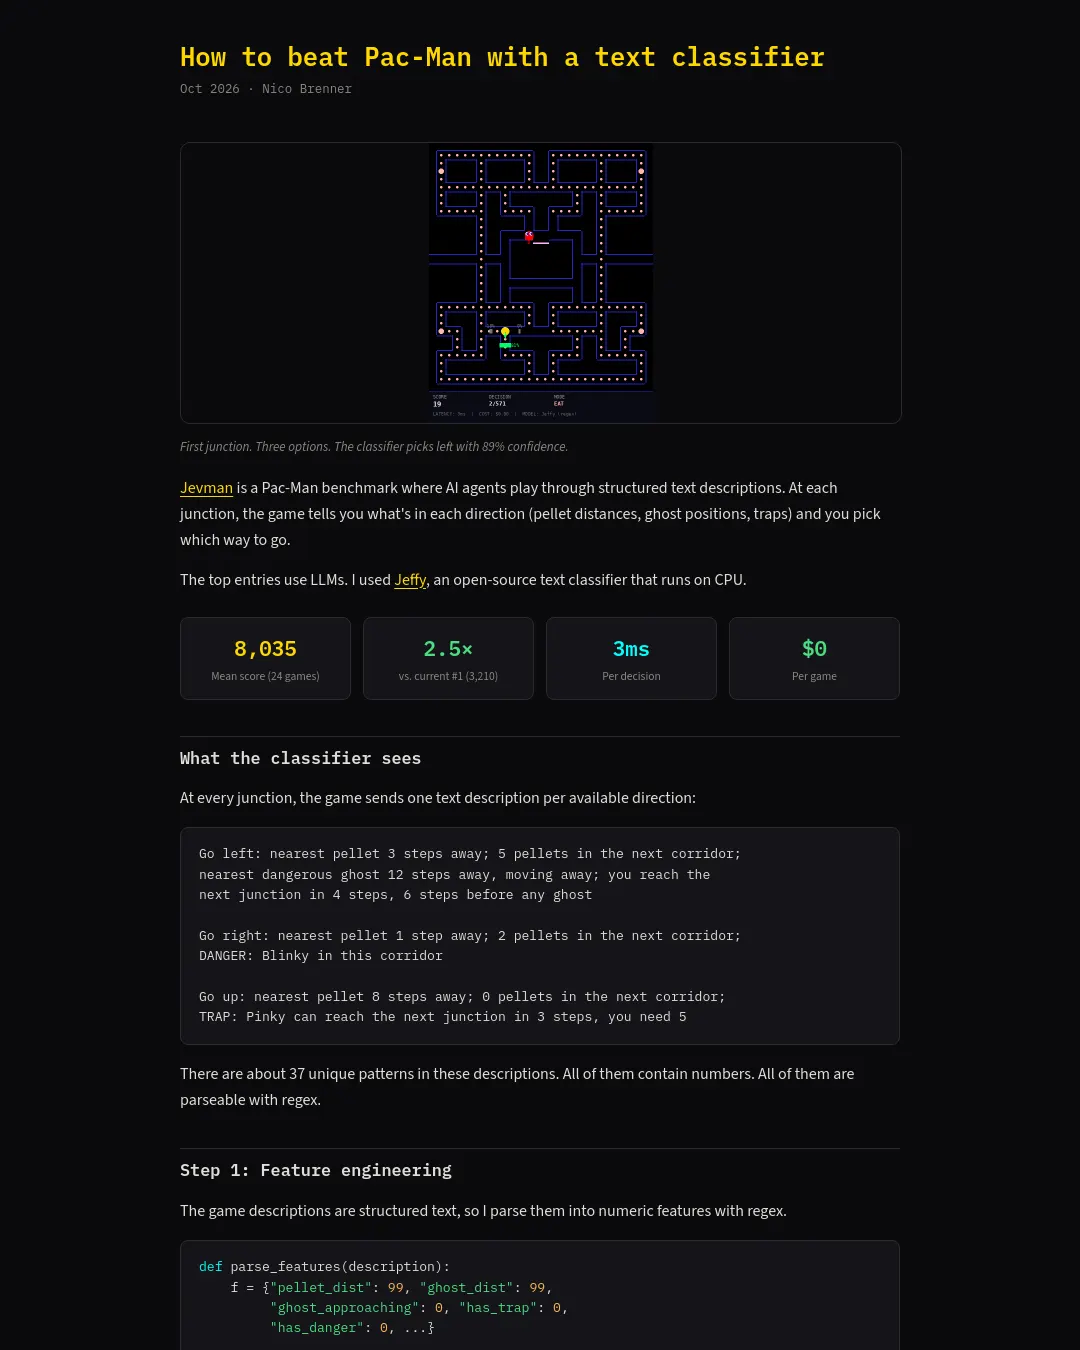
24번의 게임에서 평균 8,035점을 얻었다. 현재 1위의 3,210점보다 2.5배 높은 점수다. 매번 방향을 고르는 데 걸린 시간은 3밀리초였고, 게임당 비용은 0달러였다.
니코 브레너(Nico Brenner)는 구조화된 텍스트 설명을 읽고 팩맨의 이동 방향을 고르는 방법을 소개했다. 오픈소스 텍스트 분류기 Jeffy를 사용해 CPU에서 실행했으며, 팩맨 벤치마크 Jevman에 제출한 결과다. 텍스트에 적힌 숫자와 위험 표시를 규칙으로 추출할 수 있는 게임이나 작업을 다루는 사람이라면 접근 방식을 참고할 수 있다.
Jevman은 어떤 게임인가?
Jevman은 AI 에이전트가 구조화된 텍스트 설명을 바탕으로 팩맨을 플레이하는 벤치마크다. 갈림길마다 각 방향의 먹이까지 거리, 유령 위치, 함정 같은 정보를 알려 주고, 에이전트가 갈 방향을 고른다. 게임 설명은 갈림길마다 가능한 방향 하나당 다음과 같은 문장을 보낸다.
Go left: nearest pellet 3 steps away; 5 pellets in the next corridor;
nearest dangerous ghost 12 steps away, moving away; you reach the
next junction in 4 steps, 6 steps before any ghost

Go right: nearest pellet 1 step away; 2 pellets in the next corridor;
DANGER: Blinky in this corridor

Go up: nearest pellet 8 steps away; 0 pellets in the next corridor;
TRAP: Pinky can reach the next junction in 3 steps, you need 5
브레너가 살펴본 설명에는 약 37개의 고유 패턴이 있었다. 모든 설명에 숫자가 들어 있고 정규식으로 파싱할 수 있다는 점에 착안했다. 정규식(문자열의 패턴을 찾아내는 규칙)으로 텍스트를 숫자 특성으로 바꾸고, 이를 분류기에 입력했다.
어떻게 학습시켰나?
먼저 손으로 가중치를 정한 점수 함수를 만들고, 이를 이용해 수백 판을 플레이했다. 각 갈림길에서 추출한 특성이 입력값이 되고, 점수 함수가 선택한 방향이 정답이 됐다. 수백 판에서 수천 개의 갈림길 사례를 모아 학습 데이터로 삼았다.
def parse_features(description):
 f = {"pellet_dist": 99, "ghost_dist": 99,
 "ghost_approaching": 0, "has_trap": 0,
 "has_danger": 0, ...}

 for part in description.split(";"):
 m = re.search(r"nearest pellet (\d+) steps? away", part)
 if m: f["pellet_dist"] = int(m.group(1))

 m = re.search(r"nearest dangerous ghost (\d+) steps? away", part)
 if m: f["ghost_dist"] = int(m.group(1))

 if "TRAP:" in part: f["has_trap"] = 1
 if "DANGER:" in part: f["has_danger"] = 1
 return f
점수 함수는 위험 표시와 함정에 감점을 주고, 유령과의 거리 및 먹이까지의 거리를 점수에 반영했다. 겁먹은 유령이 있으면 가까울수록 추가 점수를 줬다.
def score_direction(description):
 f = parse_features(description)
 score = 0.0


 if f["has_danger"]: score -= 100
 if f["has_trap"]: score -= 80
 if f["ghost_dist"] < 99:
 threat = max(0, 20 - f["ghost_dist"]) * 3
 if f["ghost_approaching"]: threat *= 2.5
 score -= threat


 score += max(0, 12 - f["pellet_dist"])


 if f["has_frightened_ghost"]:
 score += 40 + max(0, 15 - f["frightened_ghost_dist"]) * 3

 return score
다음으로 Jeffy의 특성 기반 분류기를 학습하고 평가했다. 특성이 이미 숫자로 변환돼 있어 임베딩은 필요하지 않다.
jeffy train --task pacman --features pellet_dist,ghost_dist,ghost_approaching,has_trap,has_danger,... \
 --data training_games.jsonl

jeffy eval --task pacman --data test_games.jsonl
학습에는 1초 미만이 걸렸다. 학습된 모델은 숫자 특성 위에 얹은 로지스틱 회귀(logistic regression) 분류기다. 게임 중에는 Jeffy의 predict_features() 엔드포인트가 특성 벡터를 받아 3밀리초 안에 방향을 돌려준다.
유령을 쫓을 때는 어떻게 달라지나?
파워 펠릿을 먹으면 겁먹은 유령은 차례로 200점, 400점, 800점, 1,600점의 가치가 있다. 이때 점수 함수는 먹이 수집 중심에서 유령 사냥 중심으로 바뀐다. 겁먹은 유령이 있으면 기본 40점을 더하고, 가까운 유령에는 거리에 따른 추가 점수를 준다. 평균적으로 한 게임에서 유령 9.8마리를 잡았다.
직접 실행하려면 무엇이 필요한가?
Jeffy를 설치하고 Jevman 벤치마크 저장소를 받은 다음, 로컬 엔드포인트를 실행해 제출한다.
pip install jeffy

python3 jevman-endpoint.py 8787

git clone https://github.com/opper-ai/jevman-benchmark
cd jevman-benchmark && npm install
npm run submissions -- --model jeffy --endpoint http://localhost:8787
각 게임은 2~5초가 걸린다. 24게임 전체 실행에는 약 90초가 든다. 엔드포인트는 갈림길 설명을 특성으로 파싱한 뒤 Jeffy 분류기에 넣고, 선택한 방향을 반환한다.
브레너는 이 방식이 통하는 이유를 설명이 구조화돼 있기 때문이라고 본다. 먹이와 유령까지의 거리, 함정 여부가 이미 숫자와 표시로 주어지므로 텍스트를 추론하기보다 필요한 정보를 파싱하면 된다는 설명이다. 브레너는 언어 모델도 같은 숫자와 표시를 추출하지만, 70억 개 매개변수를 쓰고 결정에 650밀리초가 걸리는 반면 정규식은 3밀리초가 걸린다고 비교했다. 또 분류기가 손으로 정한 점수 함수와 같은 결정 경계를 사례에서 학습해, 보지 못한 갈림길 구성에도 일반화한다고 주장했다.
브레너가 소개한 결과는 평균 점수 8,035점과 의사결정당 3밀리초다. Jevman 저장소에는 변경 요청이 열려 있으며, 결과는 지속적 통합 절차에서 검증될 예정이다. 원문은 하드웨어나 언어 모델 비교의 측정 조건, 그리고 지속적 통합 검증 결과를 밝히지 않는다.
참고: Jevman 벤치마크, Jeffy, 변경 요청
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요