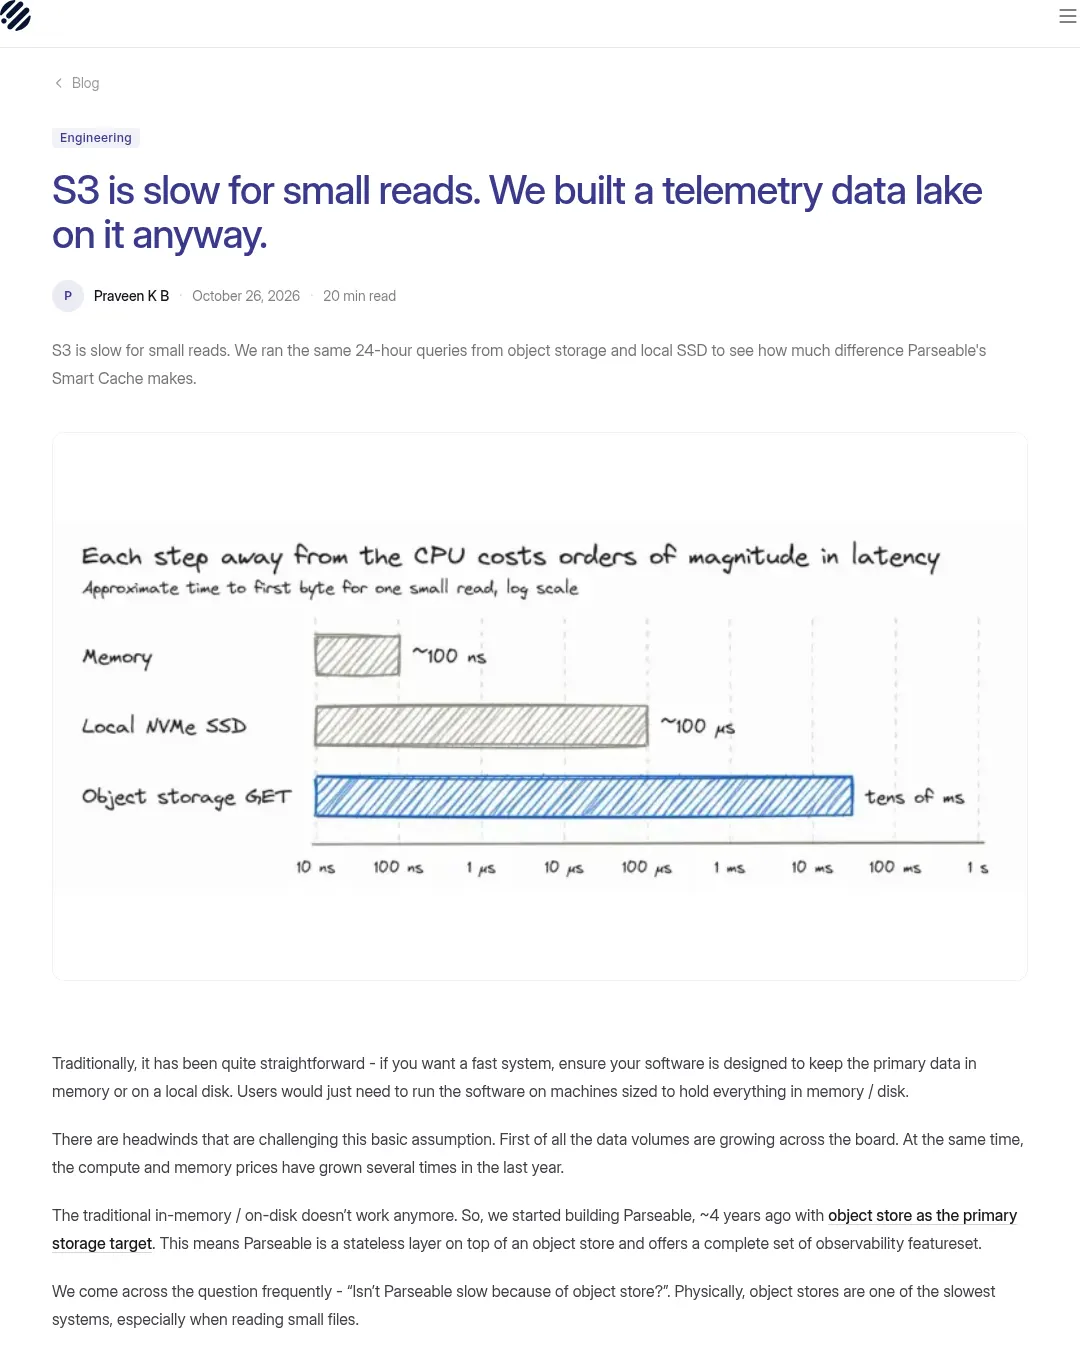
Parseable은 최근 로그를 로컬 SSD에 캐시해 오브젝트 스토리지의 조회 지연을 줄이는 방식을 소개했다. Parseable이 Google Cloud Storage에 구축한 3노드 클러스터에서 24시간치 로그를 조회한 결과, 전체 행 수 세기 쿼리는 캐시가 없는 상태에서 14.0초, 최근 파일을 SSD에 둔 상태에서 3.8초가 걸렸다. 다만 이 테스트는 S3가 아니라 Google Cloud Storage를 사용했다.
Parseable은 오브젝트 스토리지를 데이터의 내구성 있는 저장소로 두고, 쿼리 노드의 SSD에는 최근 데이터의 복사본을 캐시한다. 캐시를 잃어도 원본 데이터는 유지되지만, 캐시가 다시 채워질 때까지 조회가 느려진다는 설계다. 새 데이터는 오브젝트 스토리지에 커밋된 뒤 쿼리 노드에 동기화돼야 핫 티어에 들어간다.
실험은 Parseable v3.2.5, 16 vCPU와 메모리 64 GiB를 갖춘 쿼리 노드에서 진행했다. 데이터셋은 logs-dataset이며, 최근 24시간 동안 약 173억 건의 이벤트와 약 900GB의 Parquet 데이터가 포함됐다. 같은 쿼리를 캐시가 없는 상태, Parquet 메타데이터만 메모리에 둔 상태, 최근 24시간 파일을 SSD에 둔 상태에서 각각 세 번 실행해 중앙값을 비교했다.
| 쿼리 | 캐시 없음 | 메타데이터 캐시 | SSD 핫 티어 |
|---|---|---|---|
| 전체 행 수 세기 | 14.0초 | 10.5초 (25% 빠름) | 3.8초 (73% 빠름) |
p_timestamp가 설정된 행 수 세기 | 12.5초 | 11.7초 (6% 빠름) | 5.1초 (59% 빠름) |
| 오류를 메시지별로 묶기 | 48.4초 | 49.3초 (2% 느림) | 35.9초 (26% 빠름) |
메타데이터 캐시만 적용한 결과는 실행 간 편차와 겹쳤다. 반면 SSD 핫 티어는 데이터 읽기에 드는 대기를 줄였다. 다만 텍스트 열을 필터링하고 그룹화하는 무거운 쿼리는 SSD에서도 35.9초가 걸렸다. 데이터 읽기가 빨라져도 디코딩·필터링·그룹화에 드는 연산 시간은 남기 때문이다.
Parseable의 Smart Cache는 쿼리 노드의 로컬 디렉터리를 설정하고 데이터셋별 용량을 지정해 활성화한다. 스케줄러가 매분 오브젝트 스토리지를 확인해 최신 파일부터 내려받고, 용량 한도나 디스크 사용 기준을 넘으면 오래된 파일을 제거한다. 쿼리는 로컬에 있는 파일을 SSD에서 읽고 나머지는 버킷에서 가져온다. 매니페스트는 캐시 상태와 관계없이 쿼리마다 버킷에서 읽는다.
최근 24시간치 데이터를 저장하려면 이 실험의 데이터셋 기준 약 900GB의 SSD가 필요했다. Parseable은 보존 기간 전체가 아니라 대시보드와 경보 등 팀이 자주 조회하는 시간 범위에 맞춰 캐시 크기를 정하라고 제안한다. 핫 티어 용량은 늘릴 수 있지만 줄일 수 없으므로 작게 시작해 필요에 따라 키우는 편이 낫다는 점도 문서에서 안내한다.
캐시가 비어 있는 재시작 직후나 새 쿼리 노드가 클러스터에 합류한 때, 오래된 데이터를 조회하는 장기 쿼리에서는 오브젝트 스토리지 지연이 다시 나타난다. 원문은 비교 실험에서 약 112만 건의 범위 읽기 요청이 발생한 24시간치 쿼리를 예로 들며, 요청 수가 많을수록 병렬 처리와 함께 스토리지의 요청 한도도 고려해야 한다고 설명한다.
관련 자료: Parseable의 오브젝트 스토리지 기반 구조, 실험 설정, Parseable의 쿼리 처리 방식, DataFusion의 범위 읽기 병합 설명, 캐시를 활용한 조회 가속, 일반적인 관측성 쿼리, 버킷과 SSD 비교 실험, 시간 측정 분석, 캐시 용량 산정, 캐시가 차가울 때의 제약, 오브젝트 스토리지는 너무 느린가, Facebook Gorilla 모니터링 쿼리 연구.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요