TL;DR
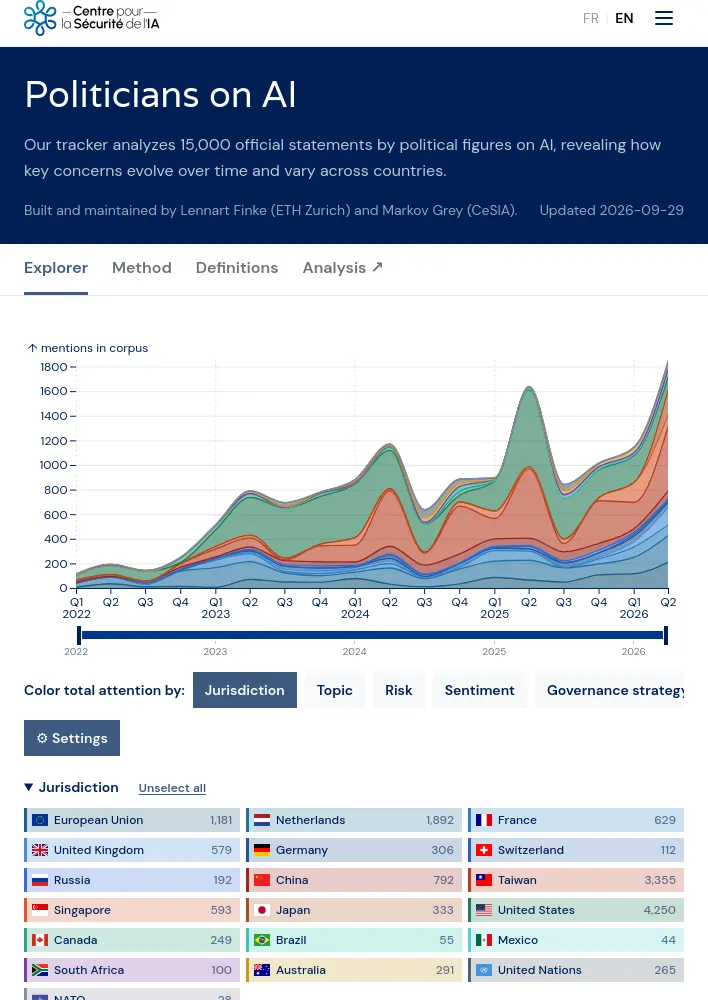
- 정치인의 AI 관련 공식 발언 1만5천 건을 분석해 주요 우려가 시간에 따라 어떻게 변하고 국가별로 어떻게 다른지 보여주는 추적기임.
- 정부 공식 자료에서 발언을 수집하고 11개 언어별 키워드 목록으로 AI 언급 발언을 선별함.
- 대형 언어 모델(LLM) 기반 판정자 3명이 발언을 독립적으로 평가하며, 3명 중 2명 이상이 동의한 발언만 데이터셋에 포함함.
- 국가별 비교를 위한 대표성이나 완전성을 보장하지 않지만, 같은 관할권 안에서 시간에 따른 변화는 대체로 대표한다고 설명함.
- 데이터셋 버전 2.10.0은 2026년 9월 22일 갱신됐으며, CSV·TSV·JSON으로 내려받을 수 있고 수집 코드와 페이지 코드는 오픈소스임.
자주 묻는 질문
데이터셋은 어떻게 만들었나?
- 의회 기록, 부처 보도자료 페이지, 기관 API 등 정부 공식 자료에서 문서를 수집하고, 한 명의 발언자에 해당하는 발언 단위로 분리함.
- 자료가 작성된 11개 언어 각각의 키워드 목록으로 AI를 언급하는 발언을 추림.
- 살아남은 발언은 LLM 판정자 3명이 각각 점수를 매기고 태그를 지정함. 3명 중 2명 이상이 해당 발언이 실질적이고, 한 명의 발언자에게 속하며, 발언자가 공직자라는 데 동의할 때만 데이터셋에 포함함.
- 판정 프롬프트와 사람의 표본 점검 결과를 포함한 전체 절차는 방법 페이지에서 확인할 수 있으며, 코드는 저장소에서 확인할 수 있음.
인용문은 어떻게 수집했나?
- 의회 기록 등 정부 공식 웹사이트에서 인용문을 가져옴. 전체 출처 목록은 방법 페이지에 있음.
- 축약된 인용문은 프로그램을 통해 원문과 대조함.
포함 국가를 어떻게 결정했나?
- AI 관련 담론의 양과 공식 인용 데이터의 이용 가능성을 기준으로 국가를 포함함.
- 저작권 문제로 일부 자료는 제외함.
- 국가나 정부 간 기구의 추가를 요청할 수 있음.
누가 만들었나?
- ETH Zurich의 Lennart Finke와 CeSIA의 Markov Grey가 함께 제작함.
- 의견과 질문은 lennart@finke.dev로 보낼 수 있음.
태그 지정에 AI를 사용했나?
- 기존 AI 위험 분류 체계인 MIT AI Risk Repository와 AI 규제 자료인 Existential Risk Observatory의 AI Governance and Regulatory Archive에 기반한 정의, 그리고 별도로 정한 포괄적 키워드를 사용함.
- 태그는 LLM 기반 판정자 3명의 다수결로 지정함. 태그의 세부 사항과 정의는 방법 페이지와 태그 정의에서 확인할 수 있음.
사람이 모든 인용문과 태그를 확인하나?
- 모든 인용문과 태그를 사람이 확인하지는 않음. 다만 사람의 평가와 판정자 간 일치도를 표본 점검함. 자세한 내용은 방법 페이지에 있음.
- 태그가 부정확해 보이는 경우 짧은 인용문이 발췌된 더 큰 발언 단위와 관련된 문제일 수 있으므로, 원문 링크를 확인해야 함.
- 발언자 이름과 프로필 정보도 모두 사람이 확인한 것은 아님.
인용문 모음은 대표성이나 포괄성을 갖추고 있나?
- 관할권 간 비교에 대해서는 대표성이나 포괄성을 갖추지 않음. 국가별로 가장 중요한 자료를 포함하려고 하지만 일부 관할권의 주요 AI 논의를 놓쳤을 가능성이 있음.
- 한 관할권 안에서 시간에 따른 데이터는 대체로 대표한다고 설명함. 예를 들어 EU에서 공공 투자 관련 인용문 비중이 2023년부터 2026년까지 늘어난다면 이를 실제 변화로 해석할 것을 권고함.
최근 한두 달의 인용문 수가 줄어든 이유는 무엇인가?
- 일부 데이터 출처의 공개가 지연돼 최근 몇 달간 인용문 수가 감소한 것처럼 보일 수 있음.
- 미국 의회와 하원 청문회 자료에서 특히 두드러지며, 공개 지연이 최대 1년에 이를 수 있음.
프로젝트 코드가 오픈소스인가?
- 페이지 코드와 데이터 수집 코드를 모두 오픈소스로 공개함.
데이터를 사용할 수 있나?
- 데이터는 아래 내려받기 항목에서 이용할 수 있음.
내려받기
- 분석용 전체 데이터셋을 내려받을 수 있음.
- CSV와 TSV는 인용문 하나당 한 행으로 구성되며, 읽기 쉬운 열 이름을 사용하고 여러 값이 있는 필드는 세로줄로 구분함.
- 제공 형식: CSV, TSV, JSON.
- 데이터셋 버전은 2.10.0이며, 갱신일은 2026년 9월 22일임.
인용
- 데이터셋은 일반 텍스트 또는 BibTeX 형식으로 인용할 수 있음.
- 일반 텍스트 인용: Finke, Lennart, & Grey, Markov. (2026). *Governments on Superintelligence* (Version 2.10.0; updated 2026-09-22) [Data set]. Centre pour la Sécurité de l’IA. https://cesia.org/en/data/quotes/
- BibTeX 서지 정보: 저자 Finke, Lennart 및 Grey, Markov; 제목 *Governments on Superintelligence*; 발행자 Centre pour la Sécurité de l’IA; 연도 2026; 버전 2.10.0; URL https://cesia.org/en/data/quotes/; 최종 갱신일 2026-09-22임.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요