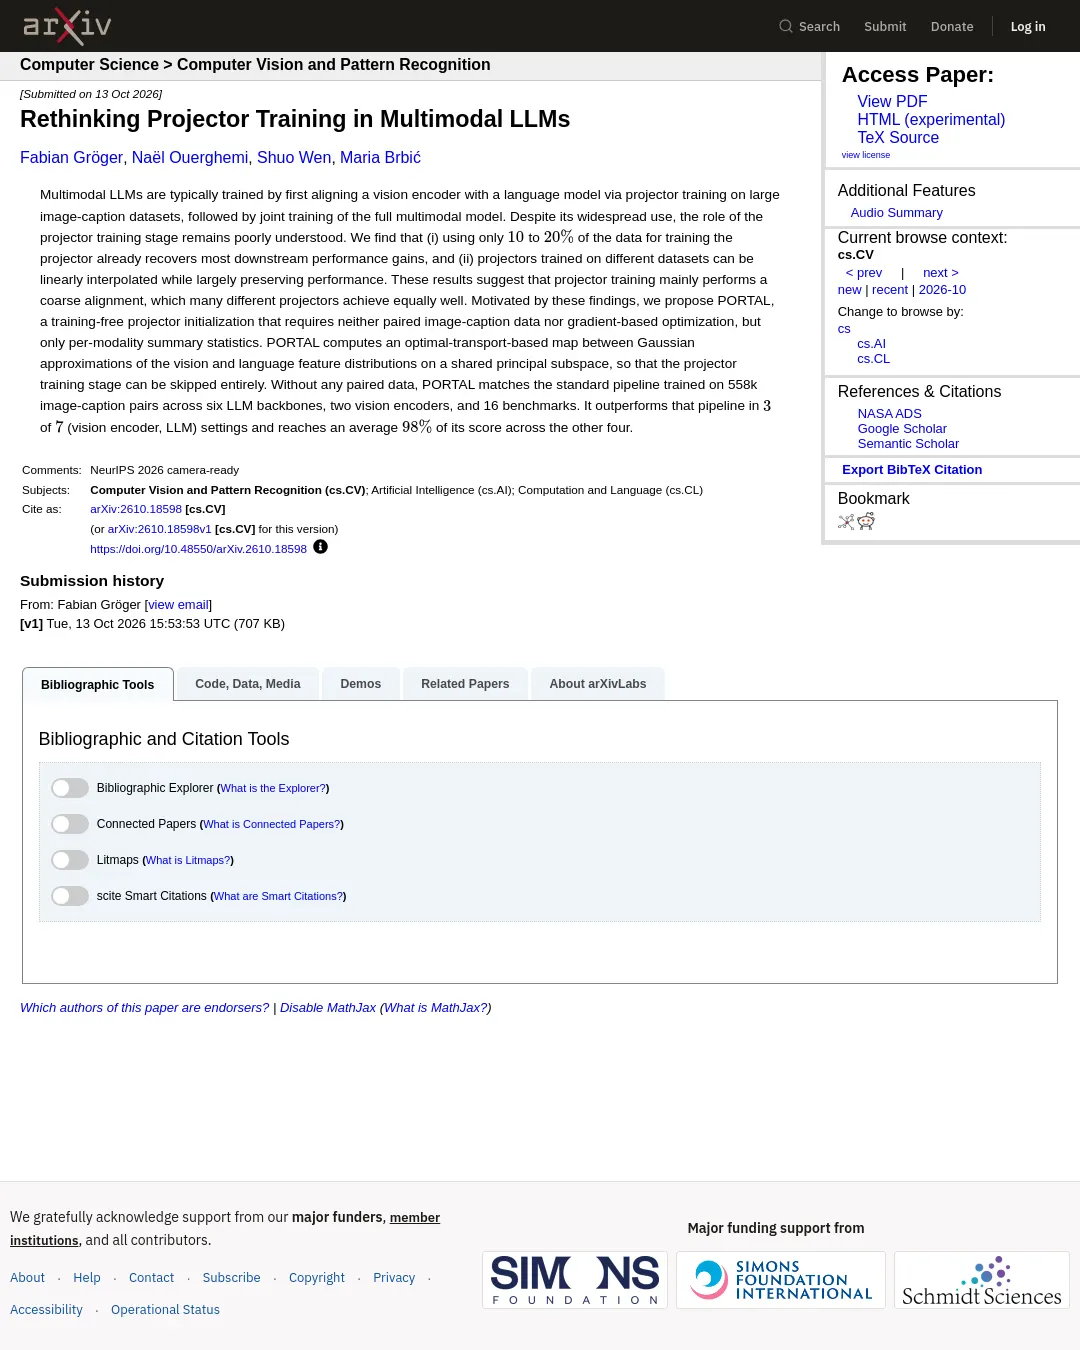
멀티모달 대규모 언어 모델을 학습할 때 이미지 인코더와 언어 모델을 연결하는 프로젝터 학습을 생략하는 방법 PORTAL이 제안됐다. 연구진은 이미지-캡션 짝 데이터 없이도 기존 학습 파이프라인에 근접한 성능을 냈다고 보고했지만, 결과는 논문 초록에 제시된 실험 조건에 한정된다.
논문에 따르면 프로젝터 학습에 전체 데이터의 10~20%만 써도 후속 과제 성능 향상의 대부분을 얻었으며, 서로 다른 데이터셋으로 학습한 프로젝터도 선형 보간해 성능을 대체로 유지할 수 있었다. 연구진은 이를 바탕으로 프로젝터 학습이 정교한 정렬보다 대략적인 정렬을 수행한다고 해석했다.
PORTAL은 이미지와 언어 특징의 요약 통계만으로 두 특징 분포를 정렬하는 초기화 방식이다. 최적수송(optimal transport)을 이용해 각 분포의 가우스 근사 사이에 변환을 계산하며, 이미지-캡션 짝 데이터나 기울기 기반 최적화는 필요하지 않다.
연구진은 6개 LLM 백본, 2개 비전 인코더, 16개 벤치마크에서 PORTAL을 평가했다. 짝 데이터 없이 만든 PORTAL은 이미지-캡션 쌍 55만 8천 개로 학습한 표준 파이프라인과 비교해 7개 비전 인코더·LLM 조합 중 3개에서 더 높은 점수를 냈고, 나머지 4개 조합에서는 평균 점수의 98%에 도달했다고 밝혔다.
논문은 2026년 10월 13일 arXiv에 제출됐다. 초록에는 벤치마크별 점수나 실험의 세부 조건이 제시되지 않아, 요약된 결과만으로 조합별 차이나 재현성을 판단하기는 어렵다. 논문 초록 · PDF · HTML
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요