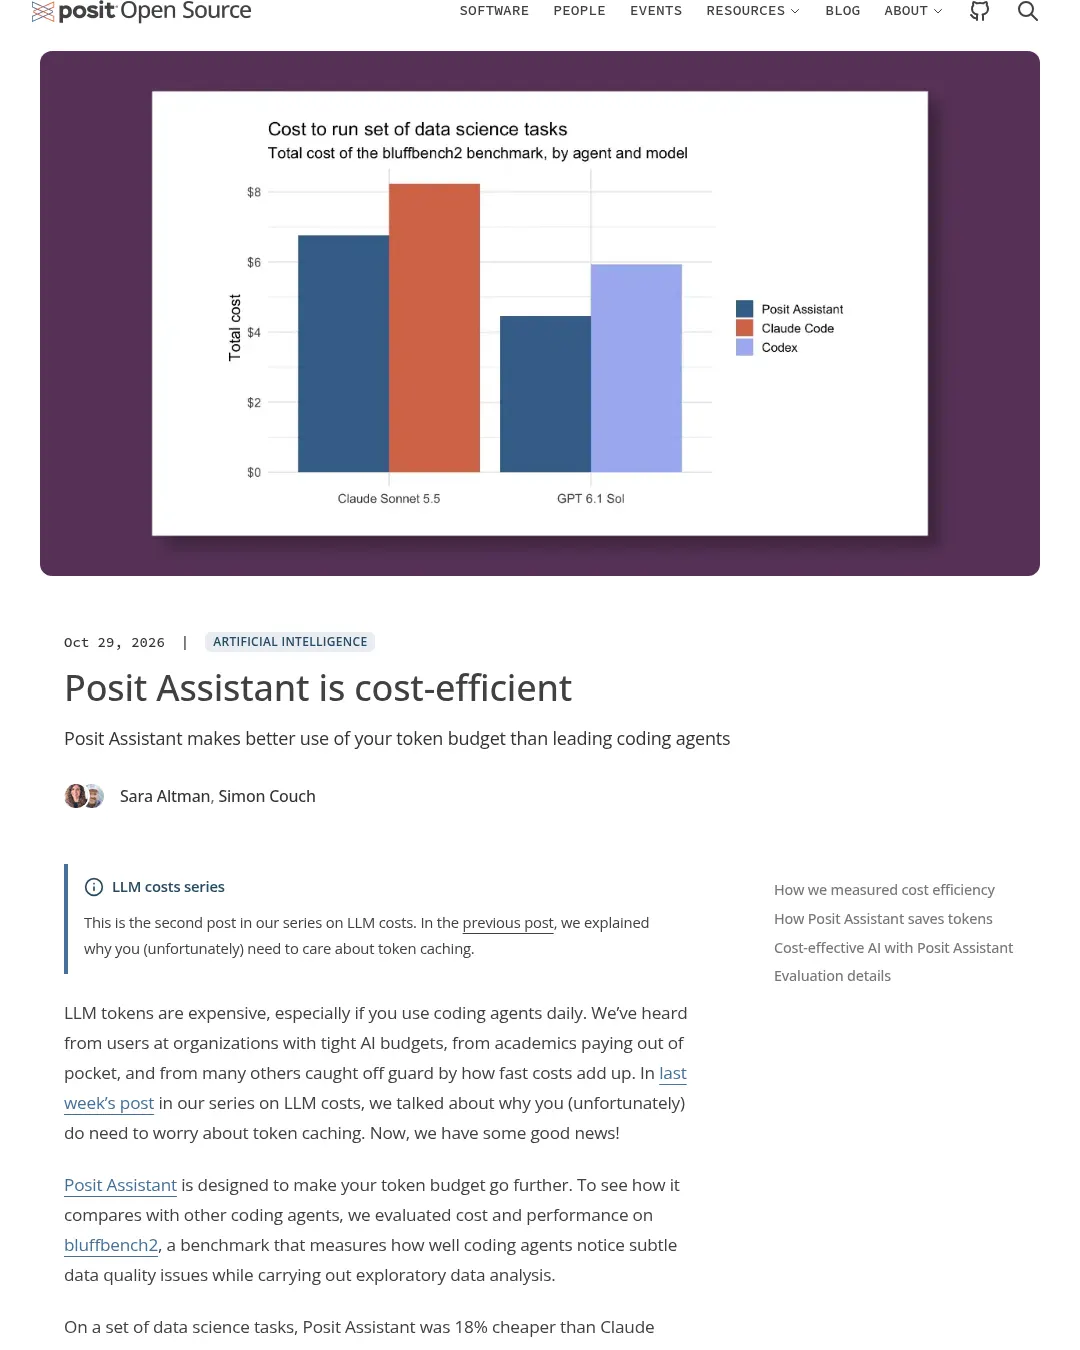
Posit는 자체 평가에서 Posit Assistant가 데이터 분석 과제를 Claude Code보다 18%, Codex보다 25% 낮은 비용으로 수행했다고 밝혔다. 평가 점수는 Claude Code와 비슷했고, Codex에서 Posit Assistant로 바꾼 경우에는 점수가 44% 높았다. 다만 소프트웨어 개발 과제 평가에서는 성능 차이가 통계적으로 확인되지 않았다.
Posit는 데이터 분석 중 미묘한 데이터 품질 문제를 찾아내는 벤치마크 bluffbench2로 세 도구를 비교했다. 표의 비용은 각 평가에서 과제를 수행하는 데 든 총액이다.
| 모델 | 도구·실행 방식 | 점수 | 총비용(USD) |
|---|---|---|---|
| Claude Sonnet 5.5 | Posit Assistant | 42% | $6.76 |
| Claude Sonnet 5.5 | Claude Code + Console | 38% | $7.27 |
| Claude Sonnet 5.5 | Claude Code, 셸만 사용 | 42% | $8.24 |
| GPT 6.1 Sol | Posit Assistant | 17% | $4.46 |
| GPT 6.1 Sol | Codex + Console | 9% | $5.77 |
| GPT 6.1 Sol | Codex, 셸만 사용 | 12% | $5.92 |
여기서 Console은 MCP를 통해 지속적으로 유지되는 R 세션에 접근하는 방식이며, 셸만 사용하는 경우는 스크립트로 R을 실행한다는 뜻이다. bluffbench2는 탐색적 데이터 분석 과정에서 에이전트가 시각화에 드러난 미묘한 데이터 품질 문제를 알아차리는지 측정한다.
Posit는 Python 소프트웨어 개발 과제 벤치마크 DeepSWE 1.1도 평가했다. 이 시험에서는 Posit Assistant가 Claude Code와 비슷한 비용으로 더 높은 점수를 냈고, Codex보다 비용이 낮았지만 점수는 낮았다.
| 모델 | 도구 | 점수 | 총비용(USD) |
|---|---|---|---|
| Claude Sonnet 5.5 | Posit Assistant | 71% (24/34) | $12.72 |
| Claude Sonnet 5.5 | Claude Code | 50% (17/34) | $13.20 |
| GPT 6.1 Sol | Posit Assistant | 74% (25/34) | $14.05 |
| GPT 6.1 Sol | Codex | 79% (27/34) | $15.92 |
다만 DeepSWE 평가는 Python 과제만 대상으로 모델 두 개를 중간 추론 수준에서 한 번씩 실행했다. Posit는 이 정도 규모로는 성능의 큰 차이만 통계적으로 가려낼 수 있으며, 관측된 점수 차이는 통계적으로 잡음과 구별되지 않는다고 설명했다. 따라서 이 결과만으로 Posit Assistant가 소프트웨어 개발 과제에서 더 낫다고 결론 내릴 수는 없다. 두 평가의 전체 로그는 여기에서 볼 수 있다.
Posit는 비용 차이의 이유로 간결한 지침, 작업 도구의 사용 방식, 캐시 효율 등을 들었다. 예를 들어 Posit Assistant는 R 세션에서 코드를 실행하고 결과로 그래프 이미지를 받을 수 있다. Claude Code나 Codex는 같은 작업에 R 세션 초기화와 이미지 저장 코드를 작성한 뒤, 별도 도구로 이미지를 읽어야 할 수 있다. Posit는 이런 반복 작업이 대화 중 토큰 사용량을 늘릴 수 있다고 설명한다.
Posit Assistant는 파일이 길 때 전체 내용을 한꺼번에 보여주기보다 일부만 제공하고 더 구체적인 검색을 요청한다. 여러 파일을 읽는 등 병렬로 할 수 있는 작업은 병렬 수행을 유도하고, 캐시 적중률을 높이며 사용자가 곧 대화를 다시 볼 것으로 예상되면 캐시를 유지한다고 Posit는 밝혔다. Claude Code와 Codex에도 MCP 도구인 mcp-console을 연결해 지속적인 R 세션을 제공할 수 있지만, Posit는 이 설정이 시작 단계에서 추가 토큰을 사용한다고 설명했다.
이번 평가에는 Claude Code v2.1.309, Codex v0.161.0, Posit Assistant v1.9.1이 사용됐다. 재현에 쓰인 코드는 GitHub 저장소에 공개돼 있다. Posit는 이번 결과를 바탕으로 Posit Assistant의 비용을 낮추는 작업을 계속하겠다고 밝혔다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요