대형 PostgreSQL 테이블에서 대략적인 집계나 표본을 빠르게 확인하려면 TABLESAMPLE을 쓸 수 있다. 다만 SYSTEM은 행이 아니라 페이지를 뽑으므로, 행이 저장된 순서와 값이 연관돼 있으면 표본이 치우칠 수 있다.
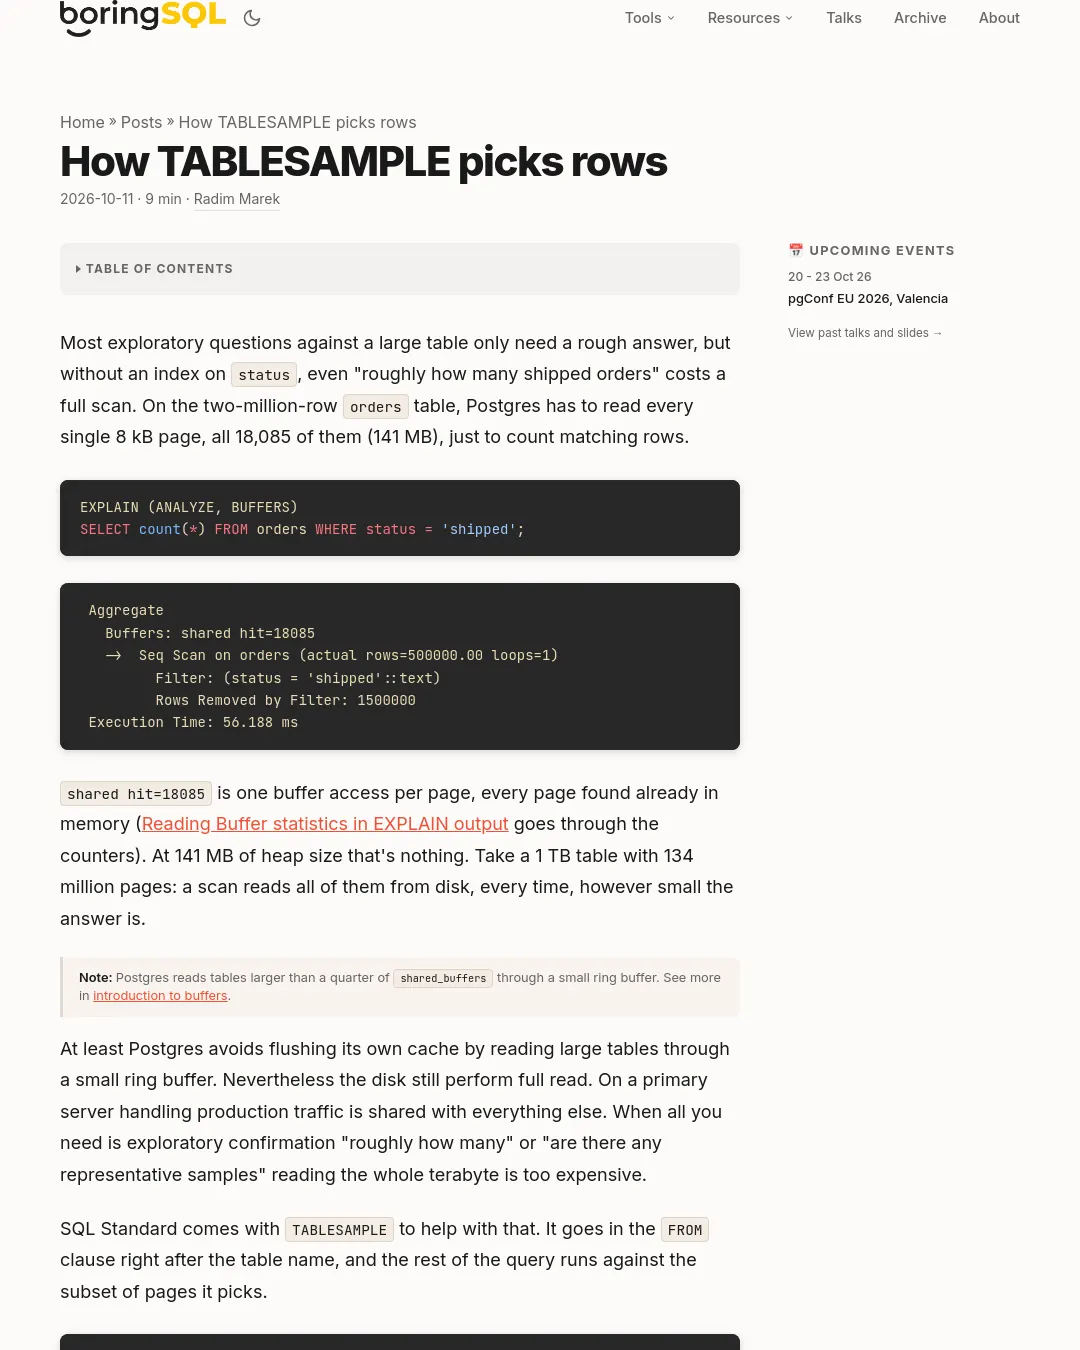
2백만 행의 orders 테이블에서 status = 'shipped'인 행을 세려면 인덱스가 없을 경우 전체 18,085개 페이지, 총 141MB를 읽는다. 1TB 테이블이라면 약 1억 3,400만 페이지를 읽어야 한다. PostgreSQL은 shared_buffers의 4분의 1보다 큰 테이블을 작은 링 버퍼로 읽어 자체 캐시를 밀어내지 않지만, 디스크에서 전체 테이블을 읽는 비용은 남는다.
TABLESAMPLE은 FROM 절에서 테이블 이름 바로 뒤에 붙이며, 뒤따르는 쿼리는 선택된 표본만 대상으로 실행한다. 예를 들어 TABLESAMPLE SYSTEM (1)은 약 1%를 뽑지만 표본 행 수가 고정되지는 않는다. 이 사례에서 서로 다른 시드로 얻은 표본은 18,107~20,416행이었다. 정확한 행 수를 지정하려면 contrib의 tsm_system_rows 확장 기능이 제공하는 SYSTEM_ROWS (n)을 쓸 수 있다.
표본에 대한 count(*)나 sum()은 전체 추정치를 얻으려면 직접 비율에 맞춰 환산해야 한다. 이 사례에서는 count(*) * 100으로 배송 완료 주문 수를 추정했을 때 실제 50만 건에 대해 49만 2천 건이 나왔다. 이 쿼리는 전체 순차 스캔에서 18,085페이지를 읽는 대신 177페이지를 읽었고, 실행 시간은 56.188ms에서 0.829ms로 줄었다. 평균·비율·최댓값·최솟값은 표본에서 나온 값을 그대로 읽는다.
하지만 표본은 무작위 행이 아니라 주소를 고른다. PostgreSQL의 테이블 페이지는 행을 담고, 각 행은 페이지 번호와 페이지 안의 위치로 이뤄진 ctid 주소를 갖는다. SYSTEM은 페이지 번호를 기준으로 선택해 페이지 전체의 행을 가져온다. BERNOULLI는 페이지 안의 행 위치까지 포함해 행마다 선택하므로 모든 페이지를 열어야 한다. 이 테이블에서 SYSTEM은 1.2ms, BERNOULLI는 10.4ms가 걸렸다.
행을 created_at 순서로 넣은 사례에서는 한 페이지에 약 107초 분량의 주문이 모였다. 따라서 SYSTEM 표본은 시간대별로 흩어진 행이 아니라 짧은 구간 약 200개를 뽑는다. 가장 오래된 주문의 시간을 구하는 쿼리를 1% 표본으로 여섯 번 실행했을 때 결과는 실제 값인 00:00:01보다 44분에서 거의 5시간 늦었다. 반면 무작위 순서로 저장한 테이블에서는 같은 쿼리가 매번 실제 값에서 몇 분 이내에 나왔다. 시간 열, 계속 증가하는 ID, 묶음 단위로 적재한 데이터에서는 이런 편향이 중요하다. 무작위 값인 amount의 평균은 두 방식에서 같았다.
REPEATABLE (42)는 시드를 고정해 같은 주소를 선택한다. 하지만 그 주소에 같은 행이 남아 있는지는 테이블 변경에 달려 있다. 행을 추가하거나 삭제해도 기존 행의 주소는 그대로이고, VACUUM도 살아 있는 행의 위치를 바꾸지 않는다. 반면 VACUUM FULL과 CLUSTER는 테이블을 새로 만들어 행의 주소를 바꾸므로 표본이 사실상 다시 뽑힌다. UPDATE는 새 행 버전을 만들기 때문에 BERNOULLI 표본의 주소가 달라질 수 있다. 이 사례에서는 업데이트한 행의 99%가 HOT 업데이트였고, SYSTEM 표본은 같은 페이지를 계속 선택했지만 BERNOULLI는 새 행 위치를 다시 추첨했다.
개발이나 테스트에 쓸 표본을 다음 날에도 같은 행으로 유지해야 한다면 주소 대신 기본 키를 해시하는 방법이 있다. 예를 들어 (hashint8extended(id, 42) & 1023) < 10은 1,024개 버킷 중 10개를 골라 전체의 0.98%를 반환한다. 이 사례에서는 삭제, 업데이트, VACUUM FULL, CLUSTER 뒤에도 살아남은 행이 표본에 그대로 남았다. 다만 모든 행의 해시를 계산하므로 전체 스캔이 필요했고, 실행 시간은 단일 프로세서에서 44.4ms, 병렬 작업자 두 명을 쓸 때 21.5ms였다. 자주 쓰는 부분집합이라면 해시 표현식에 인덱스를 만들어 이 사례에서 8.5ms의 비트맵 스캔으로 조회할 수 있었다.
외래 키로 연결된 표본이 필요하다면 양쪽 테이블에서 같은 키를 해시해야 한다. 사례에서는 customers.id와 orders.customer_id를 같은 방식으로 표본 추출해 484명의 고객과 그 고객의 주문 19,432건을 함께 얻었다. SYSTEM으로 따로 표본을 뽑으면 표본 주문 17,595건 가운데 78건은 표본에 고객이 없었다.
TABLESAMPLE은 지정한 테이블만 줄인다. 조인에서 주문 테이블을 1% 표본으로 줄여도 고객 테이블을 해시하는 비용은 그대로 남아 전체 쿼리는 3.3배 빨라지는 데 그쳤다. 표본 스캔은 리더 프로세스에서 실행되므로 병렬 작업자도 사용하지 않는다. 또한 표본을 고른 뒤 WHERE 조건을 적용하므로 조건에 맞는 행만 표본으로 뽑는 기능은 아니다. 조인 결과 자체에 표본을 적용할 수도 없다.
빠른 대략값이 필요하고 관심 열이 행의 저장 순서와 무관하다면 SYSTEM을 쓸 수 있다. 저장 순서와 관련된 열을 살펴보고 전체 테이블을 한 번 읽는 비용을 감당할 수 있다면 BERNOULLI가 적합하다. 같은 행을 유지하거나 외래 키 관계를 보존해야 한다면 키 해시를 고려할 수 있다. PostgreSQL의 ANALYZE도 표본으로 pg_stats를 만들지만, 자체 블록 표본 추출기를 사용하며 시드를 지정할 수 없어 데이터가 그대로여도 실행마다 수치가 달라질 수 있다.
실험은 PostgreSQL 18.6의 postgres:18 이미지에서 shared_buffers = 1GB로 설정하고 캐시를 데운 상태에서 진행했다. 제시된 실행 시간은 방법 간 비교를 위한 것으로, 다른 환경의 실행 시간을 예측하는 수치는 아니다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요