확률 프로그래밍
애드리안 샘프슨(Adrian Sampson) · Cornell University
프로그래밍 언어와 머신러닝 분야는 지난 몇 년 동안 ‘확률 프로그래밍’이라는 이름 아래 공통의 연구 관심사를 발전시켜 왔다. 추상화와 재사용 같은 강력한 프로그래밍 언어 개념을 통계 모델링에 적용해, 지금은 난해하고 수고가 많이 드는 작업을 다루려는 접근이다.
강의 자료의 원본은 GitHub에 있다. 오류를 발견하면 pull request를 열어 달라고 안내한다.
확률 프로그래밍이 다루는 것
확률 프로그래밍은 직관과 달리 확률적으로 동작하는 소프트웨어를 작성하는 일이 아니다. 암호화 키 생성기나 운영체제 커널의 ASLR 구현, 회로 설계를 위한 시뮬레이티드 어닐링 최적화 프로그램이 작업의 일부로 rand(3)를 호출하는 것은 괜찮지만, 확률 프로그래밍이 다루는 주제는 아니다.
이를 일반적인 소프트웨어 작성으로 생각하지 않는 편이 좋다. C++, Haskell, Python은 철학이 서로 다르지만, 어느 언어로든 고양이 사진 정리 시스템이나 LaTeX의 새로운 대안을 만들 수 있다고 상상할 수 있다. 어떤 분야에는 한 언어가 더 적합할 수 있어도 모두 실용적인 선택이다. 확률 프로그래밍 언어(PPL)는 그렇지 않다. Prolog와 비슷하게 프로그래밍 언어이기는 하지만, 완전한 소프트웨어를 만드는 데 적합한 도구는 아니다.
확률 프로그래밍은 통계 모델링을 위한 도구다. 프로그래밍 언어 분야의 교훈을 통계 모델을 설계하고 사용하는 문제에 적용한다. 전문가들은 이미 종이에 수학적 표기법으로 직접 통계 모델을 만들지만, 이는 전문가만 할 수 있고 기계적 추론을 지원하기 어렵다. 핵심은 통계 모델링을 충분히 해 보면 프로그래밍과 비슷하게 느껴진다는 점이다. 실제 프로그래밍 언어로 모델을 표현하면, 개별 사례마다 논문을 써야 했던 작업을 자동화할 수 있는 도구가 가능해진다.
또 다른 정의로, 확률 프로그래밍 언어는 rand와 프로그램의 통계적 행동을 이해하도록 돕는 여러 도구를 갖춘 일반적인 프로그래밍 언어다. 두 정의는 같은 핵심을 서로 다른 관점에서 설명한다. 어느 정의가 유용한지는 확률 프로그래밍을 무엇에 쓰려는지에 따라 달라진다. 다만 PPL 프로그램이 실행 결과를 얻으려는 일반 소프트웨어처럼 보인다는 점에 현혹되면 안 된다. PPL의 목표는 실행이 아니라 분석이다.
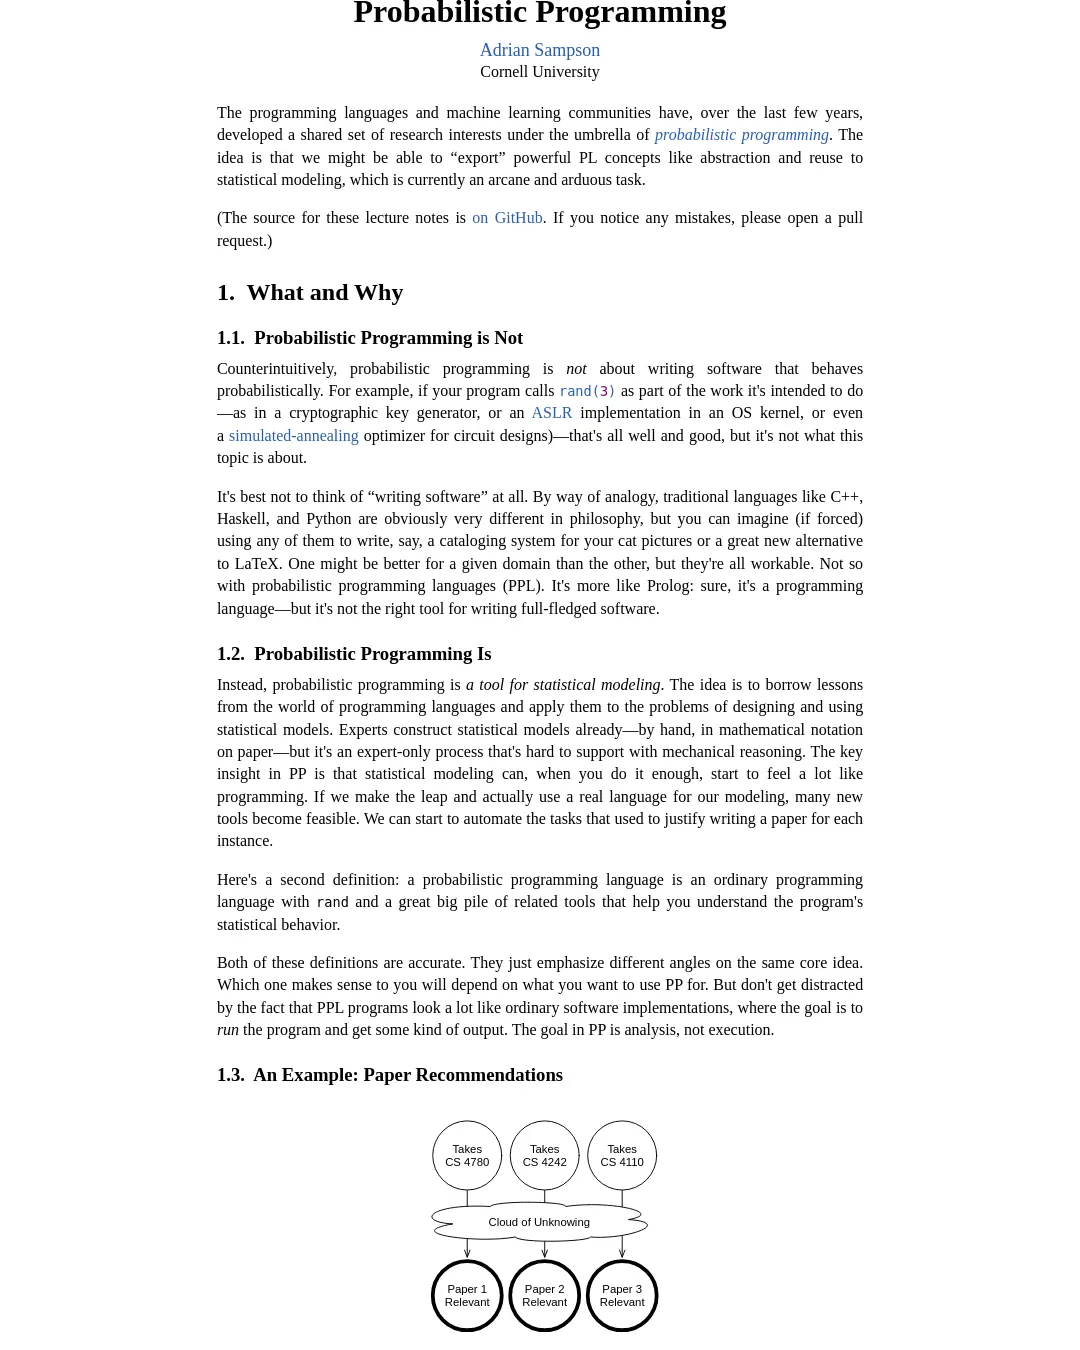
예시로, 학생이 수강한 과목을 바탕으로 연구 논문을 추천하는 시스템을 생각해 보자. 단순화를 위해 연구 분야는 프로그래밍 언어와 통계·머신러닝 두 가지뿐이라고 하자. 논문은 프로그래밍 언어 논문일 수도, 통계 논문일 수도, 두 분야 모두에 속할 수도 있다. Cornell의 과목은 CS 4110(프로그래밍 언어), CS 4780(머신러닝), 그리고 확률 프로그래밍을 다루는 가상의 선택 과목 CS 4242 세 가지로 둔다.
수강 과목에 드러난 관심 분야가 읽고 싶은 논문을 알려 준다는 생각은 자연스럽다. 하지만 그 관계를 정확히 판단하기는 어렵다. CS 4780을 듣는 학생은 통계에 관심이 있을 가능성이 높겠지만, 얼마나 더 높은가? 시간표에 맞는 유일한 과목이라서 들었다면 어떨까? 실제 두 과목은 듣지 않고 가상의 CS 4242만 듣는 학생은 프로그래밍 언어와 통계에 관심이 반반이라고 가정해야 할까?
문제를 모델링하기
머신러닝에서는 이 문제를 일부 잠재 변수를 포함한 확률 변수로 모델링한다. 도표의 화살표는 인과관계를 나타내지 않는다. CS 4110을 수강해서 특정 논문에 관심을 갖게 되는 것이 아니다. 수강과 논문 관심을 모두 확률적으로 일으키는 다른 요인이 있다고 보는 편이 타당하다. 이런 요인이 모델의 잠재 확률 변수다. 잠재 변수를 두면 문제를 더 직접적으로 추론하기 쉬워진다.
모델에는 사람마다 통계와 프로그래밍 언어에 대한 관심을 나타내는 잠재 변수를 둘 수 있다. 여기에 수강 여부에 영향을 주는 세 번째 숨은 요인인 바쁨 정도도 추가한다. 관심이 있어도 모든 과목을 듣는 것은 아니며, 바쁠수록 어느 과목이든 수강할 가능성이 낮아진다.
이 구조는 베이즈 네트워크다. 각 정점은 확률 변수이고 각 간선은 통계적 의존성을 나타낸다. 간선으로 연결되지 않은 변수는 통계적으로 독립이다. 즉, 한 변수에 대해 알아도 다른 변수의 결과를 알 수 없다.
모델을 완성하려면 잠재 관심 변수가 논문의 관련성에 어떤 영향을 주는지도 노드와 간선으로 표현한다. 관심도와 바쁨 정도를 사람에게 직접 물어보는 대신, 관찰할 수 있는 정보로부터 이를 추론한다. 그렇게 추론한 정보로 학생에게 어떤 논문이 관련 있는지 예측한다.
수식으로 만드는 모델의 한계
지금까지 모델의 의존성을 그림으로 나타냈지만, 변수 사이의 관계를 구체적으로 정해야 한다. 보통은 확률 변수들을 연결하는 수식을 작성한다.
$ \text{Pr} [ A_\text{4780} | I_\text{stats} \wedge B ] = 0.3 $
$ \text{Pr} [ A_\text{4780} | I_\text{stats} \wedge \neg B ] = 0.8 $
$ \text{Pr} [ A_\text{4780} | \neg I_\text{stats} ] = 0.1 $
$ ... $
$ \text{Pr} [ A_\text{4242} | I_\text{stats} \wedge I_\text{PL} ] = 0.3 $
$ \text{Pr} [ A_\text{4242} | I_\text{stats} \wedge I_\text{PL} \wedge \neg B ] = 0.8 $
$ \text{Pr} [ A_\text{4242} | \neg (I_\text{stats} \vee I_\text{PL}) ] = 0.1 $
$ ... $
$ R_1 \sim I_\text{PL} \wedge I_\text{stats} $
$ R_2 \sim I_\text{PL} $
$ R_3 \sim I_\text{stats} $
이처럼 단순한 모델에도 수식이 많이 필요하다. 게다가 어려운 부분은 따로 있다. 관측값을 바탕으로 잠재 변수를 추정하는 통계적 추론이다. 통계적 추론은 머신러닝 연구의 핵심이지만 쉽지 않다. 전통적으로 전문가는 손으로 새 모델을 만들 때마다 전용 추론 알고리즘도 설계한다.
이 작은 사례만 봐도 통계 모델을 손으로 만드는 일이 얼마나 번거로운지 알 수 있다. 어셈블리 코드를 쓰는 것과 비슷하다. 프로그래밍처럼 느껴지는 일을 하지만 추상화, 재사용, 설명적인 변수 이름, 주석, 디버거, 타입 시스템이 없다. 예를 들어 과목 수강 확률의 수식을 반복해서 적는 일은 지루하다. 함수 같은 프로그래밍 언어의 추상화를 적용할 수 있는 문제다. PPL의 목표는 이미 익숙한 프로그래밍 언어의 강력한 개념을 통계 분야로 가져오는 것이다.
webppl로 보는 기본 개념
확률 프로그래밍 언어의 기본 개념을 설명하기 위해 JavaScript에 내장된 PPL인 webppl을 사용한다. Stanford의 노아 굿맨(Noah Goodman)과 안드레아스 슈툴뮐러(Andreas Stuhlmüller)가 집필 중인 책 The Design and Implementation of Probabilistic Programming Languages에서 이 언어를 더 읽을 수 있다. 브라우저에서 직접 사용해 볼 수 있어 입문용으로 알맞다.
무작위 연산
PPL을 이루는 첫 번째 요소는 난수를 뽑는 기본 연산이다. 이 단계의 PPL은 rand 호출이 있는 일반적인 명령형 언어처럼 보인다. 다음은 단순한 webppl 프로그램이다.
var b = flip(0.5);
b ? "yes" : "no"
이 프로그램은 공정한 동전 던지기의 결과에 따라 문자열 하나를 반환한다. 불리언 값을 무작위로 만드는 flip 함수를 사용할 수 있는 일반 프로그램과 똑같이 동작한다. flip 같은 함수는 기본 무작위 연산이라고도 하며, 이 프로그램에서 모든 무작위성의 근원이 된다.
webppl 편집기에서 실행하면 때로는 “yes”, 때로는 “no”를 출력한다. webppl은 개별 값뿐 아니라 분포 전체도 표현할 수 있다. Enumerate 연산은 함수가 정의하는 분포의 모든 확률을 출력한다.
var roll = function () {
 var die1 = randomInteger(6) + 1;
 var die2 = randomInteger(6) + 1;
 return die1 + die2;
}

var dist = Enumerate(roll);
print(dist);
viz.auto(dist);
출력에는 주사위 합으로 가능한 2부터 12까지의 값과 각각의 확률이 나온다. viz.auto는 webppl의 브라우저 인터페이스에 그래프를 표시하도록 한다.
Enumerate를 roll 함수에 여러 번 실행하는 방식으로도 만들 수 있어 보이지만, 실제로는 분포의 근삿값을 얻기 위해 실행 결과를 표본 추출하는 것이 아니다. 함수가 실행될 수 있는 모든 경우를 열거해 정확한 분포를 얻는다. PPL의 핵심은 프로그램을 직접 실행하는 것이 아니라 프로그램을 분석하는 도구다.
예시 모델을 webppl로 표현하기
논문 추천 모델의 수식을 함수로 작성할 수 있다. 하나는 관련성을, 다른 하나는 과목 수강을 표현하고, 학생 프로필을 무작위로 만들어 확인한다.
// Class attendance model.
var attendance = function(i_pl, i_stats, busy) {
 var attendance = function (interest, busy) {
 if (interest) {
 return busy ? flip(0.3) : flip(0.8);
 } else {
 return flip(0.1);
 }
 }
 var a_4110 = attendance(i_pl, busy);
 var a_4780 = attendance(i_stats, busy);
 var a_4242 = attendance(i_pl && i_stats, busy);

 return {cs4110: a_4110, cs4780: a_4780, cs4242: a_4242};
}

// Relevance of our three papers.
var relevance = function(i_pl, i_stats) {
 var rel1 = i_pl && i_stats;
 var rel2 = i_pl;
 var rel3 = i_stats;

 return {paper1: rel1, paper2: rel2, paper3: rel3};
}

// A combined model.
var model = function() {
 // Some even random priors for our "student profile."
 var i_pl = flip(0.5);
 var i_stats = flip(0.5);
 var busy = flip(0.5);

 return [relevance(i_pl, i_stats), attendance(i_pl, i_stats, busy)];
}

var dist = Enumerate(model);
viz.auto(dist);
실행하면 관측 가능한 데이터 전체의 분포가 나온다. 그 자체로는 그다지 유용하지 않지만, 학생에 대해 아무것도 모를 때 모델은 학생이 어떤 과목도 듣지 않고 어떤 논문에도 관심이 없을 가능성이 꽤 높다고 예측한다.
조건 지정
PPL의 또 다른 핵심 요소는 조건 지정이다. 조건 지정을 통해 프로그램 실행 하나에 어느 정도의 가중치를 줄지 정할 수 있다. 계산을 일부 수행한 뒤 실행 중간에 가중치를 선택할 수 있으며, 특정 실행을 완전히 무관한 것으로 표시해 제외할 수도 있다.
조건 지정은 관측 내용을 표현하는 데 유용하다. 과정의 결과에 대해 알고 있는 정보가 있다면, 그 관측이 참이어야 하거나 참일 가능성이 높다는 점을 전달할 수 있다. 주사위 사례에서 첫 번째 주사위 값이 4였다고 하자. 이 정보에 조건을 걸면 주사위 중 적어도 하나가 4인 경우를 전제로 합계의 분포를 얻는다.
var roll = function () {
 var die1 = randomInteger(6) + 1;
 var die2 = randomInteger(6) + 1;

 // Only keep executions where at least one die is a 4.
 if (!(die1 === 4 || die2 === 4)) {
 factor(-Infinity);
 }

 return die1 + die2;
}
예상할 수 있듯이 결과는 8을 제외하면 균등하다. 합이 8이 되려면 4가 포함된 주사위 조합이 하나뿐이므로 8은 가능성이 더 낮다. 2와 12는 주사위 중 하나가 4인 조건에서 나올 수 없어 확률이 0이다.
반대로 주사위 값을 보지 못하고 합이 10이라는 말만 들었다면, 조건을 합계에 걸어 두 주사위 값의 분포를 구할 수 있다.
var roll_condition = function () {
 var die1 = randomInteger(6) + 1;
 var die2 = randomInteger(6) + 1;

 // Discard any executions that don't sum to 10.
 var out = die1 + die2;
 if (out !== 10) {
 factor(-Infinity);
 }

 // Return the values on the dice.
 return die1 + "+" + die2;
}
같은 원리를 추천 모델에도 적용할 수 있다. 관심 있는 사람의 수강 과목을 조건으로 지정하면 추천을 만들 수 있다. 예를 들어 강의자인 자신은 CS 4110과 가상의 CS 4242를 듣고 CS 4780은 듣지 않는다고 설정한다.
// A model query that describes my class attendance.
var rec = function() {
 var i_pl = flip(0.5);
 var i_stats = flip(0.5);
 var busy = flip(0.5);

 // Require my class attendance.
 var att = attendance(i_pl, i_stats, busy);
 require(att.cs4242 && att.cs4110 && !att.cs4780);

 return relevance(i_pl, i_stats);
}
이 예시에서 require는 factor(-Infinity)를 감싸며 조건을 만족하지 않는 프로그램 실행을 완전히 제거한다고 정의한다. rec에 Enumerate를 호출하면 논문 관련성의 분포를 얻는다. 논문 하나만 보려면 다음처럼 반환값을 바꿀 수 있다.
return relevance(i_pl, i_stats).paper1;
열거기에 어떤 실행이 관련 있는지 알려 주면, 그 조건 아래에서 데이터에 대해 알 수 있는 내용을 얻는다. 확률 모델을 표현할 때는 변수 사이의 의존성을 일일이 수식으로 적는 대신 프로그램 실행 흐름으로 구성할 수 있다. 생성 모델을 작성하는 일은 직관적이고 간단하며, 단순한 모델의 추론 부담을 컴파일러와 도구로 옮길 수 있다.
추론 알고리즘
Enumerate는 PPL이 해결하려는 핵심 문제인 통계적 추론의 한 구현이다. 특히 조건 지정이 있는 일반적인 확률 프로그램의 추론은 어렵다. Enumerate는 무작위 기본 연산이 취할 수 있는 모든 값에 대해 프로그램의 결과를 알아내야 하므로 경우의 수가 지수적으로 증가한다. 부동소수점 수를 도입하면 문제는 더 분명해진다. 0.0과 1.0 사이의 수를 뽑는다면 가능한 값이 매우 많고, 이를 히스토그램으로 표현할 수도 없다.
Enumerate는 규모가 큰 문제에는 적합하지 않다. 그래서 효율적인 PPL 추론 알고리즘이 활발히 연구된다. 모든 실행을 살펴보지 않는 알고리즘도 있다.
거부 표본 추출(rejection sampling)은 표본을 사용하는 간단한 방법이다. 프로그램을 여러 번 실행하면서 각 무작위 기본 연산에서 값을 뽑고, 조건 지정에 따라 표본에 가중치를 적용해 합산한다. 조건 문에 도달했을 때 일부 실행을 거부하기 때문에 이런 이름이 붙었다. webppl에는 ParticleFilter라는 방식이 내장돼 있다. 앞서 든 예시에는 다음처럼 적용할 수 있다.
var sampled = ParticleFilter(rec('paper1'), 1000);
거부 표본 추출은 작은 사례에는 쓸 수 있지만 조건 지정이 있으면 문제가 생긴다. factor 호출에 도달해 결국 거부될 표본을 뽑느라 많은 작업을 낭비할 수 있다. 더 영리한 표본 추출 방법 가운데 가장 널리 알려진 것은 마르코프 체인 몬테카를로(MCMC)다. webppl 표준 라이브러리는 MCMC 알고리즘을 제공한다. MCMC를 정확하고 효율적으로 만드는 일은 PPL 연구에서 활발히 다뤄지는 문제이며, 강의에서는 자세히 설명하지 않는다.
활용 사례와 연구 기법
확률 프로그래밍의 지향점을 낙관적으로 말하면 머신러닝의 대중화다. 널리 알려진 적용 사례로는 TrueSkill이 있다. 이 모델은 ESOP'11 논문에서 처음 소개됐으며, 멀티플레이어 Xbox 게임에서 선수 간 대결을 구성하는 데 사용된다. 선수의 실력을 잠재 변수로 모델링하고, 예측 승률이 50 대 50에 가까운 상대끼리 매칭한다.
webppl 책에는 생성적인 ‘순방향’ 모델을 ‘역방향’으로 활용해 상호 보완적인 문제를 푸는 컴퓨터 비전 데모가 있다. Forest는 인지, 자연어 처리, 문서 검색 등 여러 분야의 PPL 생성 모델을 모은 자료다. 아직 정식 적용 사례라고 하기는 어렵지만, Lyric Semiconductor의 벤 비고다(Ben Vigoda), 노아 굿맨 등은 확률 프로그래밍을 중심으로 하는 것으로 보이는 스타트업 Gamalon을 설립했다. 또 다른 응용은 확률적 행동을 다루는 일반 프로그램을 이해하는 것이다. 센서를 다루는 근사 컴퓨팅과 보안·난독화에는 확률적 행동을 다루는 일반 소프트웨어가 많다.
확률 프로그래밍 연구는 프로그래밍 언어 분야의 아이디어를 일반 소프트웨어의 확률적 동작에도 적용한다. 한 프로젝트는 통계적 특성을 지닌 소프트웨어의 정확성 제약을 표현하는 방법으로 확률적 단언을 제안했다. 일반적인 assert 문을 확률적으로 일반화한 passert가 핵심이다. 이 프로젝트의 목표는 다음과 같다.
- C와 C++를 생각할 수 있는 LLVM 프로그램처럼 실제 프로그래밍 언어로 작성된 복잡한 프로그램을 다룬다.
- 근사 프로그램의 품질 기준처럼 출력의 통계적 특성을 빠르게 검사한다.
- 조건 지정을 다루지 않는다. 일반 소프트웨어에는
factor문이 필요하지 않아passert검사를 단순화할 수 있다.
마이크로소프트의 확률 프로그래밍 언어이자 구현체인 R2는 다운로드할 수 있다. R2의 한 구성 요소는 고전적인 프로그래밍 언어 아이디어를 적용해 통계적 추론을 개선한다. 특히 가장 단순한 무작위 추론 방식인 거부 표본 추출을 약한 전제조건(weakest precondition) 분석으로 개선한다.
약한 전제조건 접근은 조건 지정을 처리할 때 많은 계산을 한 뒤에야 결과를 버려야 한다는 문제를 다룬다. 앞서 나온 다음 예시에서는 프로그램 뒤쪽에서 조건을 확인하므로 단순한 방법을 쓰면 비효율적이다. 여기서는 설명을 위해 마지막에서 두 번째 줄의 덧셈이 비싸다고 가정한다.
var die1 = randomInteger(6) + 1;
var die2 = randomInteger(6) + 1;

// Discard any executions that don’t sum to 10.
var out = die1 + die2;
require(out === 10);
조건 검사를 프로그램의 앞쪽으로 옮기면 더 빨리 실패하게 할 수 있다. 이것이 약한 전제조건 분석의 핵심이다. 즉, 뒤쪽 지점 B에서 어떤 조건을 참으로 만들려면 앞쪽 지점 A에서 무엇이 참이어야 하는지 묻는다. 이 예시에서는 조건을 앞으로 옮긴다.
var die1 = randomInteger(6) + 1;
var die2 = randomInteger(6) + 1;

require((die1 == 3 && die2 == 7) || ...);
var out = die1 + die2;
운이 좋으면 조건을 무작위 표본 추출 연산까지 거슬러 옮길 수 있다. 그러면 뒤에서 거부될 실행에 드는 작업을 아예 피할 수 있다.
확률 프로그래밍은 표준 프로그래밍 언어 연구의 아이디어를 PPL에도 가져올 수 있다는 가능성을 제시한다. 사례로는 정적 분석을 통한 단언 증명, 종료 검사, 프로그램 슬라이싱, 프로그램 합성이 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요