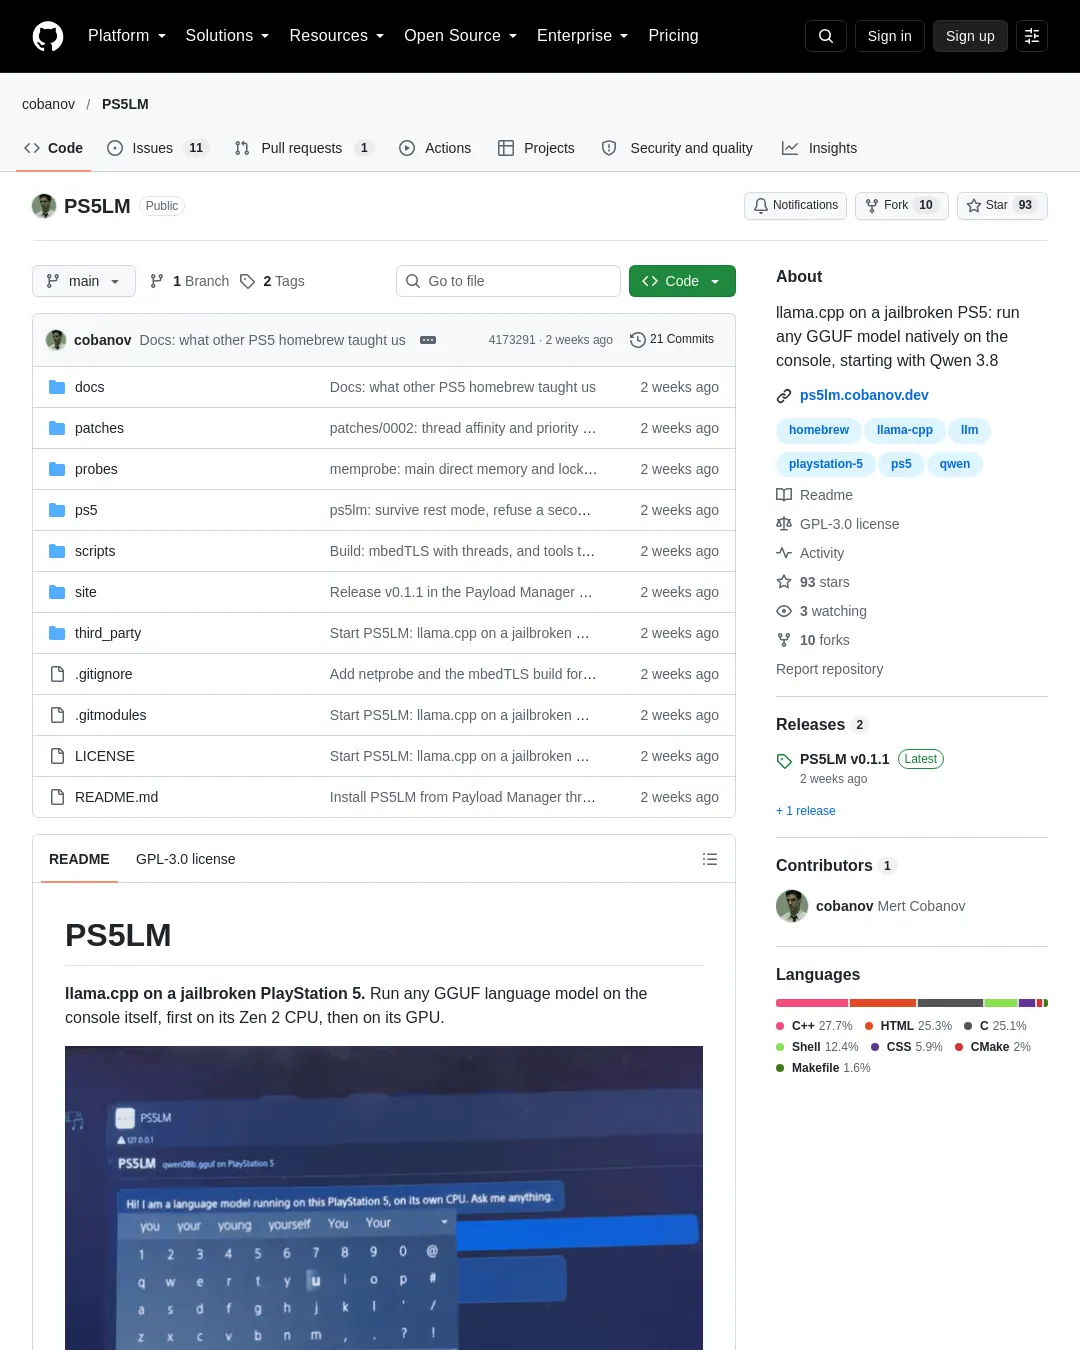
PS5LM은 탈옥한 PS5에서 llama.cpp를 실행해 GGUF 언어 모델을 콘솔에서 구동하는 프로젝트다. 현재 v0.1은 최대 1.6GB 모델을 지원하며, PS5 브라우저에서 모델을 내려받아 실행하고 채팅할 수 있다.
데모 영상과 작동 방식을 확인할 수 있다. 현재 카탈로그에는 Qwen3.5 0.8B와 2B가 있으며, 프로젝트 설명에 따르면 각각 초당 13~21토큰, 약 9토큰을 생성한다. 페이로드가 홈 화면의 메모리를 고갈시키지 않도록 모델 메모리를 약 1.6GB로 제한했기 때문이다. 더 큰 모델을 실행하려면 네이티브 앱이 필요하며, 관련 내용은 이슈 #4에 정리돼 있다.
사용하려면 소유한 PS5의 펌웨어가 7.00~13.60이어야 하고, 콘솔이 탈옥돼 있어야 한다. 페이로드 로더도 필요하다. Payload Manager를 이용할 경우 설정에서 Multiple Payload Sources를 켜고 https://ps5lm.cobanov.dev/payloads.json을 추가한 뒤, 목록에서 PS5LM을 설치해 불러온다. 또는 최신 릴리스에서 ps5lm.elf를 내려받아 페이로드로 실행할 수 있다.
실행하면 PS5 브라우저에 PS5LM 라이브러리가 열린다. 모델에서 Download를 누른 뒤 Run, Open chat 순으로 선택하고 DualSense로 입력하면 된다. 같은 네트워크에 연결된 휴대전화나 컴퓨터에서는 http://<console IP>:8082로 라이브러리에 접속할 수 있으며, 8081 포트의 채팅 API는 OpenAI API 형식을 지원한다. 모델은 /data/PS5LM/models에 저장되며, FTP로 이 경로에 복사한 GGUF 파일도 라이브러리에 표시된다.
프로젝트는 특정 모델용 GPU 커널을 따로 작성하는 대신 llama.cpp 자체를 PS5에 이식했다. 제작자는 이에 따라 llama.cpp가 지원하는 Qwen, Llama, Mistral, Gemma 등의 아키텍처와 1비트부터 8비트까지의 양자화 모델을 사용할 수 있다고 설명한다. 다만 현재 페이로드 환경에서는 작은 모델만 실행할 수 있다. 프로젝트가 첫 목표로 든 Qwen 3.8은 270억 매개변수 모델로, 콘솔 메모리에 맞추려면 2~3비트 양자화가 필요하다고 설명돼 있다. 아직 PS5에서 실행한 사례는 없다고 프로젝트는 밝혔다.
개발 환경 구성에는 ps5-payload-dev SDK와 호스트 LLVM이 필요하다. 소스 빌드 및 콘솔 실행 절차는 저장소 문서, 로드맵, 실행 가능한 모델 목록, 이식 참고 사항에서 확인할 수 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요