PyTorch는 모델의 순전파와 역전파를 빠르게 실행하고 메모리를 아끼기 위해 연산을 저장하거나 다시 계산한다. 이 글은 제한된 메모리 안에서 저장할 연산을 고르는 0/1 배낭 문제와, 동적 계획법을 개선하는 슬라이딩 윈도·허시버그 기법을 설명한다.
PyTorch에서 배낭 문제를 푸는 이유
각 연산은 실행 시간과 저장 공간을 필요로 한다. 메모리 예산이 제한되어 있으므로, PyTorch는 어떤 연산을 저장하고 어떤 연산을 다시 계산할지 선택해야 한다. 저장한 연산은 재사용해 실행 시간을 줄일 수 있다. 이 선택은 메모리를 용량으로, 연산을 물건으로, 실행 시간 절약을 가치로 보는 0/1 배낭 문제로 나타낼 수 있다.
현재 PyTorch의 기본 배낭 문제 솔버는 동적 계획법을 사용하는 dp_knapsack이다. 각 물건을 차례로 살펴보며, 해당 용량에서 얻을 수 있는 최대 가치를 표에 기록한다. 표를 다 채우면 주어진 메모리 예산에서 얻을 수 있는 최대 가치를 알 수 있다.
어떤 항목을 선택했는지 알아내려면 표를 거슬러 올라가야 한다. 현재 칸과 바로 위 칸의 값이 다르면 해당 항목이 선택된 것이다. 값이 같으면 선택되지 않았으므로 다시 계산할 항목이 된다.
슬라이딩 윈도와 허시버그 기법
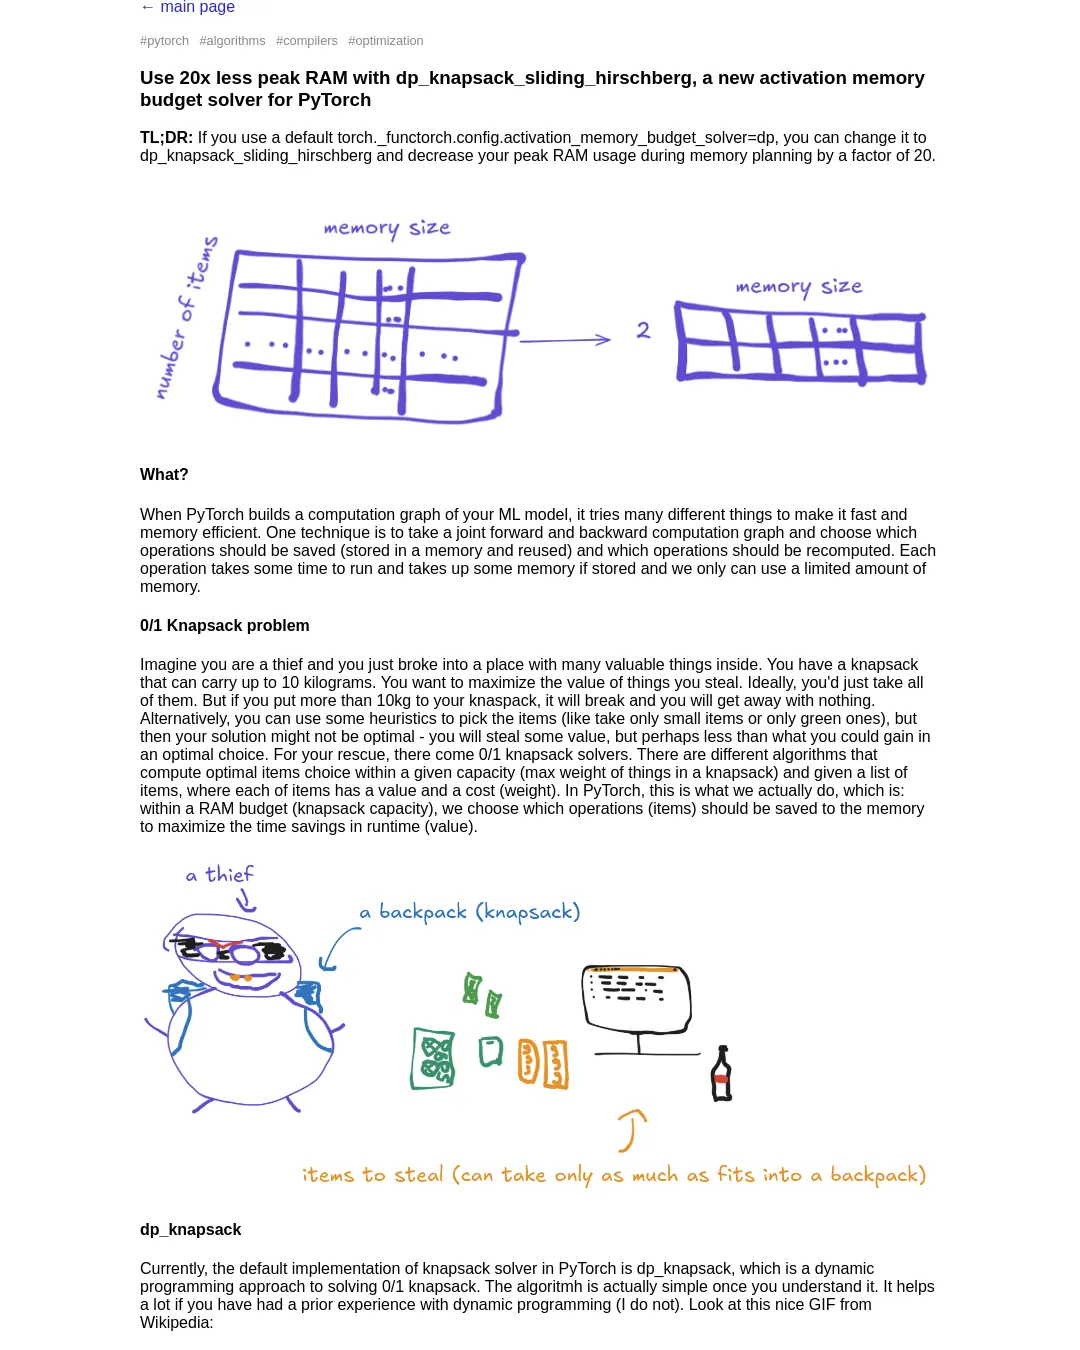
기본 구현은 항목 수와 최대 용량에 비례하는 크기의 2차원 표를 만든다. Horace He(Chillee)는 필요할 경우 슬라이딩 윈도와 허시버그 기법으로 메모리를 줄일 수 있다고 코드에 메모를 남겼다.
슬라이딩 윈도는 전체 표 대신 이전 행과 현재 행만 사용한다. 하지만 이 방법만으로는 최대 가치를 계산할 수 있어도 어떤 항목을 선택했는지 알아내기 어렵다. 허시버그 기법은 문제를 작은 부분으로 나누어 해결하며, 역추적 없이 저장할 항목과 다시 계산할 항목을 구성한다.
이 구현은 항목의 구간과 사용 가능한 용량을 명시적 스택에 담아 처리한다. 구간에 항목이 하나만 남으면 용량에 들어가는지 확인해 저장할 항목 또는 다시 계산할 항목으로 분류한다. 항목이 여러 개라면 구간을 둘로 나누고, 각 부분의 동적 계획법 계산에는 슬라이딩 윈도를 사용한다. 두 결과를 더해 가장 높은 값이 나오는 위치를 분할점으로 삼고, 항목과 용량을 나눠 같은 절차를 반복한다. 분할된 한쪽이 비어도 유효한 경우이므로 건너뛴다.
CodeForces의 KokiYmgch가 그림과 함께 설명한 허시버그 알고리즘
솔버 선택과 사용법
dp_knapsack_sliding_hirschberg는 표 크기를 (항목 수, 최대 용량)에서 (2, 최대 용량)으로 줄인다. 글에서는 메모리 사용량이 최대 20배 줄었다고 설명한다. 64GB RAM을 갖춘 작성자의 컴퓨터에서는 dp_knapsack이 항목 100개인 문제에서 충돌했지만, 개선된 솔버는 같은 메모리 예산에서 항목 2000개를 처리했다. 실행 속도도 약 37% 빨라졌다고 보고했으나, 측정은 엄밀하게 이뤄지지 않았다고 밝혔다.
글은 속도보다 정확성이 우선이라면 greedy_knapsack을, SciPy를 프로젝트에 추가할 수 있다면 정확한 해를 제공하면서 기존 PyTorch 동적 계획법 솔버보다 훨씬 빠른 ilp_knapsack을 권한다. 패키지 관리자로 PyTorch를 설치했다면 기본 솔버인 dp_knapsack을 그대로 사용할 수 있다. 그 밖의 경우에는 dp_knapsack_sliding_hirschberg를 선택할 수 있다.
사용 설정은 다음과 같다.
import torch import torch._functorch.config as fconfig fconfig.activation_memory_budget_solver = fconfig.dp_knapsack_sliding_hirschberg
이 솔버 사용 중 버그를 발견하면 PyTorch 이슈 트래커에 보고하고 @jmaczan을 태그해 달라고 안내한다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요