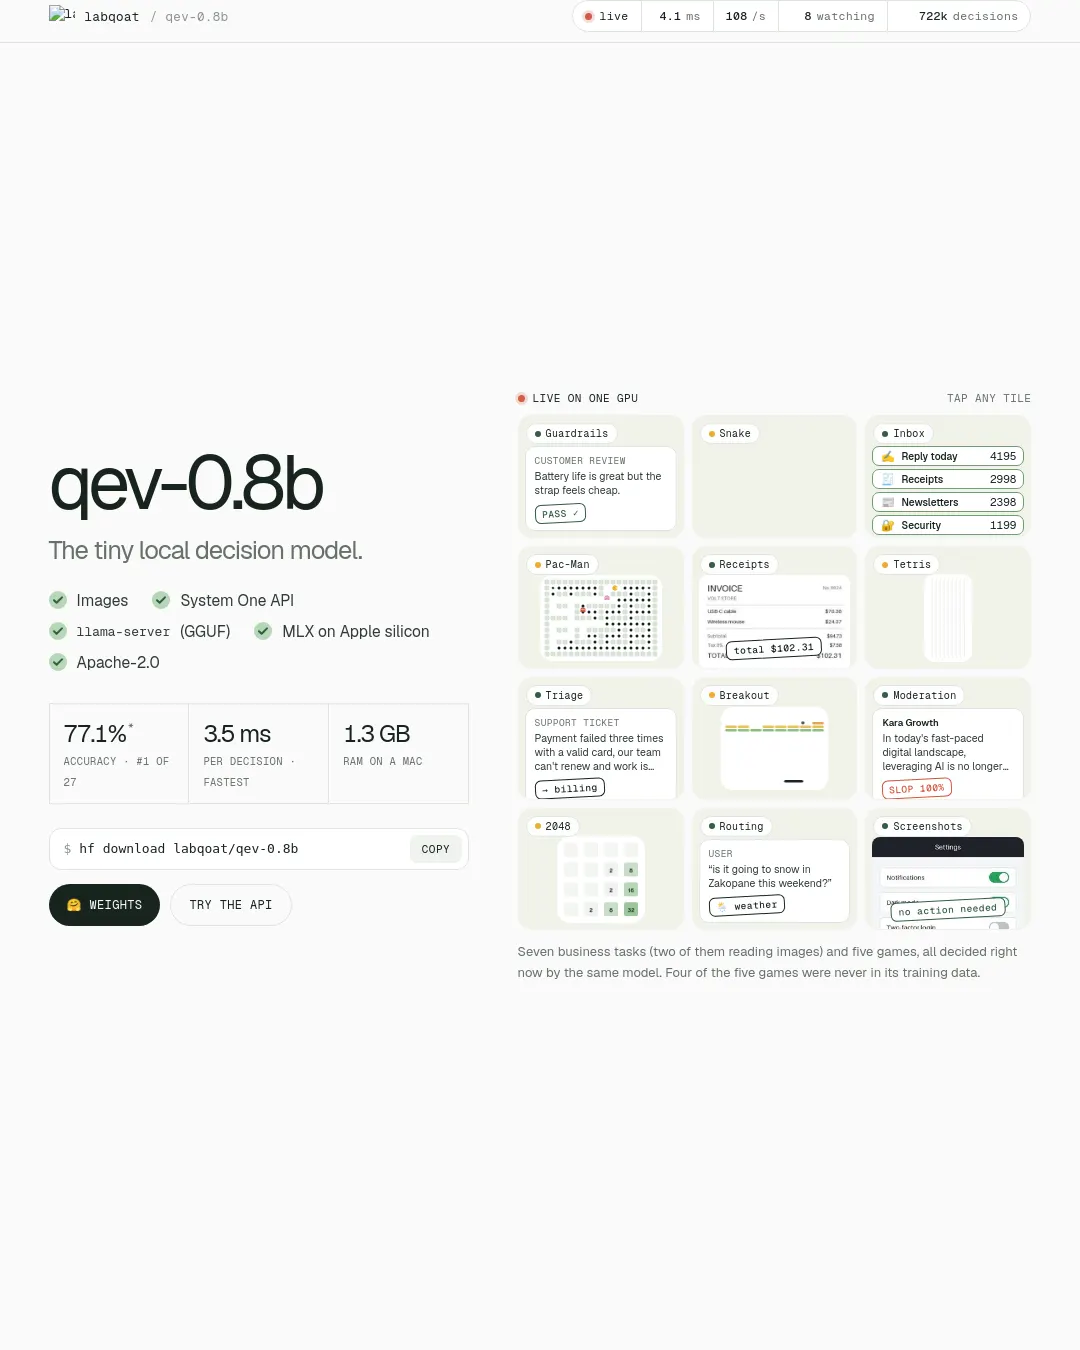
Labqoat이 공개한 Qev-0.8B는 텍스트를 생성하는 대신 선택지·예/아니요·점수 질문에 확률 분포로 답하는 8억 매개변수 모델이다. Labqoat의 비교에서 Benchmark Heaven 정확도 77.1%로 약 10억 매개변수 규모의 의사결정 모델 27개 중 가장 높은 점수를 기록했고, NVIDIA L40S에서 요청당 중앙값 지연 시간은 3.5ms였다.
모델은 CUDA, Apple 실리콘용 MLX, llama.cpp용 GGUF 형식으로 제공되며 라이선스는 Apache-2.0이다. Labqoat은 8비트 모델이 Mac에서 1.3GB 메모리를 사용한다고 밝혔다. 로컬에서 실행할 수 있어 데이터가 기기 밖으로 나가지 않으며 토큰 비용도 들지 않는다고 설명한다. 가중치 다운로드와 API 체험이 가능하다.
비교 결과에는 조건과 단서가 있다. 77.1%는 Benchmark Heaven 공개 분할의 의사결정 항목 231개에서 나온 점수로, 표본 오차는 약 ±2.8%포인트다. Qev-0.8B는 Labqoat 자체 평가 도구로 측정했고 다른 26개 모델은 비교용 도구로 실행했다. 이 비교 도구는 이전 Qev 릴리스에 대해 자체 평가보다 한 항목 낮은 76.6%를 기록했다. 지연 시간은 L40S에서 각 모델의 자체 실행 환경으로 배치 크기 1로 측정한 요청당 중앙값이며, VRAM은 실측치가 아닌 가중치 크기에 0.5GB를 더한 추정치다. Benchmark Heaven 측정 설명
Labqoat은 JevExtra에서 72.0%, JevSpatial에서 74.2%를 기록했다고 밝혔다. JevSpatial 평가에는 학습 데이터에 포함되지 않은 Tetris, Pac-Man, Breakout, 2048, Whac-A-Mole이 들어갔다. 시연에서는 게임 코드가 각 움직임의 결과를 상태에 기록하고 모델이 이를 바탕으로 판단한다.
Qev-0.8B는 한 번에 최대 16개 질문에 답하고, /batch는 한 번의 모델 연산으로 최대 64개 요청을 처리한다. 확률을 기준으로 모델이 확신할 때만 자동으로 처리하고, 그렇지 않을 때는 사람이나 더 큰 모델에 넘기는 방식으로 활용할 수 있다. 다만 모델은 텍스트를 작성하지 않고 질문에 답하는 용도다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요