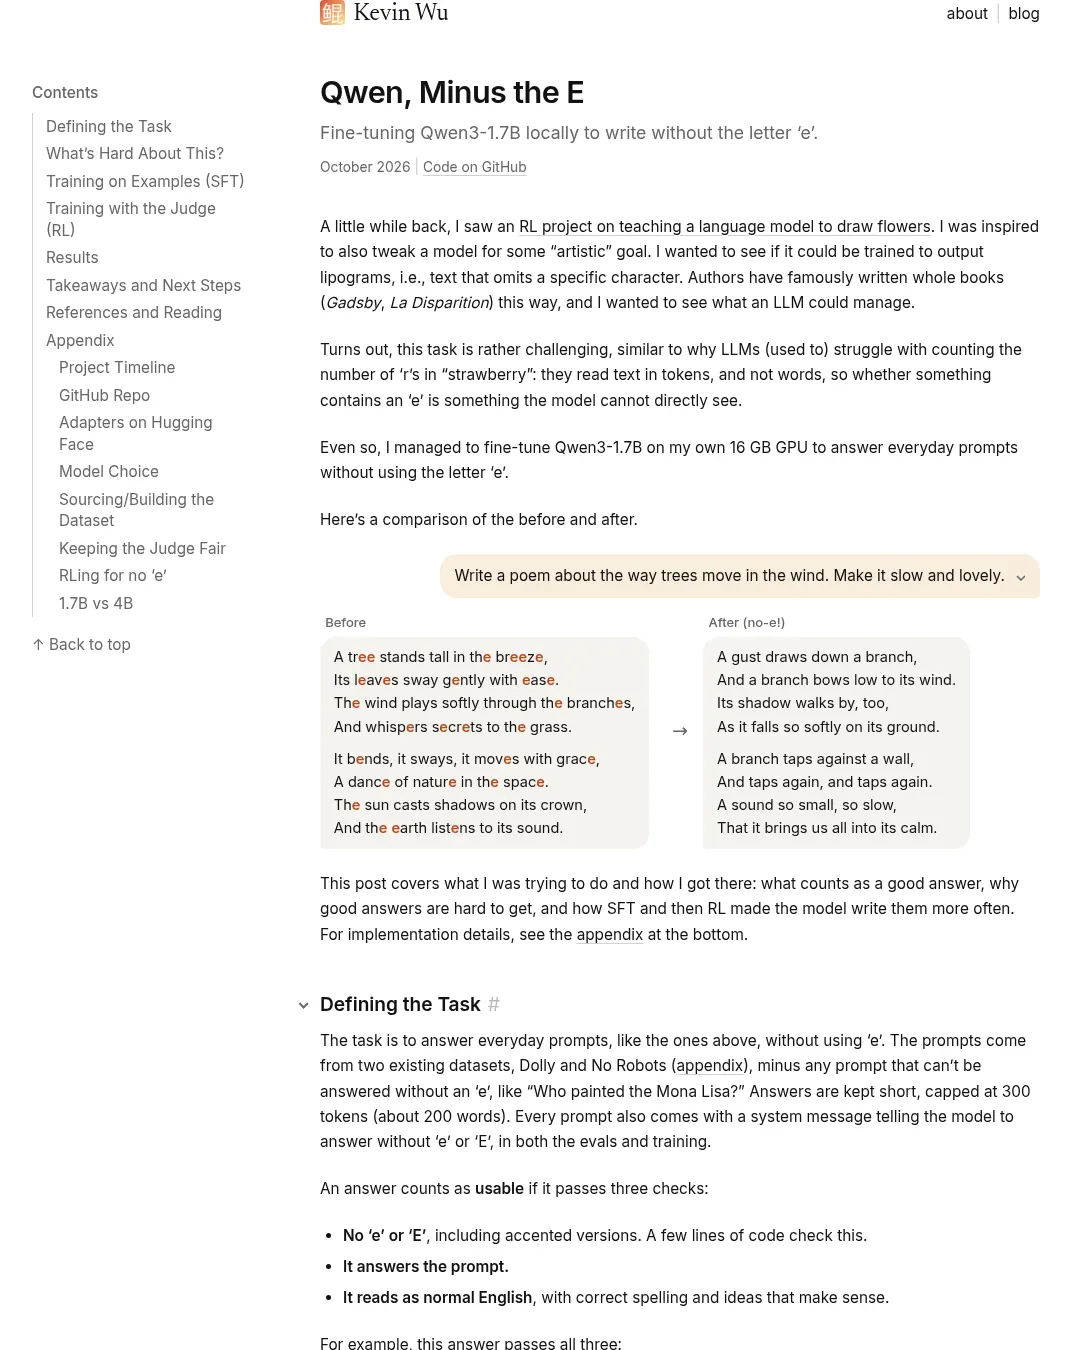
Qwen3-1.7B를 16GB GPU에서 미세조정해 영어 답변에서 ‘e’를 쓰지 않도록 하는 실험이 진행됐다. ‘e’가 없는 답변 180개로 지도 미세조정(SFT)을 한 뒤 강화학습(RL) 300단계를 거친 모델은 평가 답변 중 60.5%가 유용성 기준을 통과했다. 다만 답이 짧아지거나 질문의 일부만 답하는 문제가 남았다.
실험의 과제는 일상적인 질문에 ‘e’나 ‘E’를 쓰지 않고 답하는 것이다. 모델은 글자를 직접 처리하기보다 토큰 단위로 텍스트를 읽으므로, 어떤 단어에 ‘e’가 들어가는지 쉽게 판단하지 못한다. 연구자는 Qwen3-1.7B가 16GB GPU에서 돌아갈 수 있어 이 모델을 선택했고, LoRA 어댑터와 메모리 최적화를 사용했다.
평가에는 Dolly와 No Robots 데이터셋에서 고른 질문을 썼다. ‘벨기에의 수도는?’처럼 ‘e’ 없이 답할 수 없는 질문은 제외했다. 생성 답변은 최대 300토큰, 약 200단어로 제한했고, 평가와 학습 모두에서 ‘e’나 ‘E’를 쓰지 말라는 시스템 메시지를 제공했다.
답변이 유용하다고 판단하려면 세 조건을 모두 충족해야 했다.
- ‘e’, ‘E’와 악센트가 붙은 변형 문자가 없어야 한다. 코드 몇 줄로 검사했다.
- 질문에 답해야 한다.
- 철자와 내용이 자연스러운 영어여야 한다.
마지막 두 조건은 GPT-6 Luna가 각각 1~5점으로 평가했다. 두 항목 모두 4점 이상이어야 통과다. 글에 나온 유용성 비율은 검증 데이터에서 뽑은 질문 50개에 질문당 답변 4개를 생성한, 총 200개 답변 중 통과한 비율이다. 이 평가 점수는 이후 강화학습 보상으로도 쓰였다.
마스크와 SFT 실험
모델에게 ‘e’를 쓰지 말라고 지시하는 것만으로는 충분하지 않았다. Qwen3-1.7B는 평가 답변 200개 모두에 ‘e’를 넣었다. 강화학습에서 ‘e’가 포함됐는지만 보상으로 삼아도 문제가 해결되지 않았다. 몇 시간 만에 ‘e’를 피하는 LoRA 어댑터를 얻었지만, 무작위 글자 나열처럼 쓸모없는 답을 만들어냈다.
대신 생성 직전 ‘e’가 들어 있는 모든 토큰의 점수를 음의 무한대로 설정하는 마스크를 적용할 수 있다. 마스크는 ‘E’와 비ASCII 문자도 차단해 ‘é’ 같은 유사 문자가 들어오는 것도 막는다. 하지만 마스크는 금지 토큰을 막을 뿐, 처음부터 ‘e’가 없는 단어를 고르는 법을 가르치지는 않는다. 그 결과 반복하거나 철자를 틀리는 답이 나왔다. 예를 들어 나무척추동물에 관한 질문에 “This is a classic riddiculous and humorous riddiculous riddiculous…”라고 답했다. ‘e’는 없지만 질문에 답하지 못한 사례다.
이후 실험에서는 두 설정을 구분했다. ‘마스크 미적용’은 Qwen3-1.7B에 ‘e’를 쓰지 말라는 지시만 한 경우이고, ‘마스크 적용’은 같은 모델에 마스크를 더한 경우다. 학습 전 유용성 비율은 각각 0%, 26%였다.
기존의 ‘e’ 없는 소설로 학습하는 방법은 성과를 내지 못했다. ‘e’ 없이 쓰인 소설 *Gadsby*는 5만 단어, 약 6만9천 토큰이다. 자연스러운 ‘e’ 없는 문장 표현을 배울 것으로 기대했지만, 손실은 낮아져도 평가 결과는 마스크만 적용한 모델과 비슷한 약 26%였다. 소설은 문장을 쓰는 법을 가르칠 뿐 질문에 답하는 법을 가르치지 못했거나, 6만9천 토큰이 효과를 내기에 부족했을 가능성이 있다.
반면 질문에 맞춘 ‘e’ 없는 답변은 도움이 됐다. 해당 데이터가 없어 학습 분할에서 조건에 맞는 질문 180개를 골라 더 큰 모델들에 답변을 만들게 했다. 큰 모델도 한 번에 ‘e’ 없는 답을 내지 못하는 경우가 있었지만, 어떤 단어를 바꿔야 하는지 알려주면 대체로 빠르게 고쳤다. 이 방식은 Qwen3-1.7B에서는 통하지 않았다.
학습 예시 수에 따른 결과는 다음과 같다. 각 어댑터는 검증 손실이 오르기 시작할 때까지 학습한 뒤 평가했다.
| 학습 예시 | 0 | 15 | 30 | 45 | 90 | 135 | 180 |
|---|---|---|---|---|---|---|---|
| 마스크 적용 시 유용성 | 26% | 10% | 20.5% | 22.5% | 31.5% | 34% | 35% |
예시 180개를 쓴 어댑터는 35%로, 마스크만 적용한 모델보다 9%포인트 높았다. 이후 이를 SFT 어댑터라고 부르고 강화학습의 시작점으로 사용했다. 성과는 단순히 텍스트 양이 늘어난 결과만은 아니었다. SFT는 최대 3,072토큰짜리 전체 대화로 학습해 예시 180개가 약 11만7천 토큰이었지만, 비슷한 크기의 예시 90개만으로도 *Gadsby*보다 높은 31.5%를 기록했다.
다만 개선 폭은 둔화했다. 예시를 90개에서 180개로 두 배 늘렸을 때 상승폭은 3.5%포인트였다. 예시 15개로 학습하면 답이 길어지고 품질이 나빠졌다. 문장은 더 깔끔해졌지만 질문의 핵심 단어에 ‘e’가 필요할 때 다른 단어로 바꿔 엉뚱한 주제로 답하기도 했다. 예를 들어 ‘cliché’를 ‘clik’으로 바꾸는 식이다.
평가 점수를 보상으로 쓴 강화학습
첫 강화학습 시도는 ‘e’가 있는지만 점수화해 실패했다. 이후에는 마스크가 ‘e’를 막고, 평가자가 답변의 자연스러움과 질문 응답 여부를 채점하도록 바꿨다. 학습은 질문을 고르고 여러 답변을 생성한 뒤 평가 점수를 보상으로 변환해, 같은 질문의 다른 답변보다 점수가 높은 답변이 더 잘 생성되도록 어댑터를 업데이트하는 방식이다.
각 학습 단계의 절차는 다음과 같다.
- 질문 풀에서 질문 몇 개를 고른다.
- 각 질문마다 마스크와 ‘e’를 쓰지 말라는 시스템 메시지를 적용해 답변 묶음을 생성한다.
- 평가자가 각 답변의 자연스러움과 응답 여부를 병렬로 1~5점 평가한다.
- 두 점수를 다음 식으로 보상으로 바꾼다.
reward = (coherence − 1 + responds − 1) / 8. 두 점수가 모두 1이면 0, 모두 5이면 1이다. - 같은 질문에 대한 답변끼리 평균 보상을 빼고 점수 분산으로 나눠 비교한다. 같은 질문의 다른 답변보다 나은 답변만 강화한다.
- LoRA 어댑터를 한 번 업데이트한다.
설정은 단계당 질문 4개, 질문당 답변 8개, 샘플링 온도 0.7, 답변 최대 300토큰, 사고 과정 비활성화, LoRA 순위 16, 학습률 2e-5, KL 페널티 가중치 0.02, 학습 300단계였다. 답변은 단계당 32개였고 GPU 메모리 사용량은 최고 10~13GB였다. 16GB GPU에서 설정한 15GB 한도 안에 들었다.
질문당 답변 8개를 만든 것은 GRPO가 답변 간 점수 차이가 있어야 학습하고, 그중 적어도 하나가 유용해야 학습 효과가 크기 때문이다. 점검 결과 답변 8개 묶음의 약 3분의 2에는 유용한 답이 하나 이상 들어갈 것으로 예상했다. 처음에는 온도 1.0을 계획했지만, 이때 SFT 어댑터 답변이 ‘Ranak’, ‘palacco’ 같은 지어낸 단어를 쓰며 무너졌다. 마스크 모델은 온도 1.0과 0.7에서 비슷해 0.7을 택했다.
학습률 2e-5는 LoRA 학습 기준으로 비교적 낮다. 더 높은 값으로 시작했을 때 과적합이 반복돼 낮췄다. KL 페널티 0.02는 GRPO 구현의 기본값으로 둔 것으로, 눈에 띄는 긍정적 효과는 없었고 시작 모델의 분포가 중요하지 않으므로 불필요할 가능성이 있다고 밝혔다. 300단계는 단계당 질문 4개씩 총 1,200개 질문을 처리해 1,235개 질문 풀을 대략 한 번 훑는 규모다. 25단계마다 체크포인트를 저장하고 평가해 개선이 둔화하는 지점을 확인했다.
강화학습은 마스크 모델과 SFT 어댑터, 두 시작점에서 각각 300단계 진행했다. 새 질문 50개에 질문당 16번 답하게 했을 때, 마스크 모델은 질문의 78%에서 유용한 답을 하나 이상 냈고 SFT 어댑터는 64%였다. 거의 모든 질문에서 답변별 점수도 달랐다.
| 시작점 | 강화학습 전 | 300단계 후 | 상승폭(중간 90% 범위) |
|---|---|---|---|
| 마스크 적용 | 26% | 43% | +17 (+8~+26) |
| SFT 어댑터 | 35% | 60.5% | +25.5 (+17.5~+33.5) |
범위는 평가 질문 50개를 무작위로 1,000번 다시 뽑아 계산했다. 같은 질문이 여러 번 뽑힐 수 있고, 매번 질문당 답변 4개를 모두 포함했다. 전후 점수에는 같은 질문 표본을 사용했으며 가장 낮은 5%와 높은 5%를 제외해 중간 90% 범위를 구했다. 이는 짝지은 부트스트랩이다.
SFT 어댑터는 시작부터 9%포인트 높았고 강화학습에서 더 크게 개선됐다. SFT 데이터의 효과가 유지된 셈이다. 두 실험 모두 개선분 대부분은 약 125단계까지 얻었고 이후에는 대체로 정체했다. 단계별 유용성 비율은 다음과 같다.
| 단계 | 마스크 적용 | SFT 어댑터 |
|---|---|---|
| 0 | 26% (19~33%) | 35% (27~43.5%) |
| 25 | 28% (20.5~36%) | 43% (34~52.5%) |
| 50 | 34% (25.5~43%) | 53% (44.5~62%) |
| 75 | 39.5% (31~48.5%) | 55.5% (47~64.5%) |
| 100 | 44% (35.5~53%) | 51% (42~60%) |
| 125 | 44% (34~53%) | 58.5% (50~68%) |
| 150 | 35% (26.5~44%) | 60% (52~68%) |
| 175 | 38% (29~48%) | 56.5% (47.5~65.5%) |
| 200 | 39% (30~47%) | 60.5% (52~70%) |
| 225 | 36.5% (28~45%) | 61.5% (53~70%) |
| 250 | 40% (32~48%) | 61.5% (53.5~69.5%) |
| 275 | 40% (31.5~48%) | 59% (50~68%) |
| 300 | 43% (34.5~51.5%) | 60.5% (51~69.5%) |
강화학습 뒤에는 대체로 답변이 나아졌지만 지나치게 짧아진 경우도 있었다. 산타클로스 질문에는 “Santa Claus is a fictional man who brings gifts to kids during Christmas.”라고 답해 두 평가 항목 모두 5점을 받았다. 역을 운영하는 기관을 묻는 질문에는 “SNCF”, 야구와 비슷한 스포츠를 묻는 질문에는 “football”이라고 한 단어로 답했다. 두 답 모두 자연스러움 점수는 5점이었지만, “football”은 질문에 충분히 답하지 못했다. ‘cliché’의 어원을 묻는 질문에는 “It originally had no such connotation.”이라고 답해 자연스러움은 5점, 응답 여부는 1점이었다.
| 설정 | 답변 토큰 중앙값 | 평균 토큰 | 유용성 |
|---|---|---|---|
| 마스크 적용, 강화학습 전 | 52 | 92 | 26% |
| 마스크 적용, 300단계 후 | 18 | 42 | 43% |
| SFT 어댑터, 강화학습 전 | 53 | 70 | 35% |
| SFT 어댑터, 300단계 후 | 24 | 40 | 60.5% |
답이 짧아진 것만으로 개선을 설명할 수 있는지는 시작점에 따라 달랐다. 마스크 모델은 개선분이 거의 모두 자연스러움 점수에서 나왔고, 질문에 더 잘 답하는 점수는 오르지 않았다. 질문 일부를 건너뛰는 깔끔한 답은 200개 중 24개에서 66개로 늘었다. 보상은 두 점수를 더하기 때문에 자연스러움 5점·응답 3점과 각각 4점인 답이 같은 보상을 받을 수 있다. 하지만 유용성 기준은 두 항목 모두 4점 이상이어야 한다. 이 구조가 짧고 깔끔하지만 질문을 절반만 답하는 출력을 안전한 선택으로 만들었을 가능성이 있다.
반면 SFT 어댑터는 두 점수가 모두 올랐고, 답변 길이별 유용성 비율도 상승했다. 따라서 이 경우 개선이 단지 답이 짧아진 결과는 아니었다.
답변 길이를 줄이는 현상을 막기 위해 SFT 어댑터에서 각각 150단계씩 두 가지 실험을 했다. 하나는 두 점수 중 낮은 점수를 보상으로 써서 자연스러움 5점·응답 3점인 부분 답변이 4점·4점인 답변보다 낮은 보상을 받게 하는 방식이다. 다른 하나는 GRPO가 답변 손실을 답변 길이로 나누는 방식을 바꿔, 짧은 답변이 단어당 더 큰 학습 신호를 받지 않게 했다. 300토큰 한도로 나누는 방식으로 길이 편향을 없앴다.
두 방법 모두 유용성 비율을 높이지 못했고 답변이 짧아지는 현상도 멈추지 못했다. 150단계 후 중앙값은 각각 30토큰과 38토큰이었다. 기존 실험은 33토큰, 강화학습 전은 53토큰이었다. 마스크가 있는 상황에서는 단어를 더 쓸수록 어색한 단어를 강제로 선택할 위험이 커지므로, 짧은 답이 자연스럽게 높은 점수를 얻는다는 설명이다.
결과적으로 마스크 모델은 처음에 답변 4개 중 약 1개가 유용했다. ‘e’ 없는 답변 180개로 SFT를 하고 강화학습 300단계를 거친 뒤에는 약 10개 중 6개가 유용했다. SFT 어댑터의 개선은 답을 짧게 쓰는 데서만 나온 것은 아니지만, “football”처럼 일부 질문에만 답하는 경우는 남았다.
실험의 교훈과 한계
‘e’를 제거하는 일과 글을 잘 쓰는 일은 별개의 문제였다. 마스크는 학습 없이도 ‘e’를 없앴지만, 남은 단어로 자연스럽고 질문에 맞는 답을 쓰는 일이 어려웠다. 과제에 맞는 데이터는 양이 더 많은 부적절한 데이터보다 효과적이었다. 비슷한 규모의 ‘e’ 없는 소설보다 질문에 대한 답변 90개가 더 나은 결과를 냈다.
실험 과정에서는 목표를 일찍 정의하고, 일정한 단위의 작업 목표를 세우는 것이 도움이 됐다고 밝혔다. 손실과 보상은 숫자에 불과해 출력이 무너져도 정상처럼 보일 수 있으므로 실제 답변을 살펴야 했다. 로그를 남기고 생성 결과를 저장하면 학습이 유용한 방향으로 가는지 확인할 수 있다.
더 신중한 실험과 부분 답변에 유리하지 않은 보상 설계가 필요하다. 후속 계획으로는 강화학습의 수학적 기초와 일반적인 알고리즘을 공부하고, 언젠가 비디오 게임에 강화학습을 적용하는 일, 더 현대적인 모델·에이전트 후속 학습을 살펴보는 일을 들었다. 다음 LLM 강화학습 프로젝트에서는 기존 패키지와 API를 활용하고 더 큰 실험을 위해 연산 비용을 지불할 가능성이 있다고 밝혔다.
참고 자료로는 꽃을 그리도록 모델을 학습한 글, LLM으로 텍스트를 리포그램으로 바꾸는 논문, Llama-8B에서 ‘e’를 마스킹한 글을 제시했다.
구현과 재현 자료
프로젝트 코드·데이터·결과는 kevinyvv/qwen-3-1.7b-finetune-proj 저장소에 공개돼 있다. 저장소에는 순전파 구현, 첫 시도인 simple_train.py, SFTEngine, RLEngine(REINFORCE), GRPOEngine, 평가자 코드, SFT에 쓴 ‘e’ 없는 답변 데이터, 실행 기록, 실험 기록 전체가 있다.
어댑터 두 개는 Qwen3-1.7B 위에 peft로 불러올 수 있도록 Hugging Face에 공개됐다. 최종 어댑터는 SFT 뒤 강화학습을 거쳤고, SFT 전용 어댑터도 제공된다. 두 어댑터 모두 ‘e’ 없는 출력을 유지하려면 마스크가 필요하며, 모델 카드에는 마스크를 적용해 실행하는 코드가 포함돼 있다.
프로젝트의 대략적인 진행 순서는 범위 설정과 모델 선택, 순전파 작성과 최적화, ‘e’ 없는 출력을 위한 초기 시도와 마스크 실험, 목표와 데이터 정의, TRL의 Trainer 클래스를 직접 구현하는 실험, SFT, 자연스러움 개선을 위한 강화학습, 정리와 글 작성이었다. 메모리 관련 설명은 메모리 절, 엔진 클래스는 저장소 안내에 있다.
데이터는 No Robots와 Databricks-Dolly에서 가져왔다. 코드 작성 요청, 빈 예시, 중복 질문, 150단어가 넘는 질문, 사람 답변이 300단어를 넘는 예시를 제거했다. ‘운율을 맞춰 답하라’처럼 추가 제약을 주는 No Robots의 페르소나 기반 대화도 제외했다. 필터링과 분할 뒤 질문은 학습 18,000개, 검증 200개, 테스트 500개였다. 대부분의 질문은 실제 실험에 쓰이지 않았다.
‘벨기에의 수도는?’처럼 ‘Brussels’가 필요하거나 ‘모나리자를 그린 사람은?’처럼 ‘Leonardo’가 필요한 질문은 ‘e’ 없이 답할 수 없어 학습과 테스트에서 제외했다. 실험마다 분할 전체를 쓰는 대신 일부 질문을 뽑았다. 평가는 검증 분할의 질문 50개를 썼다. 강화학습 풀은 학습 분할에서 시작한 질문 2,000개를 하위 에이전트가 1,235개로 걸러 구성했다.
평가자의 공정성을 위해 ‘e’ 규칙은 알려주지 않았다. 어려운 과제라는 이유로 어색한 답을 좋게 평가하지 않게 하기 위해서다. 질문을 시도했다면 사실이 틀려도 불이익을 주지 않았다. 1.7B 모델은 사실을 틀리는 경우가 많고, 이 실험은 글쓰기만 평가하기 때문이다. ‘e’ 규칙 없이 Qwen 답변의 자연스러움과 응답 여부만 평가했을 때 통과율은 80.5%였다. 정상 답변이 대체로 통과하도록 목표를 80% 초과로 잡았고, 반복 문장이나 토큰 한도에 잘린 답변을 잡도록 평가자 지시문도 조정했다.
16GB 메모리에 맞춘 방법
학습 메모리는 모델 가중치, 기울기, 옵티마이저 상태, 저장된 활성값, 로짓 같은 임시 텐서에서 나온다. 모델 구조, 텐서 자료형, 학습 구현을 정하면 대략적인 메모리를 계산할 수 있다.
- 가중치: 매개변수 수 × 매개변수당 바이트
- 기울기: 학습 대상 매개변수 수 × 매개변수당 바이트
- 옵티마이저 상태: 학습 대상 매개변수 수 × 매개변수당 바이트 × 상태 수
- 활성값: 배치 × 시퀀스 길이 × 은닉 차원 × (텐서당 바이트) × (레이어당 텐서 수) × 레이어 수
- 로짓: 배치 × 시퀀스 길이 × 어휘 크기 × 로짓당 바이트
bf16 가중치, 배치 크기 4, 시퀀스 길이 2048, 어휘 크기 150k, FP32 상태 텐서를 쓰는 AdamW를 가정한 20억 매개변수 모델의 대략적인 계산은 다음과 같다.
| 항목 | 대략적인 메모리 |
|---|---|
| 모델 가중치: 2B 매개변수 × 2바이트 | 4GB |
| 기울기: 2B 매개변수 × 2바이트 | 4GB |
| AdamW 상태: 2B 매개변수 × 2개 상태 × 4바이트 | 16GB |
| 활성값: 4 × 2048 × 2048 × 2바이트 × 12 × 28 | 11.3GB |
| 로짓: 4 × 2048 × 150k × 2바이트 | 2.46GB |
| 합계 | 37.7GB |
여유분 1~2GB를 더하면 VRAM 약 40GB가 필요하다. 혼합 정밀도 학습은 FP32 가중치 복사본을 추가로 유지해 8GB가 더 들 수 있고, 손실 계산을 위해 로짓을 FP32로 올리면 해당 메모리도 두 배가 될 수 있다. 실험에서는 다음 최적화로 메모리를 줄였다.
- LoRA는 원래 가중치를 고정하고 작은 업데이트만 학습해 기울기와 옵티마이저 상태를 줄인다. 업데이트는 두 저랭크 행렬의 곱 ΔW = B·A로 표현하며 A와 B만 학습한다. 2048×2048 행렬은 약 420만 매개변수지만 순위 16인 A와 B의 매개변수는 2 × 2048 × 16, 약 6만5천 개로 64분의 1 수준이다. 전체 모델에서 LoRA가 학습하는 매개변수는 보통 약 1%, 여기서는 약 2천만 개이며 기울기와 옵티마이저 상태는 약 0.25GB다. LoRA 자체는 고정된 기본 가중치를 줄이지 않는다. QLoRA는 이를 4비트로 저장해 4GB에서 약 1GB로 낮춘다.
- 기울기 체크포인팅은 순전파의 중간 활성값을 모두 저장하는 대신 각 레이어 입력만 남기고 중간값을 버린다. 역전파 때 레이어의 순전파를 다시 실행해 값을 만든다. 이 계산에서는 28개 레이어 입력 약 0.9GB와 한 레이어의 중간값 약 0.4GB, 합계 약 1.3GB를 저장한다. 최적화 전 11.3GB보다 줄지만 순전파를 한 번 더 해 학습이 보통 20~30% 느려진다.
- Liger Kernel이나 Cut Cross-Entropy 같은 융합·분할 교차 엔트로피 커널은 손실을 청크 단위로 계산한다.
batch × seq_len × vocab_size전체 로짓 텐서를 한꺼번에 만들지 않고 일부만 메모리에 올려 로짓 메모리를 최대 수백 MB로 낮춘다.
이 최적화를 적용하면 CUDA 오버헤드를 포함해 필요한 메모리가 약 7~8GB로 줄어든다. 남은 메모리는 배치 크기나 시퀀스 길이를 늘리는 데 쓸 수 있다.
초기 강화학습 시도와 비교
처음에는 특정 질문에서 ‘e’가 없는 답변을 계산해 생성하도록 만들려 했다. 순전파를 구현하고 LoRA를 추가한 뒤 기본 가중치를 고정하고 어댑터만 학습했다. 사고 과정을 끄고 최대 64토큰을 생성하도록 설정했으며, 같은 질문을 8개 복사해 사용했다. 목표는 데이터셋이나 일반화를 고민하기 전에 하나의 예시부터 과적합시키는 것이었다.
처음에는 ‘e’ 없는 단어마다 1점을 줬다. 이 방식은 규칙을 어기는 답에도 유효한 단어가 일부 있으면 양의 보상을 줬다. 배치 안에서 보상을 중심화해 더 나은 답을 선호하게 하려 했지만, 샘플이 서로 비슷했다. 답변의 어느 부분이 문제인지 더 구체적으로 알려주기 위해 토큰별 보상표를 만들었다.
for tok, idx in tok_to_id.items():
 if 'e' in tok.lower() and tok != eos_token:
 e_table[idx] = -1.
 else:
 e_table[idx] = 0.5
토큰은 단어 전체가 아닐 수 있다. 예를 들어 gr + een으로 나뉘면 두 번째 토큰에만 벌점을 줘서는 단어를 만드는 데 영향을 준 앞선 선택을 반영하지 못한다. 그래서 뒤에 나온 벌점이 앞선 선택에도 영향을 주도록 미래 보상을 할인했다. 다음 코드는 반환값 계산과 정책 손실에서 발췌한 것이다.
# Inside discount(), working backwards through the response:
for t in reversed(range(rewards.size(1))):
 running = rewards[:, t] + gamma * running
 returns[:, t] = running

# Back in the training loop:
rewards = get_feedback(gen_ids, e_table)
per_token_reward = discount(rewards)
advantage = (per_token_reward - per_token_reward[mask].mean()) * mask
loss = -(log_probs * advantage).sum()
평균을 빼면 배치의 유효 토큰 반환값과 비교해 각 토큰의 이점이 정해진다. 양의 이점은 샘플링된 토큰의 확률을 높이고, 음의 이점은 낮춘다.
이 방법은 일부 작동했지만 “i want to know what you want to know”처럼 규칙은 지켜도 답이 되지 않는 문장이 나왔다. 또 “i m k t r n l d g h j z p q w x y f v b c …”처럼 무작위 글자를 나열해 보상을 얻는 출력도 있었다. ‘e’가 없는 토큰에 보상을 줬기 때문에 단어를 만들지 않아도 목표를 만족할 수 있었다. 보상 규칙을 바꿔도 의미가 있는지는 직접 평가하지 않았다.
원래 모델에서 벗어나는 정도에 KL 페널티를 주는 방법도 시도했다. LoRA를 끈 모델에 같은 생성열을 넣고 샘플링한 토큰의 로그 확률을 비교해 보상에서 조정했다.
kl_approx = (log_probs.detach() - ref_gen_log_probs) * mask
rewards = get_feedback(gen_ids, e_table) - kl_beta * kl_approx
원래 언어 능력을 버리지 않도록 하려는 의도였지만 출력은 계속 무너졌다. 나중에 KL 페널티가 다른 보상에 비해 너무 작았다는 점도 확인했다. 저장된 출력 중 하나는 “Tst, tkt, nkt, tkt, nkt, tkt.”였다. 보너스를 줄이거나 토큰 길이에 따라 조정하고, ‘e’ 벌점을 강화하거나 할인율을 바꿔도 일부 실행은 무의미한 답을, 다른 실행은 같은 문장 반복을 만들었다. 처음부터 벌점을 강화하면 한 글자나 줄바꿈만 출력하기도 했다. 실제 샘플을 살펴보는 일이 중요했고, 보상은 대응책을 두더라도 쉽게 악용될 수 있었다.
모델 크기도 비교했다. 평가에서 마스크 없이 자연스러움과 응답 여부만 판정했을 때 Qwen3-1.7B는 80.5%, Qwen3-4B는 87.5%였다. ‘e’를 쓰지 말라는 지시만 준 경우 두 모델 모두 0%였다. 마스크를 적용하면 1.7B는 26%, 4B는 12.5%였다. 4B 모델은 계획한 단어를 그대로 쓰면서 ‘e’만 빼는 경향이 있어 “the”를 “th”로, 다른 단어를 “amusrmt park”처럼 만들었다. 1.7B 모델은 다른 단어로 바꾸는 경우가 더 많았다. 비교는 한 모델 계열의 두 크기, 그리고 로컬에서 실행할 수 있었던 모델에 한정된다. 더 새로운 모델이나 영어 텍스트로 더 많이 학습한 모델은 더 나을 수 있다.
제공 모델과 추가 자료
전체 평가 답변은 원문 글에서 단계별로 확인할 수 있다. 점 하나가 답변 하나이며 평가 질문 50개에 답변 4개씩 총 200개다. ‘e’가 없고 평가자가 자연스러움과 응답 여부 모두 4점 이상을 줘야 유용한 답으로 표시된다. 부록에는 실험 과정, 메모리 계산, 초기 강화학습 시도, 저장소 안내가 있다.
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요