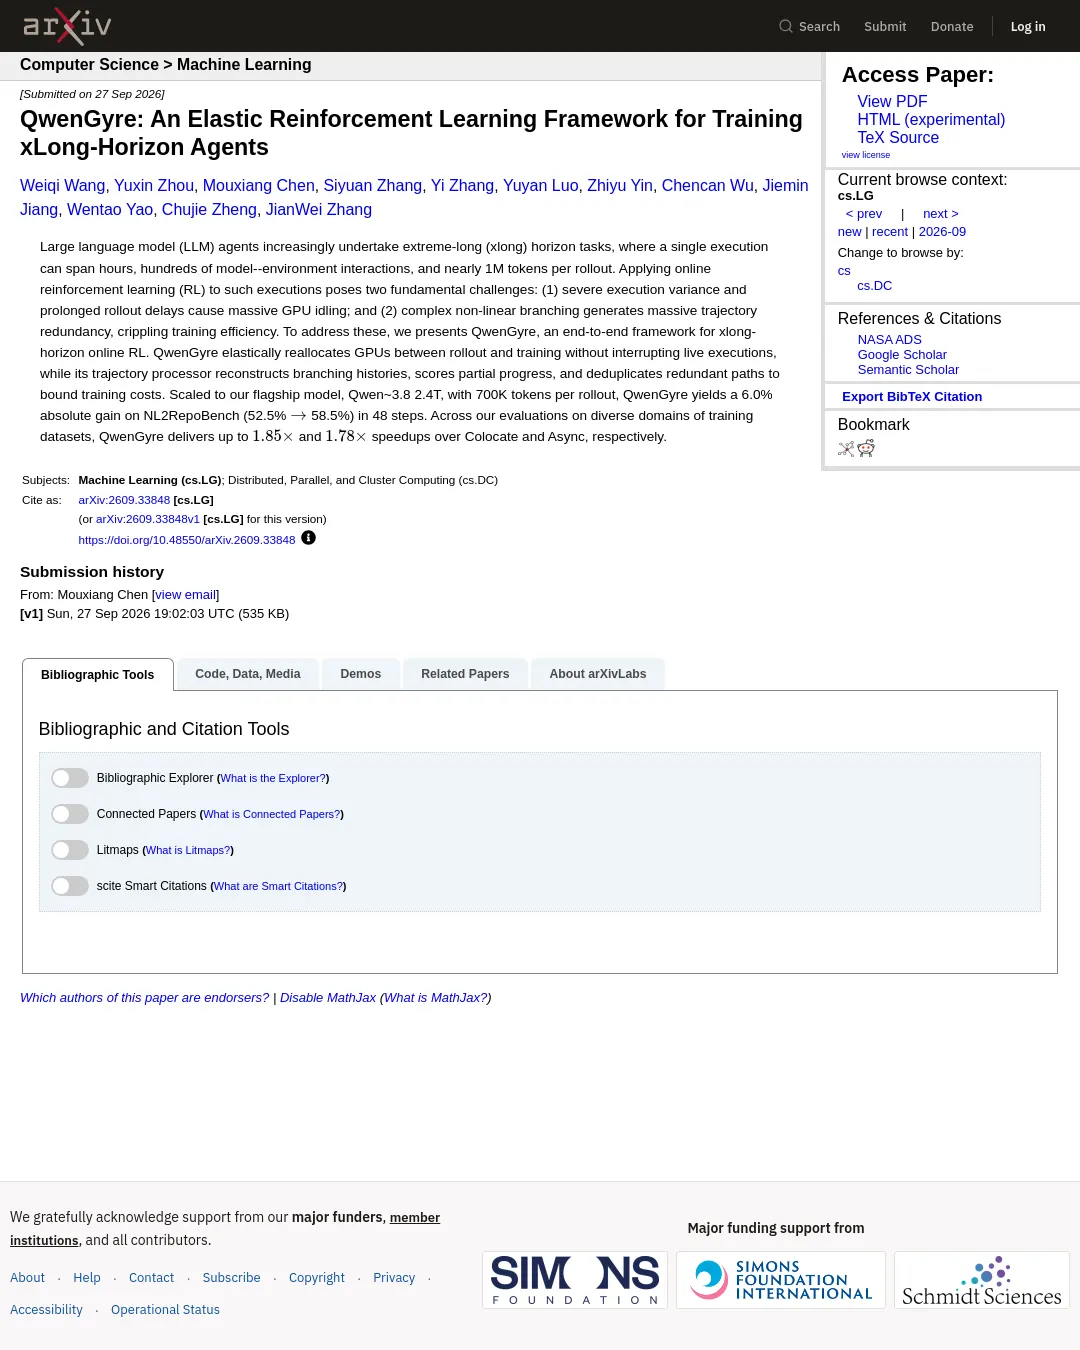
QwenGyre로 학습한 모델은 NL2RepoBench에서 48단계 만에 점수가 52.5%에서 58.5%로 올랐다. 롤아웃당 70만 토큰을 처리한 조건이다.
연구진은 장시간 작업을 하는 에이전트를 위한 온라인 강화학습 프레임워크 QwenGyre를 공개했다. 논문에 따르면 대표 모델 Qwen 3.8 2.4T를 사용한 평가에서 기존 방식보다 학습 속도를 높였고, 코드를 다루는 벤치마크 점수도 개선했다.
QwenGyre는 무엇을 바꾸나?
온라인 강화학습은 모델이 환경과 상호작용하며 얻은 결과를 바탕으로 학습하는 방식이다. QwenGyre는 이를 장시간 이어지는 작업에 맞췄다. 여러 작업자를 교대로 쓰는 것처럼, 진행 중인 실행을 멈추지 않고 GPU를 실행과 학습 사이에 탄력적으로 재배분한다.
연구진이 다룬 작업은 한 번의 실행이 수 시간 이어지고, 환경과 수백 차례 상호작용하며, 한 차례 실행 기록(롤아웃)에 거의 100만 토큰이 들어갈 수 있다. 실행 시간이 들쭉날쭉하면 GPU가 놀게 되고, 여러 갈래로 분기하는 작업에서는 중복 경로가 늘어 학습 효율이 떨어진다.
성능 수치는 어떤 조건에서 나왔나?
QwenGyre는 실행과 학습에 GPU를 재배분하는 한편, 분기된 이력을 재구성하고 진행 중인 작업의 부분 점수를 매긴다. 중복 경로도 제거해 학습 비용을 제한한다.
연구진의 평가에서 QwenGyre는 다양한 학습 데이터 영역에 걸쳐 Colocate 방식보다 최대 1.85배, Async 방식보다 최대 1.78배 빠른 속도를 냈다. Qwen 3.8 2.4T를 롤아웃당 70만 토큰으로 학습했을 때 NL2RepoBench 점수는 48단계 동안 52.5%에서 58.5%로 상승했다. 이는 6.0%포인트의 절대 향상이다.
이 결과는 논문 초록에 제시된 연구진의 평가다. 다른 환경이나 작업에서도 같은 속도 향상과 점수 개선이 재현되는지는 초록만으로 판단하기 어렵다. 써 보려면 논문에서 평가 데이터와 비교 설정, 구현 조건을 확인해야 한다. 초록은 GPU 수와 실험별 세부 조건, 코드 공개 여부를 밝히지 않는다. 논문 초록과 서지 정보
댓글 (0)
로그인하면 이 기사에 내 생각을 남길 수 있어요